Benchmark des interfaces agentiques
Un modèle. Quatre interfaces.
5 tâches · 20 exécutions neuves · 12/12 contrôles qualité
Quatre agents IA testés : tokens, temps et qualité
Le benchmark en bref
20 réponses · 12/12 contrôles qualité réussis
- 96.49Codex App
- Tokens
- 4.09M
- Temps
- 30.98 min
- Appels
- 66
- Lecture
- Meilleur équilibre
- 95.77Codex CLI
- Tokens
- 4.09M
- Temps
- 30.86 min
- Appels
- 62
- Lecture
- Exécution la plus rapide
- Pi95.75
- Tokens
- 3.37M
- Temps
- 37.48 min
- Appels
- 170
- Lecture
- Moins de tokens
- 93.65OpenCode
- Tokens
- 4.20M
- Temps
- 36.13 min
- Appels
- 186
- Lecture
- Alternative flexible
Quatre lectures des mêmes exécutions
Score global pondéré
Échelle ciblée 90–100 · plus élevé est meilleur
Tokens traités
Millions de tokens · moins est meilleur
Durée totale
Minutes · moins est meilleur
Appels d’outils
Appels sur cinq tâches · moins est meilleur
Dans l’architecture, l’IA ne se limite plus à la génération d’images. Elle intervient dans l’analyse des programmes, des règlements de construction et des sites, dans les études d’implantation ainsi que dans les tâches récurrentes de validation ou de documentation. Le RIBA AI Report 2025 décrit ces usages entre préconception, conception et contrôle. Parallèlement, une étude de l’AIA publiée en 2025 indique que seuls 8 % des cabinets interrogés avaient formellement mis en œuvre l’IA, tandis que 20 % supplémentaires y travaillaient.
Dans cette phase de transition, on parle beaucoup du modèle et trop peu de l’interface qui le dirige réellement. Deux agents peuvent utiliser le même modèle tout en traitant des volumes de contexte différents, en appelant un nombre différent d’outils et en terminant à des vitesses différentes. Pour une agence d’architecture qui emploie l’IA dans l’analyse d’appels d’offres, la recherche de planification, l’automatisation proche du BIM ou le contrôle qualité interne, cette différence est opérationnelle. Elle influence le coût et la vitesse, mais aussi la traçabilité, l’automatisation et le niveau de supervision humaine.
J’ai donc comparé quatre interfaces agentiques dans les mêmes conditions : Codex App, Codex CLI, Pi et OpenCode.
Ce que le test mesure réellement
Il ne s’agissait pas d’une comparaison entre différents modèles locaux. Le même modèle gpt-5.6-luna, avec l’effort de raisonnement maximal, a été utilisé dans 20 sessions neuves. Le benchmark isole la couche agentique qui l’entoure : gestion du contexte, usage des outils, durée et capacité à produire une réponse défendable à partir d’un dépôt réel.
Les cinq tâches provenaient de cinq dépôts différents et portaient sur des investigations exigeantes en lecture seule : état de publication, workflows d’approbation, garde-fous de preuve pour un inventaire 3D, cohérence de sorties CAD/DXF et livraison concurrente de notifications. Chaque tâche a été exécutée sur les quatre interfaces avec le même prompt. Après normalisation des fins de ligne et des espaces finaux, les quatre copies du prompt de chaque tâche produisaient le même hash SHA-256.
Chaque réponse a ensuite été contrôlée par rapport au code source actuel. La grille évaluait la trace comportementale, l’exactitude des risques, les preuves ou tests et le respect du contrat de réponse. Les 20 réponses finales ont obtenu 12 sur 12. Cela ne prouve pas que les agents sont généralement d’intelligence égale ; cela indique que ces cinq tâches de recherche ont atteint le plafond qualitatif du test.
Résultats globaux
Le score pondéré attribuait 60 points à la qualité, 15 au volume de tokens traités, 15 à la durée et 10 à la fiabilité.
- Codex App : 96,49/100 · 4 093 797 tokens traités · 494 181 tokens hors cache · 30,98 minutes · 66 appels d’outils
- Codex CLI : 95,77/100 · 4 088 140 tokens traités · 492 620 tokens hors cache · 30,86 minutes · 62 appels d’outils
- Pi : 95,75/100 · 3 370 229 tokens traités · 545 013 tokens hors cache · 37,48 minutes · 170 appels d’outils
- OpenCode : 93,65/100 · 4 198 888 tokens traités · 633 320 tokens hors cache · 36,13 minutes · 186 appels d’outils
Le classement est plus serré qu’il n’y paraît. Codex App remporte le score pondéré ; Codex CLI n’est que 6,85 secondes plus rapide au total. Pi termine à seulement 0,02 point de la CLI, avec un profil de ressources nettement différent. OpenCode fournit la même qualité mesurée, sans toutefois dominer cet échantillon en tokens, en durée ou en nombre d’appels d’outils.
La question Pi : utilise-t-il vraiment moins de tokens ?
Pi est l’approche la plus récente et la plus volontairement minimaliste de ce comparatif. La documentation officielle de Pi décrit un environnement terminal réduit et extensible ; sa documentation sur la compaction explique comment résumer l’ancien contexte et limiter les sorties d’outils volumineuses. Cette conception alimente l’idée, dans la communauté, que Pi est particulièrement sobre. Les témoignages ne constituent toutefois pas une mesure contrôlée.
Nos cinq tâches donnent une réponse plus précise. Pi affiche le volume total de tokens traités le plus faible, avec 3,37 millions : 17,7 % de moins que Codex App, 17,6 % de moins que Codex CLI et 19,7 % de moins qu’OpenCode. L’hypothèse d’un traitement global du contexte plus léger est donc confirmée dans ce benchmark.
Mais uniquement pour cette métrique. Codex CLI et Codex App utilisent moins de tokens hors cache. Pi demande aussi environ 21 % de temps supplémentaire par rapport à la CLI et presque 2,7 fois plus d’appels d’outils. Dire « moins de tokens » reste donc incomplet sans préciser si l’on cherche à réduire le volume global de contexte, le contenu nouvellement traité, le coût API réel ou le temps d’attente humain.
Le mot « token » doit lui-même être interprété avec prudence. Les quatre formats d’export n’exposaient pas exactement les mêmes champs. La mesure commune a donc été normalisée comme charge de travail : entrée, activité de cache, sortie et, lorsqu’il était séparé, raisonnement. Ce n’est ni un montant de facture direct, ni une mesure de quota d’abonnement.
Quelle interface pour quel workflow d’architecture ?
Codex App constitue le meilleur choix par défaut pour une investigation interactive. Lorsque plans, captures d’écran, rapports et résultats intermédiaires doivent être examinés ensemble avec des interventions humaines régulières, l’application offre le meilleur équilibre entre visibilité, vitesse et transmission du résultat.
Codex CLI convient aux processus répétables : audits standardisés de dépôts, génération automatisée de documentation, contrôles proches de la CI ou portes qualité clairement définies. C’est l’interface la plus rapide du test et celle qui a utilisé le moins d’appels d’outils.
Pi est pertinent lorsqu’une couche agentique légère et adaptable, ou le volume global du contexte, est prioritaire. Cela peut compter pour des piles expérimentales de modèles locaux, des fenêtres de contexte limitées ou des chaînes d’outils personnalisées. Ce benchmark n’utilisait toutefois aucun modèle local et ne permet donc pas de conclure sur le comportement de Pi avec une inférence locale.
OpenCode reste utile pour la flexibilité des fournisseurs et comme seconde interface indépendante. Il a passé tous les contrôles de qualité, sans montrer d’avantage général d’efficacité sur ces cinq tâches.
La bonne question n’est donc pas « Quel agent est le meilleur ? », mais « Quelle friction ce workflow doit-il minimiser ? » Pour une vérification visuelle ponctuelle d’un projet, l’interactivité peut dominer. Pour des contrôles nocturnes de code, de normes ou de documentation, la reproductibilité et la durée deviennent prioritaires. Pour l’expérimentation locale, le budget de contexte et l’extensibilité peuvent compter davantage que la vitesse brute.
Limites et prochain benchmark
Les cinq tâches étaient réelles et exigeantes, mais en lecture seule. Le benchmark mesure donc la qualité de recherche et l’efficacité opérationnelle, et non la justesse de modifications de code. Il reste à tester un correctif ciblé accompagné de tests, une petite fonctionnalité multi-fichiers, la réparation d’un test volontairement cassé, un workflow navigateur avec relecture persistante et la reprise sûre d’une session interrompue.
Ces tâches constituent la deuxième phase logique. C’est seulement alors que nous saurons si les résultats qualitatifs presque identiques d’aujourd’hui se maintiennent lorsqu’un agent modifie réellement un système et devient responsable des régressions.
Ma conclusion actuelle est pragmatique : Codex App comme choix interactif par défaut, Codex CLI pour l’automatisation, Pi pour les expérimentations orientées tokens et harness, et OpenCode pour la flexibilité ou une seconde opinion. Pi a bien confirmé l’attente d’un volume total de tokens traités plus faible, mais ce gain n’est pas gratuit : il s’accompagne d’une durée plus longue et d’un nombre nettement supérieur d’étapes d’outils.
D'autres articles
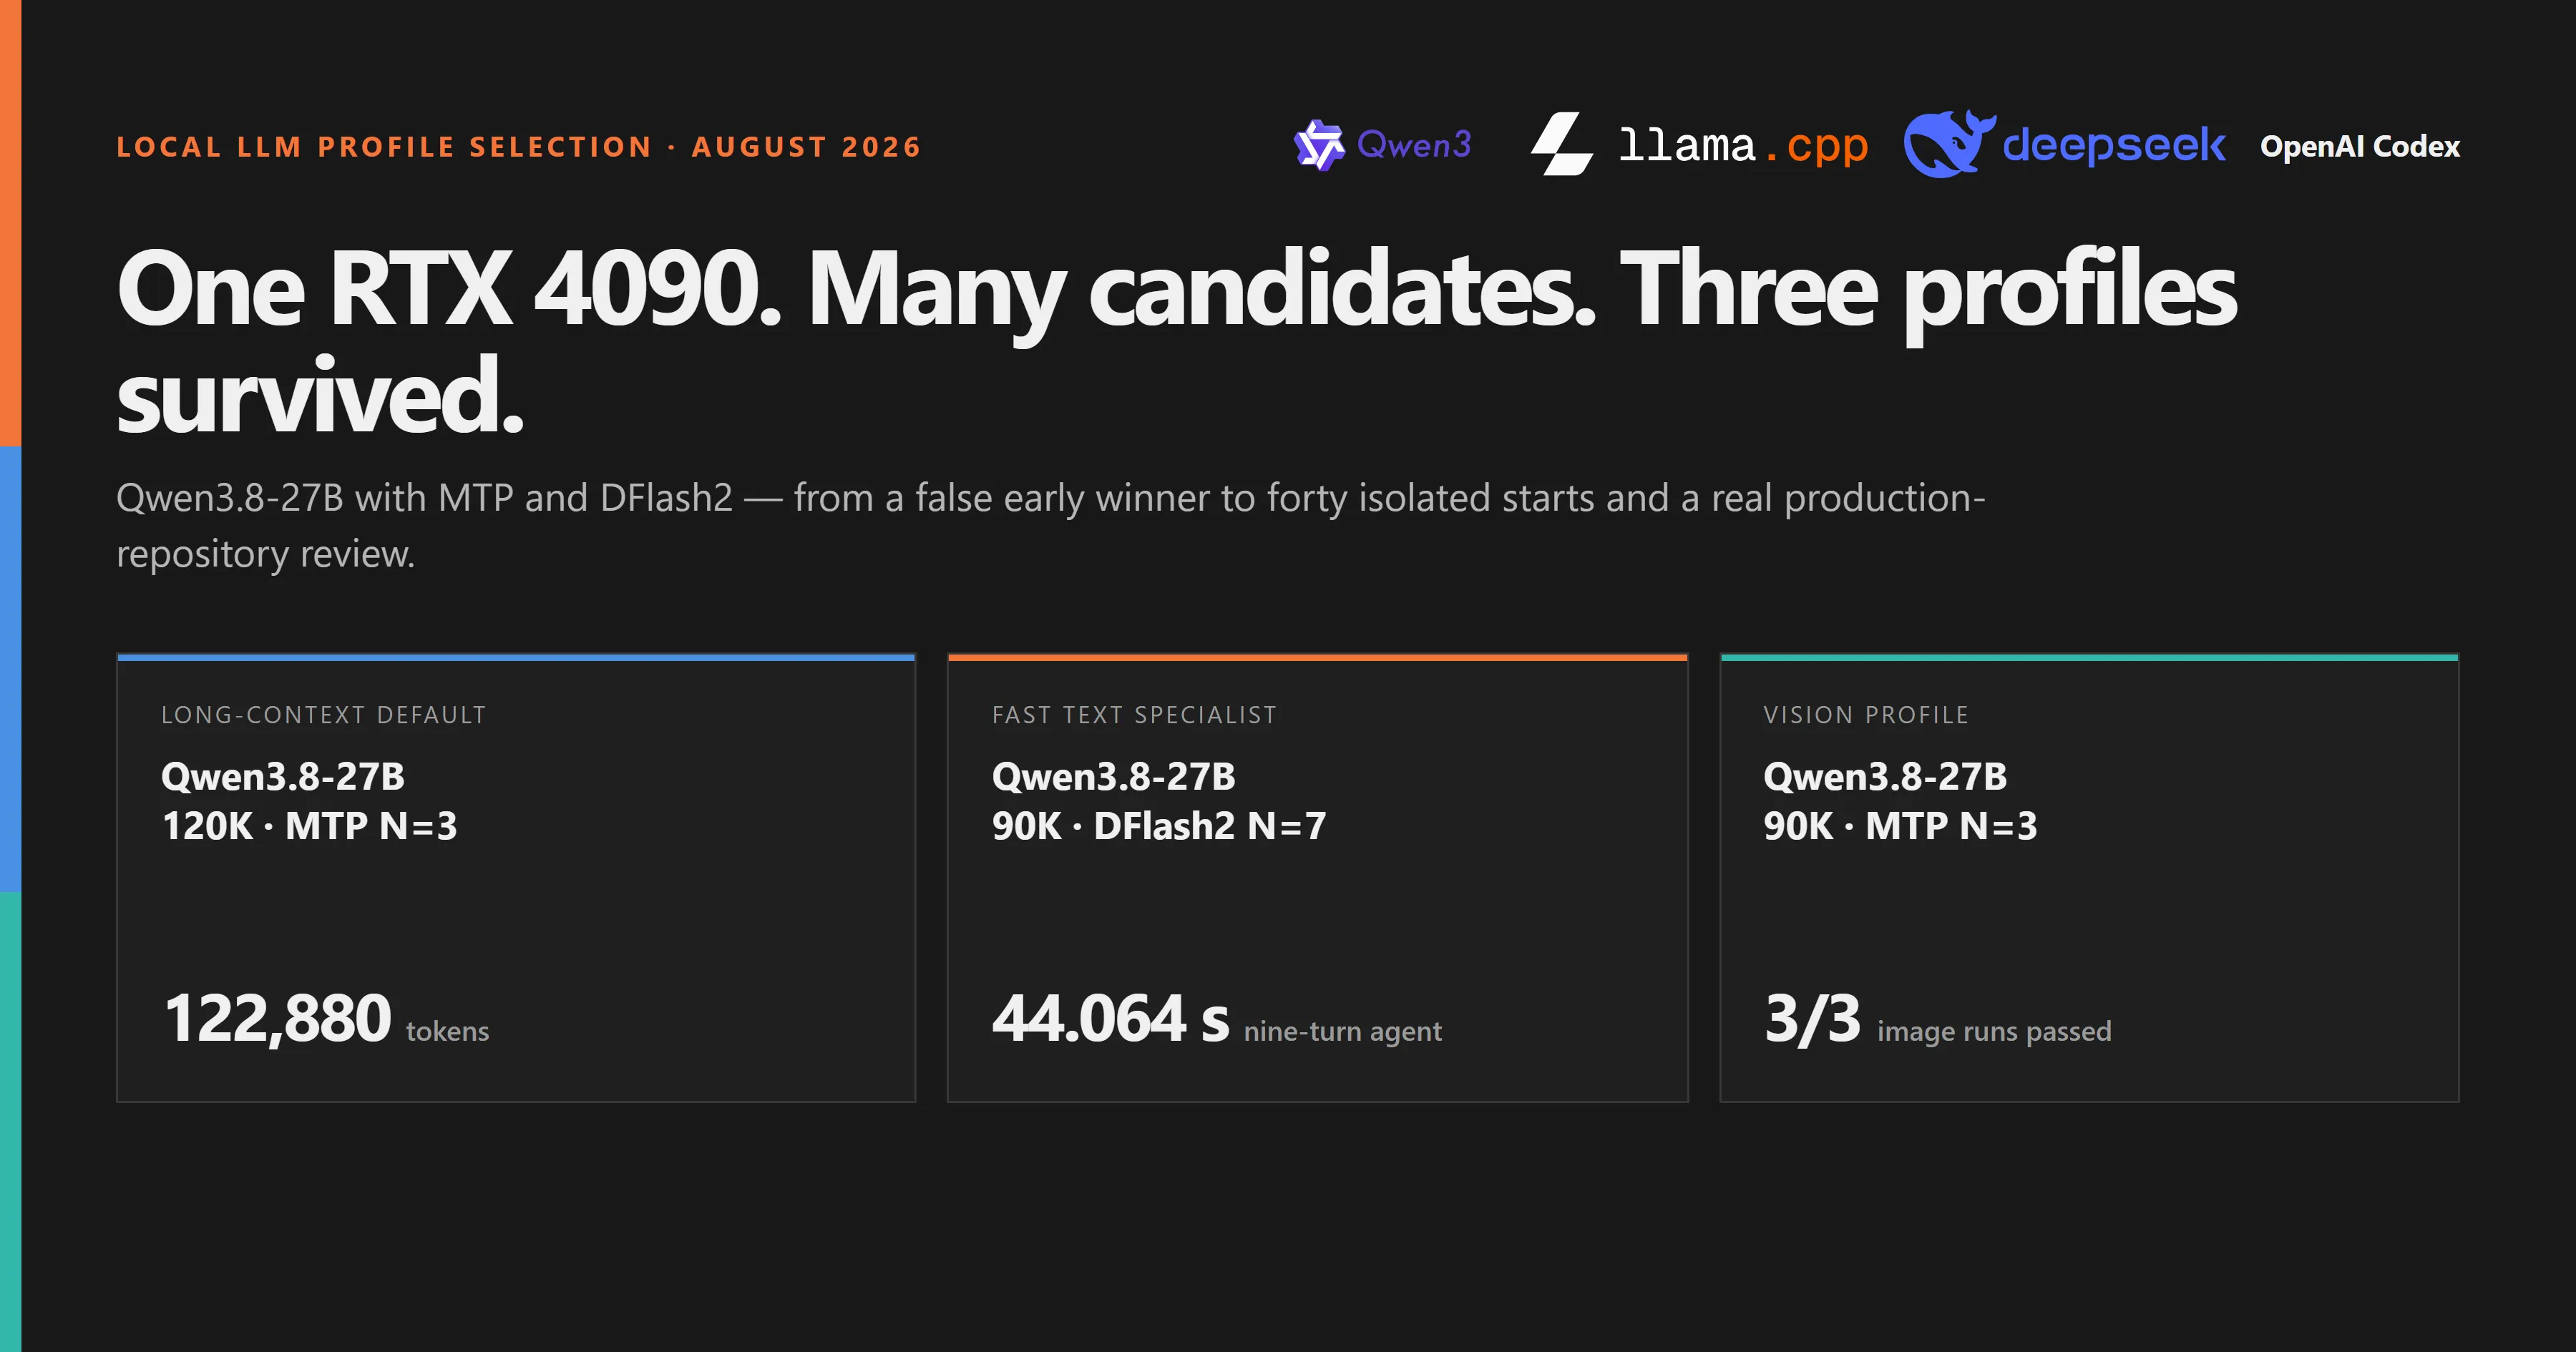
De nombreux candidats à trois profils : Qwen3.8-27B avec MTP et DFlash2
Sur une RTX 4090, les profils MTP et DFlash2 ont été éliminés étape par étape. Le résultat n'est pas un vainqueur universel, mais un profil MTP 120K par défaut, un spécialiste texte DFlash2 90K et un profil vision MTP 90K vérifié.
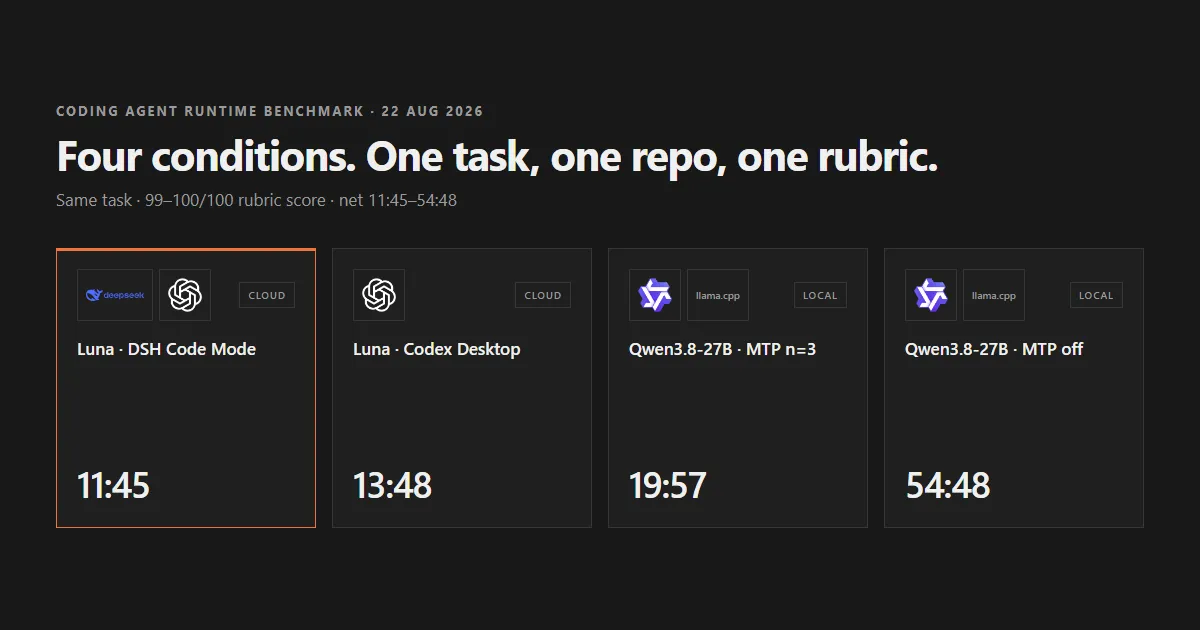
Quatre conditions, une tâche : ce que coûtent vraiment le décodage spéculatif et le choix de l'outil d'agent
Quatre conditions ont résolu la même tâche dans le même dépôt et ont toutes obtenu 99 ou 100 points sur 100. La durée nette de la tâche — temps d'attente d'approbation et de compactage automatique du contexte exclus de chaque mesure — allait de 11:45 pour l'exécution cloud via le mode standard de DSH à 54:48 pour le modèle local sans décodage spéculatif.
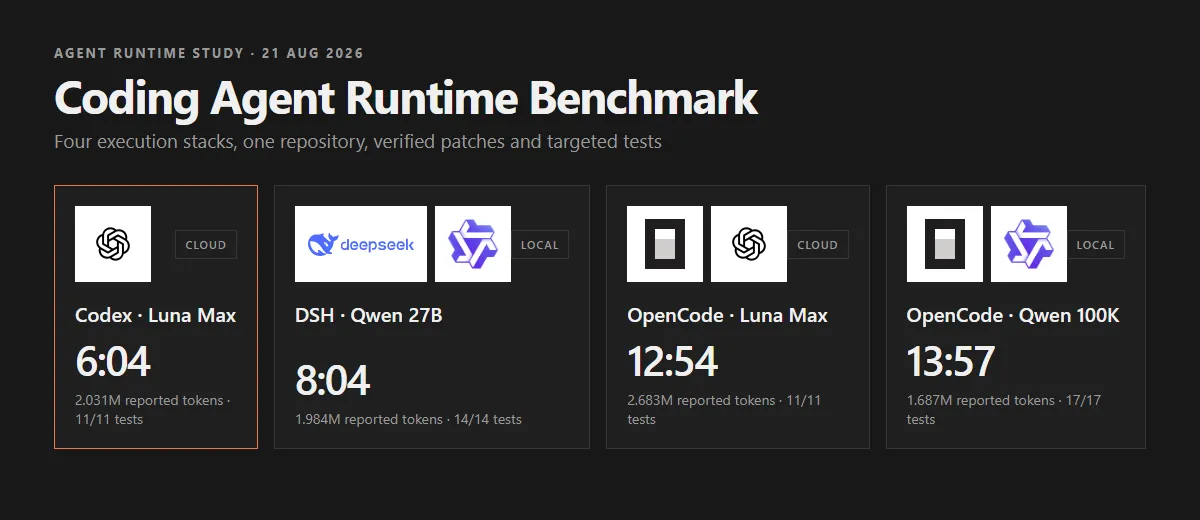
Benchmark d’agents de code : l’impact de la couche d’exécution
Quatre agents ont modifié le même dépôt et réussi leurs tests ciblés. La durée variait pourtant de 6:04 à 13:57, car modèle, harness, cache et revue agissaient ensemble.