AI-Agent-Interface-Benchmark
Ein Modell. Vier Interfaces.
5 Aufgaben · 20 frische Läufe · 12/12 Qualitätsprüfungen
Vier KI-Agenten im Praxistest: Token, Zeit und Qualität
Benchmark auf einen Blick
20 Antworten · 12/12 Qualitätsprüfungen bestanden
- 96.49Codex App
- Tokens
- 4.09M
- Zeit
- 30.98 min
- Calls
- 66
- Einordnung
- Beste Balance
- 95.77Codex CLI
- Tokens
- 4.09M
- Zeit
- 30.86 min
- Calls
- 62
- Einordnung
- Schnellste Ausführung
- Pi95.75
- Tokens
- 3.37M
- Zeit
- 37.48 min
- Calls
- 170
- Einordnung
- Wenigste Tokens
- 93.65OpenCode
- Tokens
- 4.20M
- Zeit
- 36.13 min
- Calls
- 186
- Einordnung
- Flexible Alternative
Vier Perspektiven auf dieselben Läufe
Gewichteter Gesamtscore
Fokussierte Skala 90–100 · höher ist besser
Verarbeitete Tokens
Millionen Tokens · weniger ist besser
Gesamtdauer
Minuten · weniger ist besser
Tool-Aufrufe
Aufrufe über fünf Aufgaben · weniger ist besser
KI in der Architektur bedeutet längst mehr als Bilderzeugung. Sie taucht bei der Analyse von Briefings, Bauvorschriften und Standorten auf, unterstützt Layoutstudien und hilft bei wiederkehrenden Prüf- und Dokumentationsaufgaben. Der RIBA AI Report 2025 nennt genau solche Anwendungen in Vorplanung, Entwurf und Validierung. Gleichzeitig zeigt eine AIA-Erhebung von 2025, dass erst 8 Prozent der befragten Büros KI formell implementiert hatten, während weitere 20 Prozent daran arbeiteten.
In dieser Übergangsphase wird oft über das Modell gesprochen, aber selten über die Oberfläche, die das Modell tatsächlich steuert. Zwei Agenten können dasselbe Modell verwenden und trotzdem unterschiedliche Mengen Kontext verarbeiten, verschieden viele Werkzeuge aufrufen und unterschiedlich lange brauchen. Für ein Architekturbüro, das KI etwa für Ausschreibungsprüfung, Planungsrecherche, BIM-nahe Automatisierung oder interne Qualitätssicherung einsetzt, ist dieser Unterschied operativ relevant. Er beeinflusst nicht nur Kosten und Geschwindigkeit, sondern auch Nachvollziehbarkeit, Automatisierbarkeit und den Aufwand menschlicher Kontrolle.
Deshalb habe ich vier Agenten-Oberflächen unter denselben Bedingungen verglichen: Codex App, Codex CLI, Pi und OpenCode.
Was dieser Test wirklich misst
Dies war kein Vergleich verschiedener lokaler Modelle. In allen 20 frischen Sitzungen lief dasselbe Modell, gpt-5.6-luna mit maximalem Reasoning-Aufwand. Gemessen wurde die Agentenschicht darum herum: Kontextverwaltung, Werkzeugnutzung, Laufzeit und die Fähigkeit, eine belastbare Antwort aus einem realen Repository abzuleiten.
Die fünf Aufgaben stammten aus fünf unterschiedlichen Repositories und deckten anspruchsvolle, schreibgeschützte Untersuchungen ab: Publishing-Zustände, Approval-Workflows, 3D-Inventar- und Evidenzprüfungen, CAD/DXF-Ausgabekonsistenz sowie nebenläufige Benachrichtigungszustellung. Jede Aufgabe wurde auf allen vier Oberflächen mit demselben Prompt ausgeführt. Nach Normalisierung von Zeilenenden und Leerzeichen hatten die vier Prompt-Kopien pro Aufgabe denselben SHA-256-Wert.
Die Qualität wurde danach gegen den aktuellen Quellcode geprüft. Bewertet wurden Verhaltensspur, Risikogenauigkeit, Belege beziehungsweise Tests und die Einhaltung des Antwortvertrags. Jede der 20 finalen Antworten erreichte 12 von 12 Punkten. Das bedeutet nicht, dass alle Agenten generell gleich intelligent sind; es bedeutet, dass diese fünf Rechercheaufgaben die Qualitätsauflösung des Tests ausgeschöpft haben.
Das Gesamtergebnis
Der gewichtete Score bestand aus 60 Punkten Qualität, 15 Punkten verarbeitetem Tokenvolumen, 15 Punkten Laufzeit und 10 Punkten Zuverlässigkeit.
- Codex App: 96,49/100 · 4.093.797 verarbeitete Token · 494.181 nicht gecachte Token · 30,98 Minuten · 66 Werkzeugaufrufe
- Codex CLI: 95,77/100 · 4.088.140 verarbeitete Token · 492.620 nicht gecachte Token · 30,86 Minuten · 62 Werkzeugaufrufe
- Pi: 95,75/100 · 3.370.229 verarbeitete Token · 545.013 nicht gecachte Token · 37,48 Minuten · 170 Werkzeugaufrufe
- OpenCode: 93,65/100 · 4.198.888 verarbeitete Token · 633.320 nicht gecachte Token · 36,13 Minuten · 186 Werkzeugaufrufe
Die Rangfolge ist enger, als sie auf den ersten Blick wirkt. Codex App gewann den gewichteten Gesamtscore; Codex CLI war insgesamt 6,85 Sekunden schneller. Pi lag beim Score nur 0,02 Punkte hinter der CLI, arbeitete aber mit einem deutlich anderen Ressourcenprofil. OpenCode lieferte dieselbe gemessene Antwortqualität, war in diesem Set jedoch weder beim Tokenvolumen noch bei Laufzeit oder Werkzeugzahl führend.
Die Pi-Frage: wirklich weniger Token?
Pi ist in diesem Vergleich der jüngste und bewusst minimalistische Agenten-Ansatz. Die offizielle Pi-Dokumentation beschreibt eine kleine, erweiterbare Terminalumgebung; die Dokumentation zur Kontextkomprimierung erklärt, wie ältere Gesprächsteile zusammengefasst und umfangreiche Werkzeugausgaben begrenzt werden können. In der Community wird Pi deshalb häufig als besonders schlank wahrgenommen. Solche Erfahrungsberichte sind jedoch keine kontrollierte Messung.
Unsere fünf Aufgaben liefern ein differenzierteres Bild. Pi hatte mit 3,37 Millionen das niedrigste gesamte verarbeitete Tokenvolumen: 17,7 Prozent weniger als Codex App, 17,6 Prozent weniger als Codex CLI und 19,7 Prozent weniger als OpenCode. Die verbreitete Vermutung einer schlankeren Kontextverarbeitung wurde in diesem Test also tatsächlich bestätigt.
Aber nur für diese Metrik. Bei den nicht gecachten Token lagen Codex CLI und Codex App niedriger. Pi benötigte außerdem rund 21 Prozent mehr Zeit als die CLI und fast 2,7-mal so viele Werkzeugaufrufe. „Weniger Token“ ist deshalb keine vollständige Aussage. Entscheidend ist, ob man gesamtes Kontextvolumen, neu verarbeitete Inhalte, reale API-Kosten oder menschliche Wartezeit optimieren möchte.
Auch die Bezeichnung „Token“ verlangt Vorsicht. Die vier Exportformate stellten nicht exakt dieselben Felder bereit. Der gemeinsame Wert wurde deshalb als normalisierte Arbeitslast berechnet: Input, Cache-Nutzung, Output und – wo separat ausgewiesen – Reasoning. Er ist kein direkter Rechnungsbetrag und keine Aussage über ein Abonnementslimit.
Welche Oberfläche passt zu welcher Architekturarbeit?
Codex App ist für interaktive Untersuchungen der stärkste Standard. Wenn Pläne, Screenshots, Berichte und Zwischenergebnisse gemeinsam geprüft werden und ein Mensch regelmäßig eingreift, bietet die App die beste Balance aus Transparenz, Geschwindigkeit und Ergebnisübergabe.
Codex CLI passt zu wiederholbaren Abläufen: standardisierte Repository-Prüfungen, automatische Dokumentationsläufe, CI-nahe Kontrollen oder klar definierte Qualitätsgates. Sie war in diesem Test am schnellsten und kam mit den wenigsten Werkzeugaufrufen aus.
Pi ist interessant, wenn eine schlanke, anpassbare Agentenschicht oder das gesamte Kontextvolumen im Vordergrund steht. Das kann bei experimentellen lokalen Modellstacks, begrenzten Kontextfenstern oder individuell aufgebauten Werkzeugketten wichtig sein. Unser Test verwendete jedoch kein lokales Modell und beweist daher nicht, wie sich Pi mit lokaler Inferenz verhält.
OpenCode bleibt wertvoll für Provider-Flexibilität und als unabhängige zweite Oberfläche. Es bestand alle Qualitätsprüfungen, zeigte in diesen fünf Aufgaben aber keinen allgemeinen Effizienzvorteil.
Die wichtigste Konsequenz lautet deshalb nicht „Welcher Agent ist der beste?“, sondern „Welche Reibung soll im konkreten Arbeitsablauf minimiert werden?“ Für eine einmalige, visuelle Planungsprüfung ist Interaktivität entscheidend. Für nächtliche Regelwerks- oder Dokumentationskontrollen zählen Reproduzierbarkeit und Laufzeit. Für lokale Experimente können Kontextbudget und Erweiterbarkeit wichtiger sein als die reine Geschwindigkeit.
Grenzen und nächster Test
Die fünf Aufgaben waren reale, anspruchsvolle Repository-Untersuchungen, aber schreibgeschützt. Der Benchmark misst daher Recherchequalität und Betriebseffizienz, nicht die Korrektheit echter Codeänderungen. Noch offen sind Bugfixes mit Tests, kleine Mehrdatei-Features, die Reparatur absichtlich gebrochener Tests, Browser-Workflows mit dauerhaftem Readback und die sichere Fortsetzung unterbrochener Sitzungen.
Genau diese Aufgaben bilden die sinnvolle zweite Phase. Erst dann lässt sich beurteilen, ob die heute sehr ähnlichen Qualitätswerte auch dann bestehen bleiben, wenn ein Agent tatsächlich in ein System eingreift und für Regressionen verantwortlich wird.
Mein aktuelles Fazit ist pragmatisch: Codex App als interaktiver Standard, Codex CLI für Automatisierung, Pi für token- und harness-orientierte Experimente und OpenCode für Flexibilität oder eine zweite Meinung. Pi hat die Erwartung eines niedrigeren gesamten Tokenvolumens erfüllt – aber nicht kostenlos. Der Vorteil kam mit längerer Laufzeit und deutlich mehr Werkzeugschritten.
Weitere Beiträge
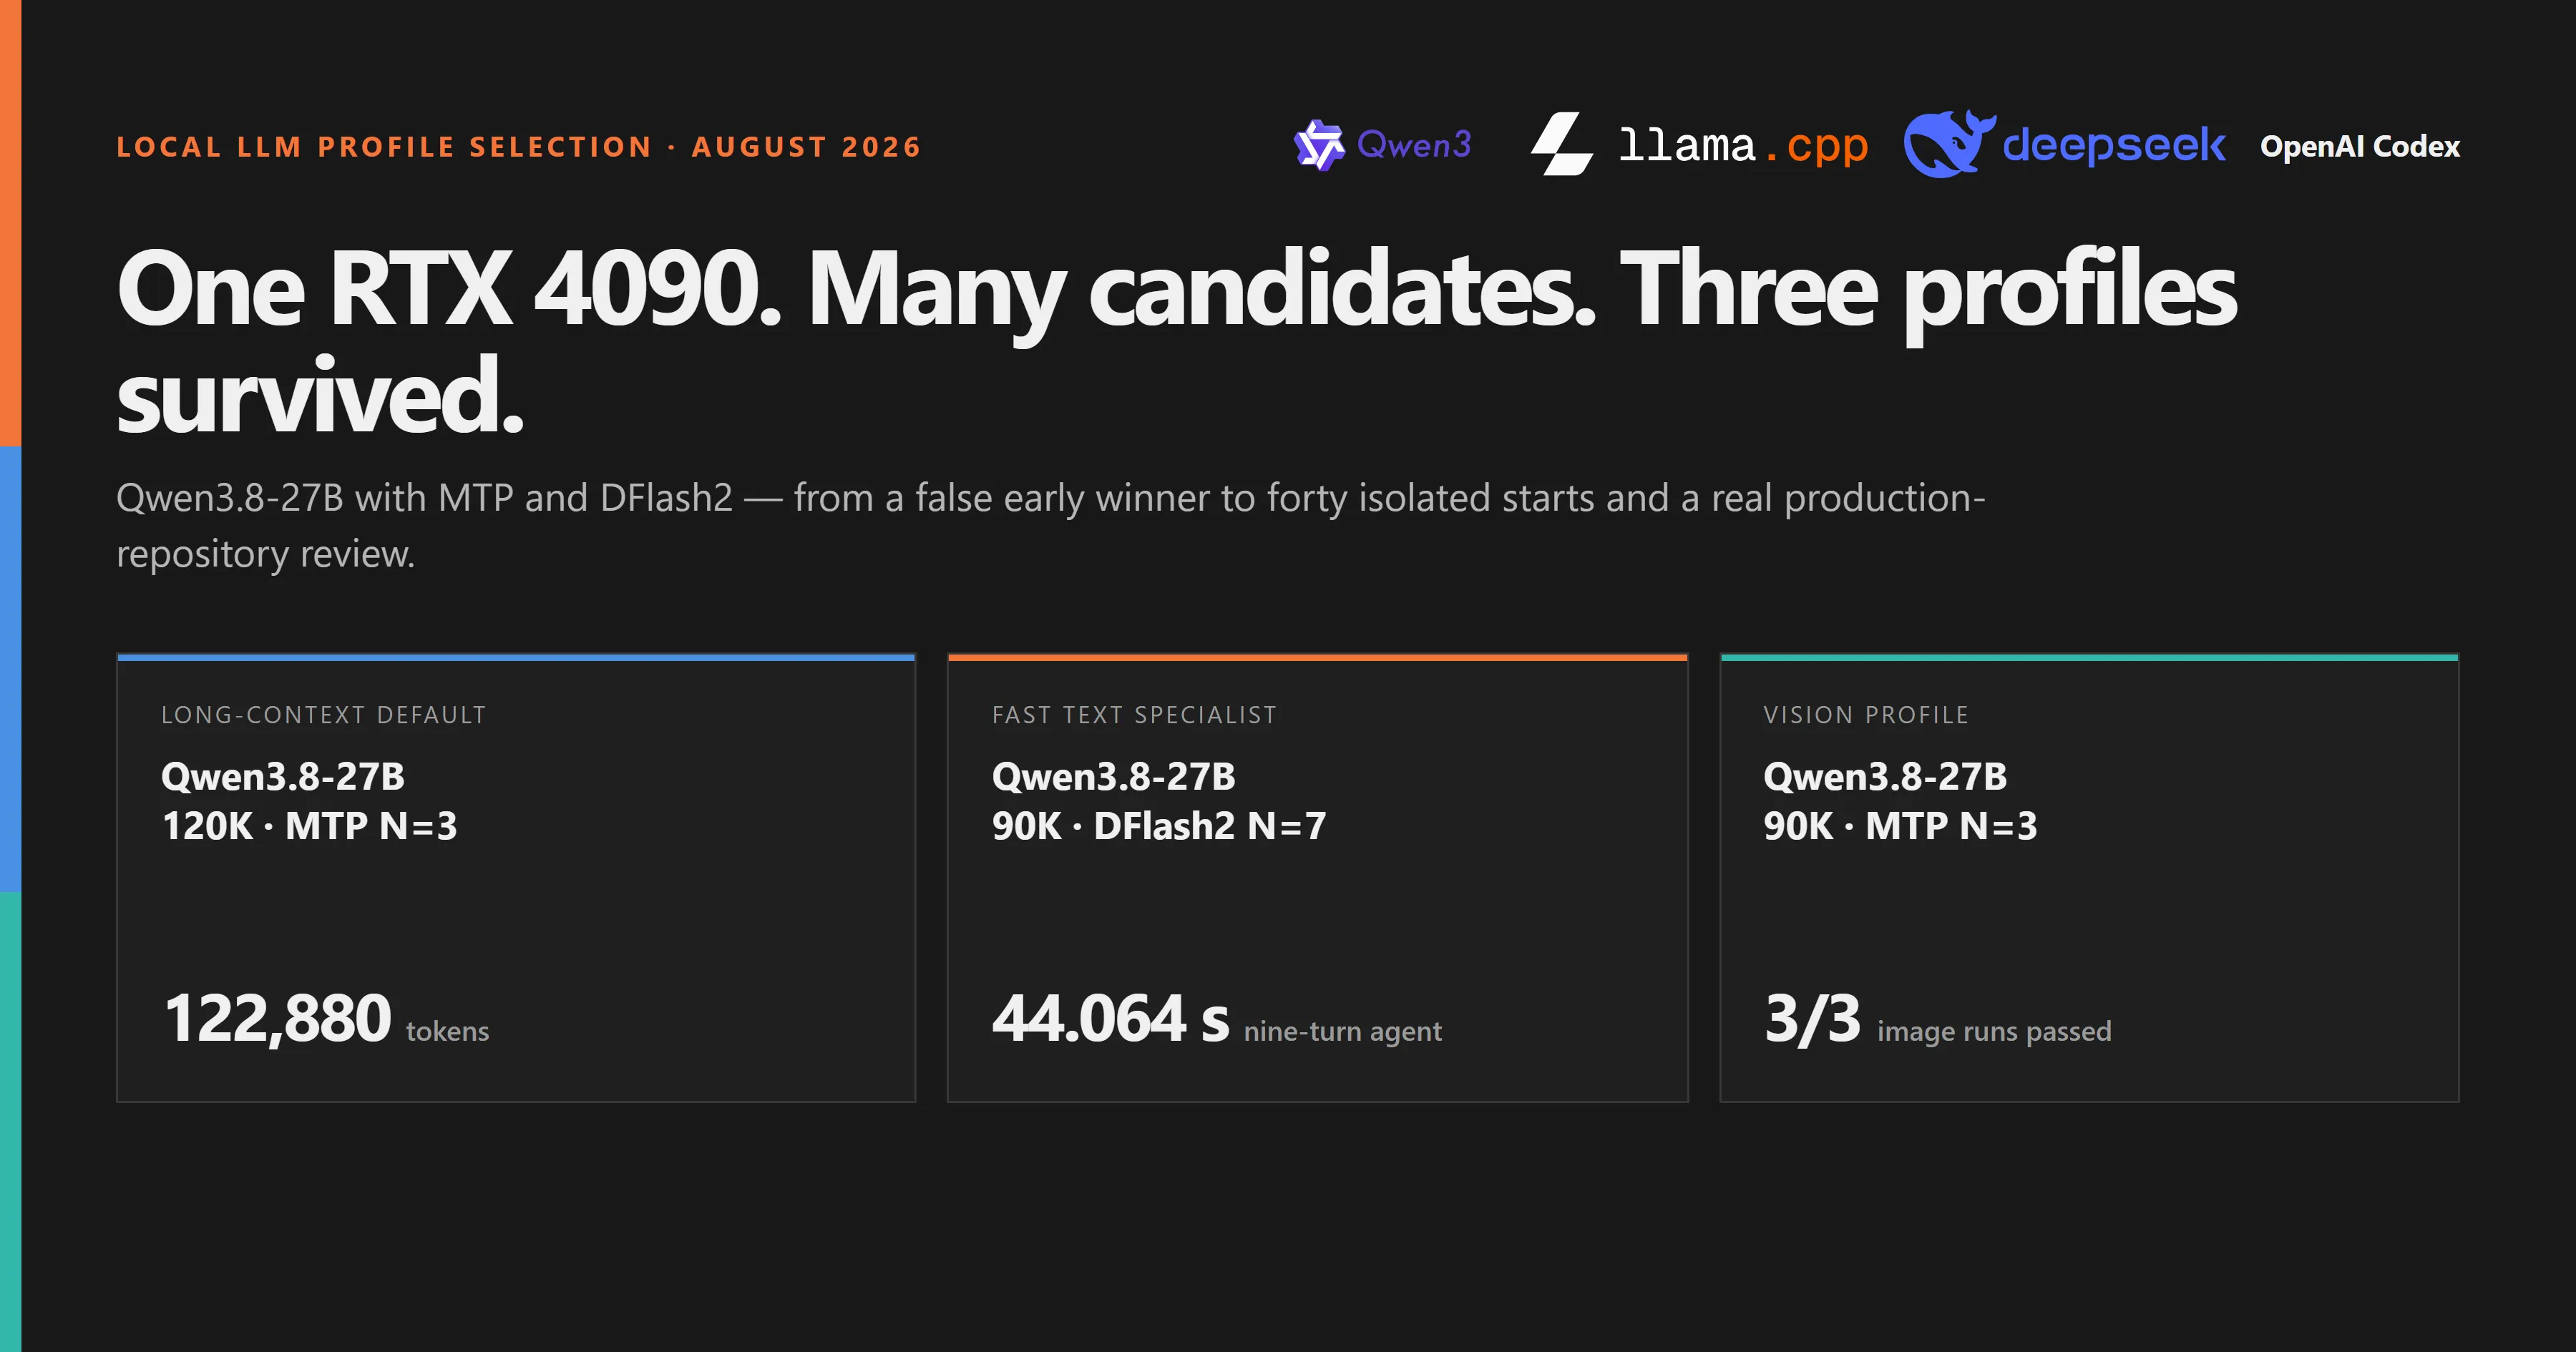
Von vielen Kandidaten zu drei Profilen: Qwen3.8-27B mit MTP und DFlash2
Auf einer RTX 4090 wurden MTP- und DFlash2-Profile schrittweise ausgesiebt. Das Ergebnis ist kein einzelner Sieger, sondern ein 120K-MTP-Standardprofil, ein schnelles 90K-DFlash2-Textprofil und ein verifiziertes 90K-MTP-Visionprofil.
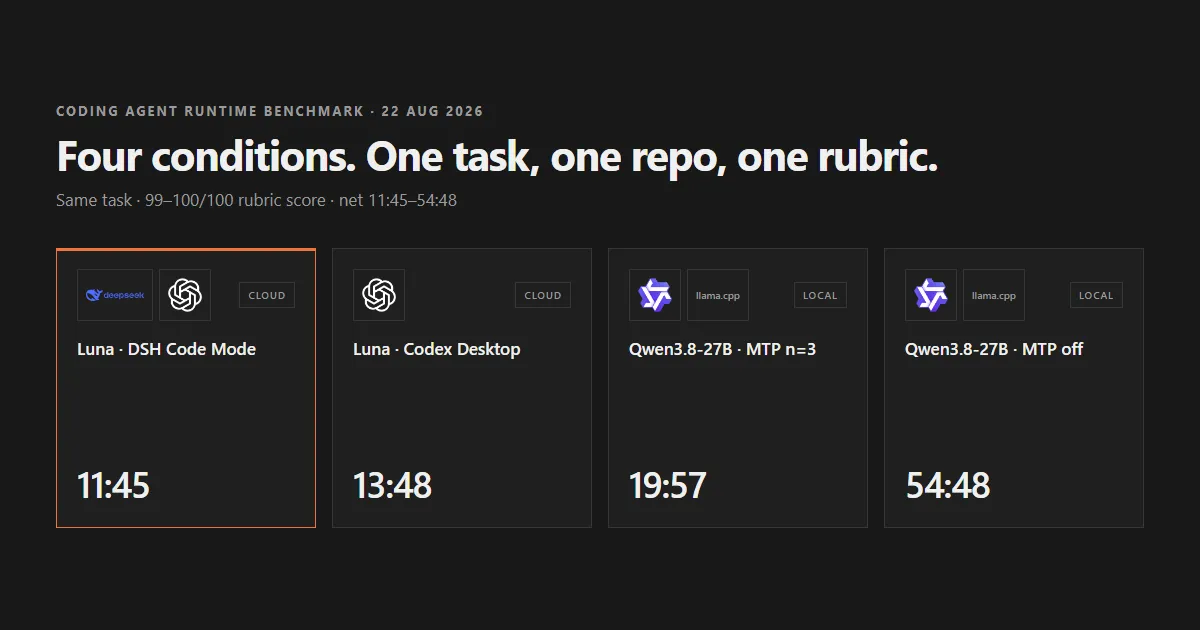
Vier Bedingungen, eine Aufgabe: Was spekulative Dekodierung und die Wahl des Agenten-Tools wirklich kosten
Vier Bedingungen lösten dieselbe Aufgabe im selben Repository und erreichten alle 99 oder 100 von 100 Punkten. Die Netto-Aufgabendauer — Freigabe-Wartezeit und automatische Kontext-Kompaktierung sind aus jeder Messung herausgerechnet — reichte von 11:45 für den Cloud-Lauf über DSH-Standardmodus bis 54:48 für das lokale Modell ohne spekulative Dekodierung.
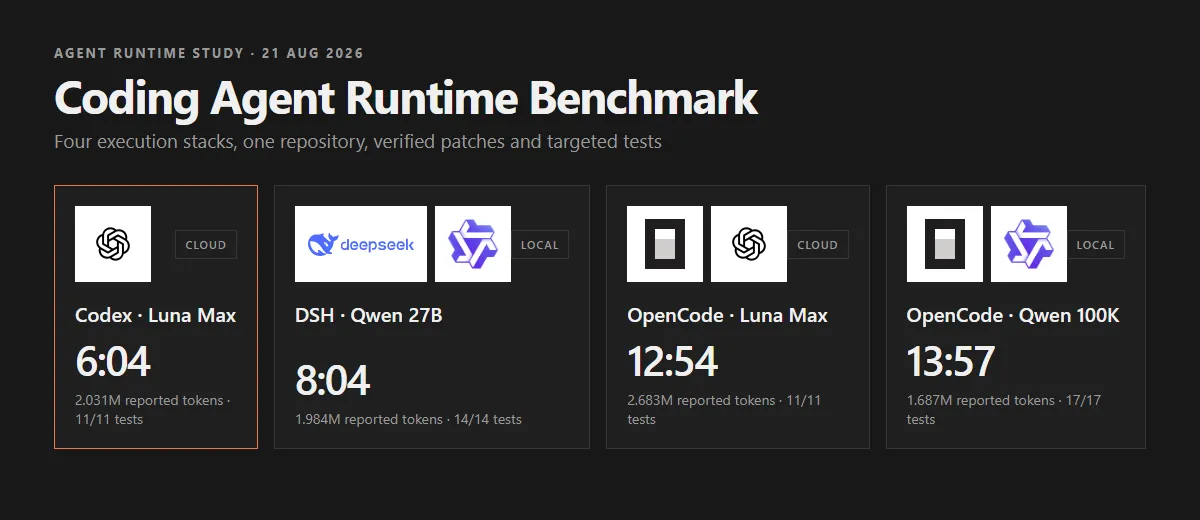
Coding-Agent-Benchmark: Wie stark das Runtime-System die Laufzeit verändert
Vier Coding-Agent-Läufe änderten dasselbe Repository und bestanden ihre Zieltests. Trotzdem reichte die Laufzeit von 6:04 bis 13:57 Minuten — Modell, Harness, Cache und Review wirkten gemeinsam.