 Cloud
Luna · DSH Standard Mode
11:45
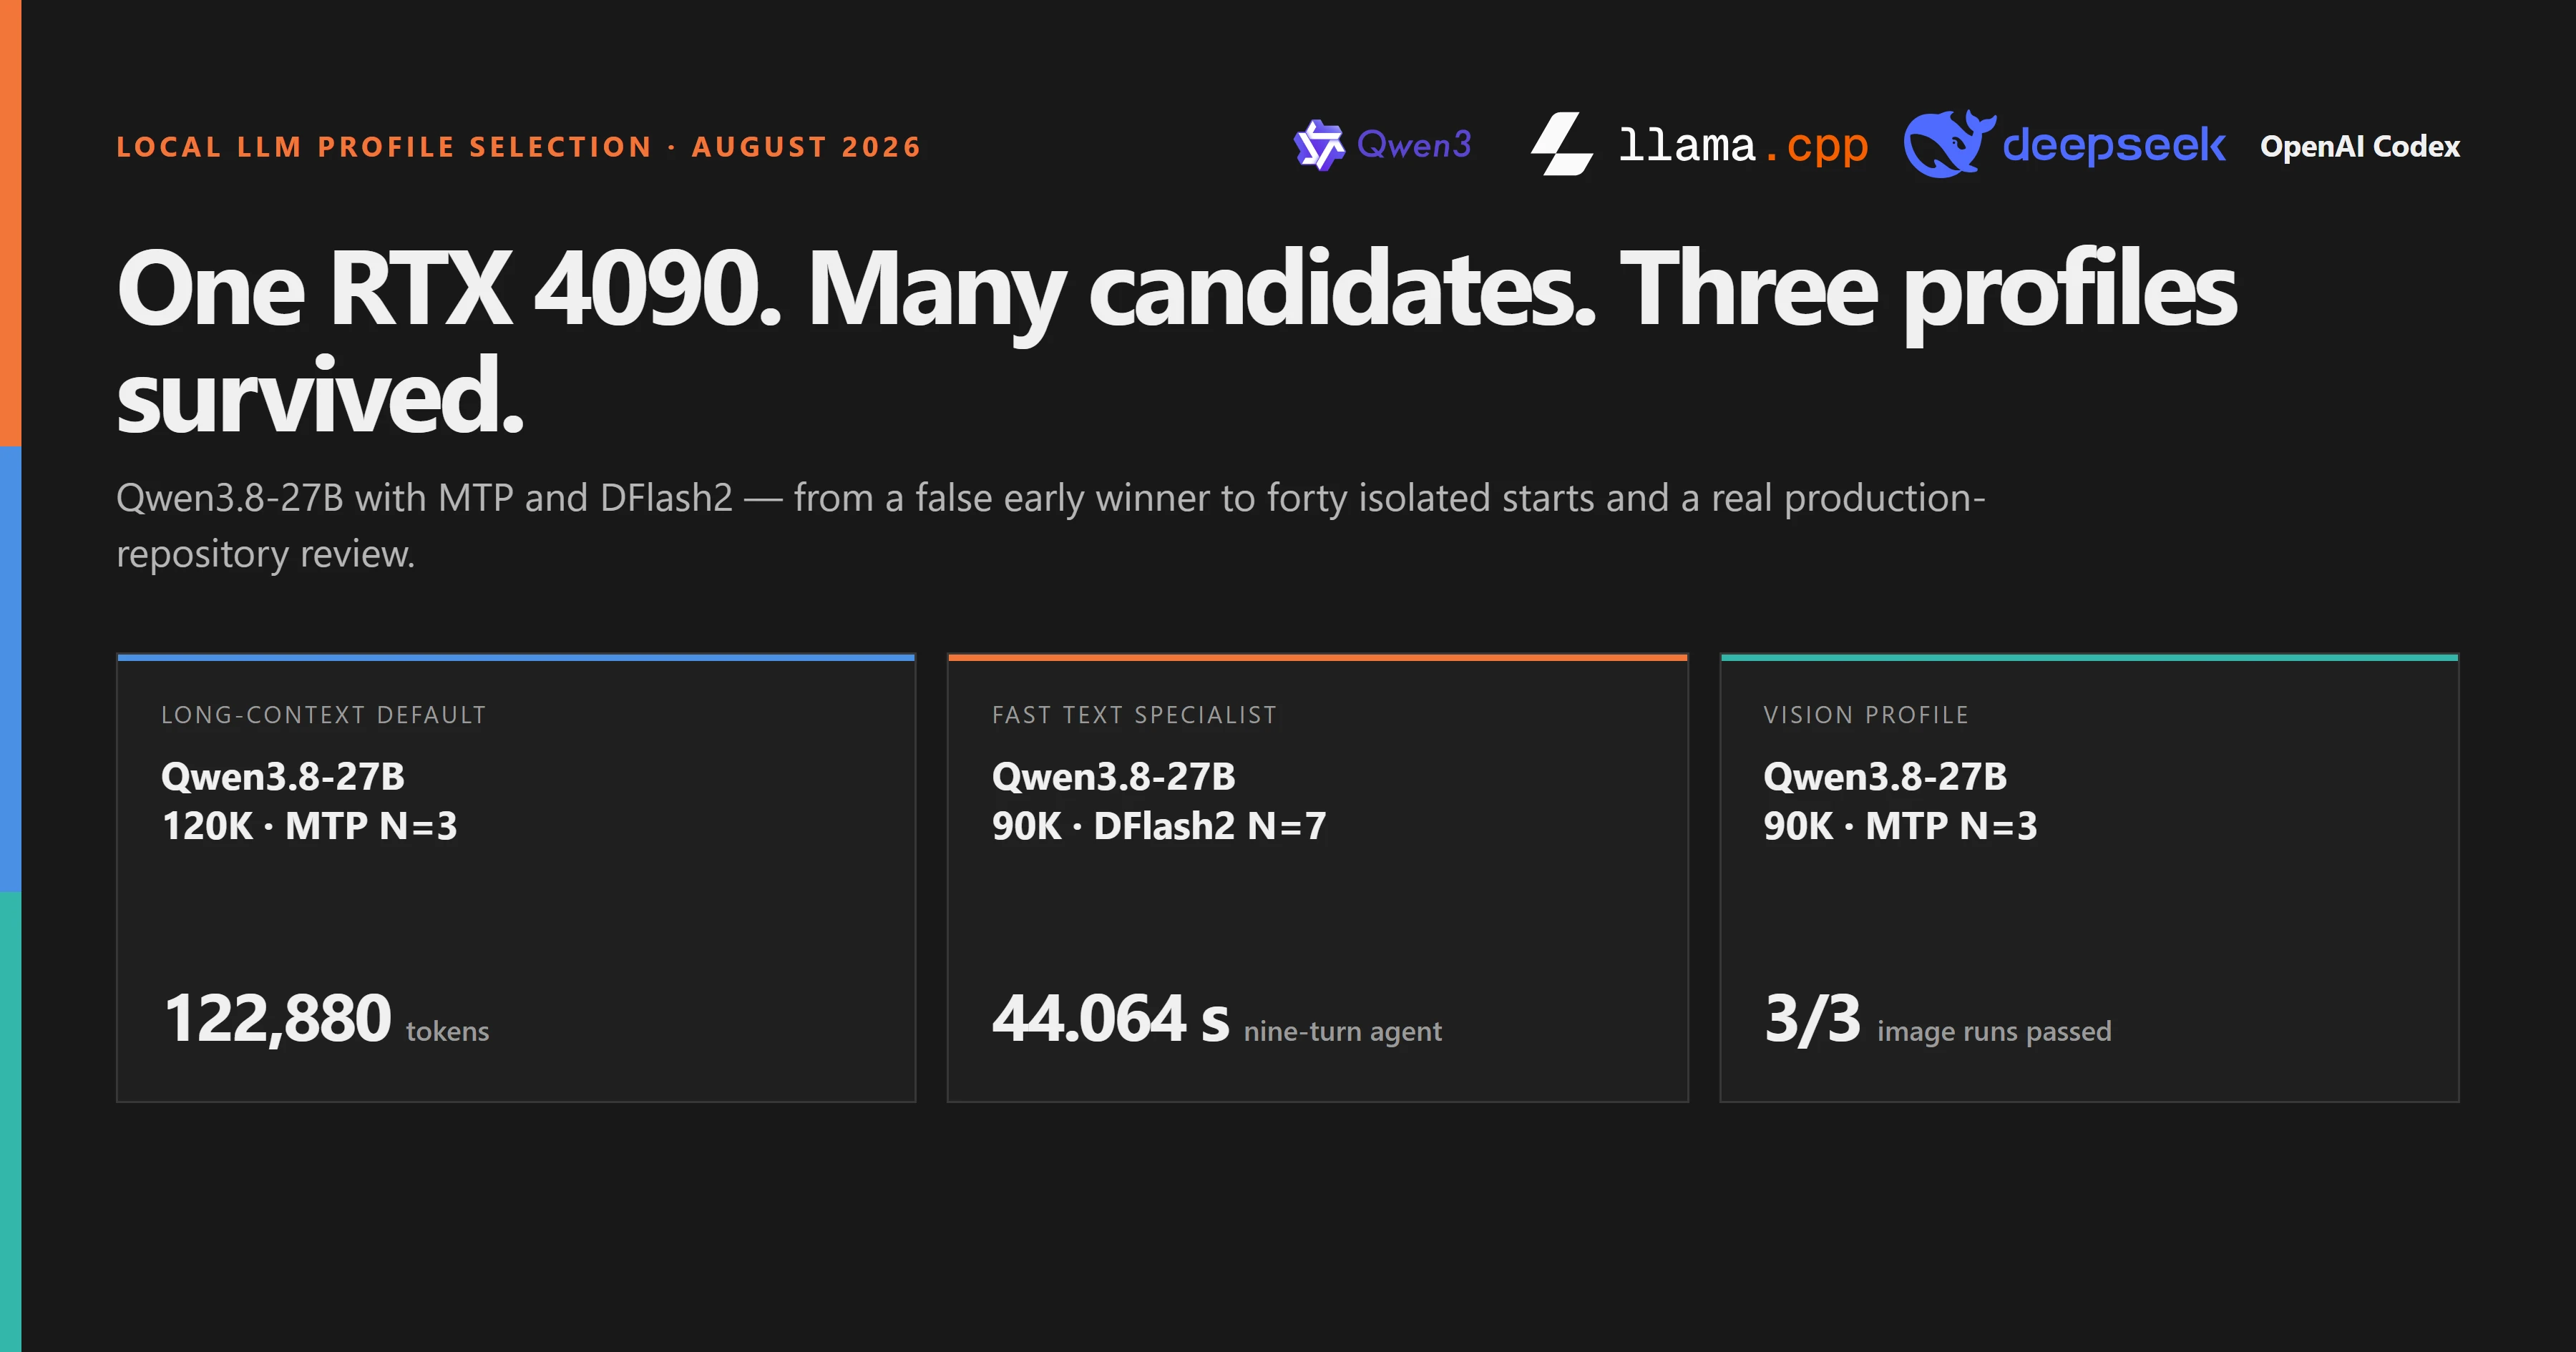
Sur une RTX 4090, les profils MTP et DFlash2 ont été éliminés étape par étape. Le résultat n'est pas un vainqueur universel, mais un profil MTP 120K par défaut, un spécialiste texte DFlash2 90K et un profil vision MTP 90K vérifié.
Benchmark de durée des agents de code
Quatre conditions. Une tâche, un dépôt, une grille d’évaluation.
Même tâche · 99–100/100 points · net 11:45–54:48
Cloud11:45
Cloud13:48
 llama.cppLocal
19:57
llama.cppLocal54:48
Quatre conditions ont résolu la même tâche dans le même dépôt et ont toutes obtenu 99 ou 100 points sur 100. La durée nette de la tâche — temps d'attente d'approbation et de compactage automatique du contexte exclus de chaque mesure — allait de 11:45 pour l'exécution cloud via le mode standard de DSH à 54:48 pour le modèle local sans décodage spéculatif.
Benchmark de durée des agents de code
Quatre piles d’exécution. Un dépôt.
4 correctifs · tous les tests ciblés réussis · 6:04–13:57
Cloud6:04
Local8:04
 Cloud
12:54
Local13:57
Quatre agents ont modifié le même dépôt et réussi leurs tests ciblés. La durée variait pourtant de 6:04 à 13:57, car modèle, harness, cache et revue agissaient ensemble.
Benchmark des interfaces agentiques
Un modèle. Quatre interfaces.
5 tâches · 20 exécutions neuves · 12/12 contrôles qualité
Le même modèle d’IA, quatre interfaces d’agents et cinq tâches réelles sur des dépôts : les écarts mesurés en qualité, tokens, durée et méthode de travail.
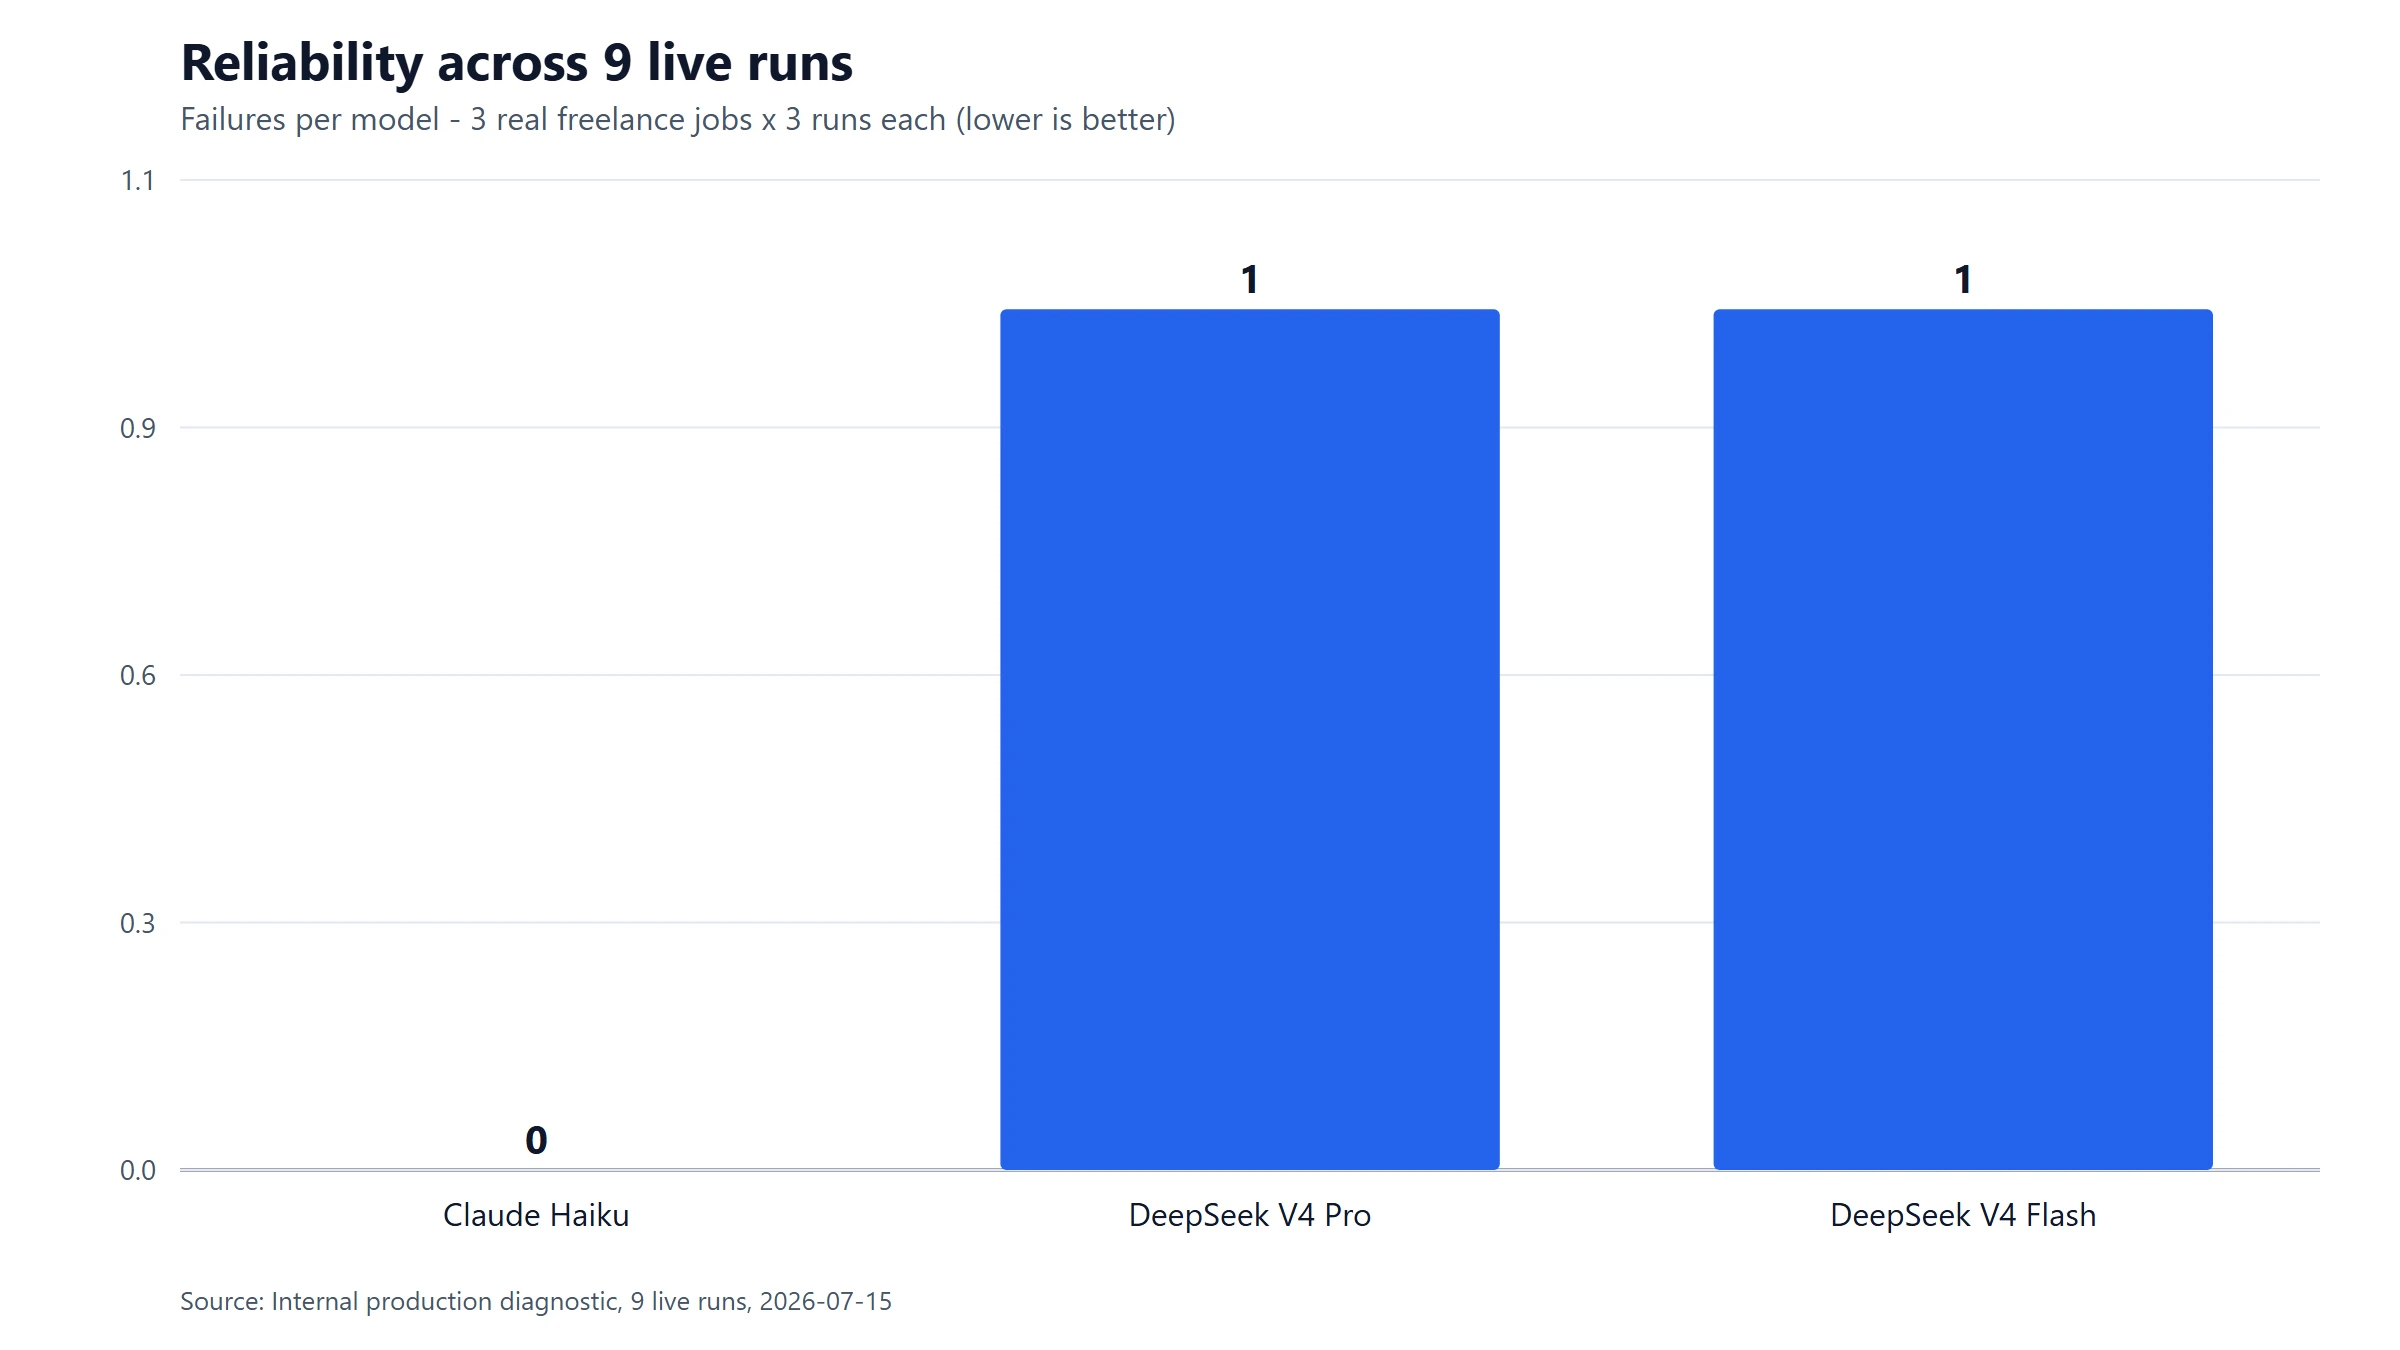
J'ai testé Claude Haiku face à DeepSeek V4 Pro et Flash sur mon propre pipeline IA de rédaction de propositions, avec trois vrais projets freelance.