
De nombreux candidats à trois profils : Qwen3.8-27B avec MTP et DFlash2
Le décodeur le plus rapide n'est pas automatiquement devenu le meilleur profil quotidien. Sur la même machine, avec la même famille cible Qwen3.8-27B et la même quantification, les configurations MTP et DFlash2 ont été éliminées en plusieurs étapes : sélection large, historique identique, migration vers le runtime officiel, 40 démarrages isolés, entrée image, puis revue read-only d'un dépôt de production.

Système et base modèle
| Composant | Configuration |
|---|---|
| OS | Windows 11 Pro, build 26200 |
| CPU | AMD Ryzen 9 7950X, 16 cœurs / 32 threads |
| GPU | NVIDIA RTX 4090, 24 564 MiB de VRAM déclarée |
| Mémoire | 128 Go DDR5, quatre modules, 3 600 MT/s |
| Modèle cible | Qwen3.8-27B, UD-Q4_K_XL GGUF |
| Cache KV | Q8 clé / Q8 valeur |
| Runtime | llama.cpp officiel b10658, commit b10f9ca58 |
L'effort de raisonnement n'était pas une variable contrôlée. Il n'a pas été balayé ni isolé ; aucune différence n'est donc expliquée par ce réglage.
Du faux gagnant au runtime officiel
Le premier écran comprenait P0, M3, M3K, D5 et D5K. M3K et D5K ont avancé ; KN n'a pas franchi le seuil de +3 %, et K1/K2 ont régressé. Un premier résultat donnait D5K 12,4 % devant M3K, mais l'audit a révélé des historiques différents. Avec un historique identique, M3K a terminé en 53,614 s, D5K en 119,756 s.
DFlash2 a ensuite été migré vers llama.cpp b10658. N=7 est passé de 114,02 à 118,12 tok/s effectifs sur le pont chaud à neuf tours. N=6 s'est effondré à grand contexte et a été éliminé. Le chemin image DFlash2 n'a pas produit de contenu utilisable ; DFlash2 est donc resté text-only.

Deux charges, deux gagnants
Sur le prompt rempli de 56 093 tokens, D7K décodait à 124,13 tok/s, mais M3K terminait la requête entière plus tôt. L'évaluation du prompt dominait cette charge.

Sur l'historique agent à neuf tours, D7K-90K a gagné avec 44,064 s.

Les 40 démarrages isolés se sont tous terminés naturellement, sans OOM, réponse vide, troncature ou échec de requête. Tous les profils ont réussi la récupération near-cap et cinq tests de code fonctionnel.
| Profil | Contexte | Mur 56K | Mur neuf tours | VRAM libre min. |
|---|---|---|---|---|
| M3K-128K | 131 072 | 34,659 s | 52,576 s | 345 MiB |
| M3K-120K | 122 880 | 34,479 s | 52,471 s | 699 MiB |
| D5K-100K | 102 400 | 36,445 s | 47,255 s | 423 MiB |
| D7K-90K | 90 000 | 36,714 s | 44,064 s | 582 MiB |

Les trois profils retenus
- Qwen3.8-27B-120K-Q8-M3K-Text : profil local par défaut à grand contexte.
- Qwen3.8-27B-90K-Q8-D7K-Official-TextOnly : spécialiste texte soutenu.
- Qwen3.8-27B-90K-Q8-M3K-VisionVRAM : profil texte + image vérifié.
Le profil vision a réussi trois exécutions image indépendantes et un smoke test routé. Sa moyenne était de 2,034 s, avec 858 ms de TTFT et 924 MiB de VRAM libre minimale.
Revue réelle du dépôt
Les deux coordinateurs Qwen ont utilisé des assistants Luna ; le run direct gpt-5.6-luna n'en a utilisé aucun. Il s'agit donc d'un comparatif de workflow, pas d'un pur comparatif de modèles.
| Run | Temps actif LLM+outil | Decode TPS local | TTFT moyen | Cache | Compaction |
|---|---|---|---|---|---|
| Qwen D7K-90K | 13:51,705 | 62,683 | 2,902 s | 88,64 % | 1 |
| Qwen M3K-120K | 13:36,616 | 62,325 | 2,098 s | 94,01 % | 0 |
| gpt-5.6-luna direct | non exposé | non exposé | non exposé | 93,125 % | non enregistré |

M3K-120K a terminé ses quatre assistants. D7K n'en a terminé que deux ; quatre ont atteint la limite d'usage et Qwen a dû reprendre leur travail. Luna direct a pris 44:33,227 de temps mural et a fourni la meilleure priorisation des chemins critiques. Ses 35,174 tokens de sortie par seconde murale ne sont pas un decode TPS comparable.
Le workflow recommandé est M3K-120K avec assistants Luna pour la couverture large, Luna direct pour l'arbitrage critique, D7K-90K pour le texte local soutenu, et M3K-90K pour l'image.
Limites et sources
Les résultats dépendent du système, du build, de la quantification, des contextes et des charges testées. Les comptes de findings n'établissent pas seuls leur exactitude. Le raisonnement n'était pas une variable contrôlée.
D'autres articles
Quatre conditions, une tâche : ce que coûtent vraiment le décodage spéculatif et le choix de l'outil d'agent
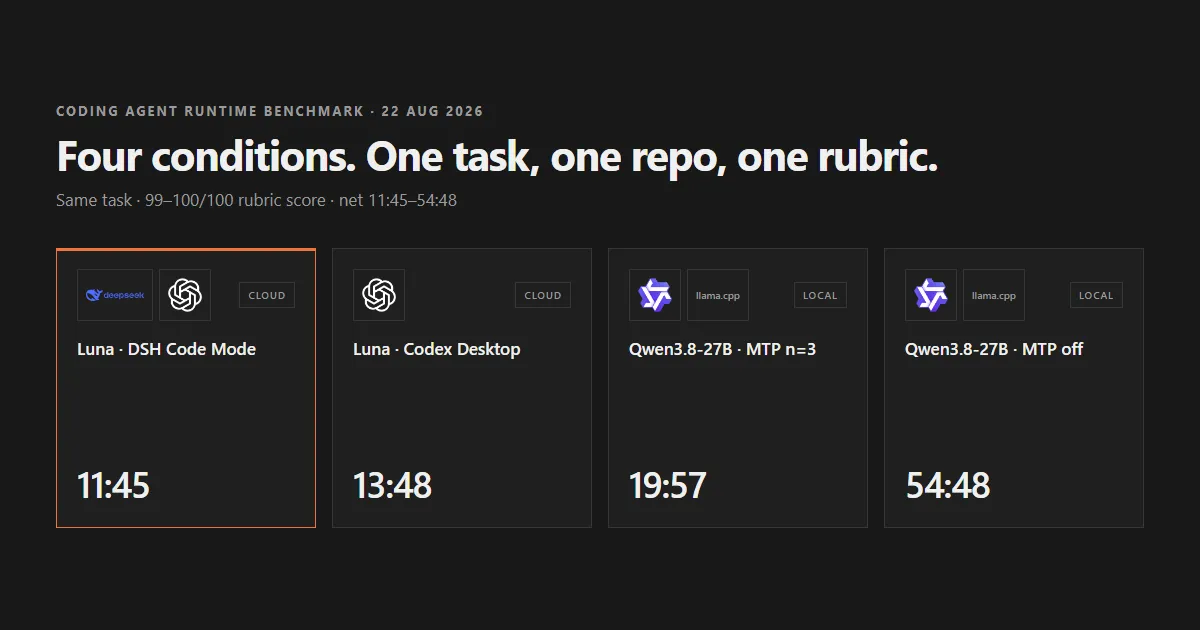
Quatre conditions ont résolu la même tâche dans le même dépôt et ont toutes obtenu 99 ou 100 points sur 100. La durée nette de la tâche — temps d'attente d'approbation et de compactage automatique du contexte exclus de chaque mesure — allait de 11:45 pour l'exécution cloud via le mode standard de DSH à 54:48 pour le modèle local sans décodage spéculatif.
Benchmark d’agents de code : l’impact de la couche d’exécution
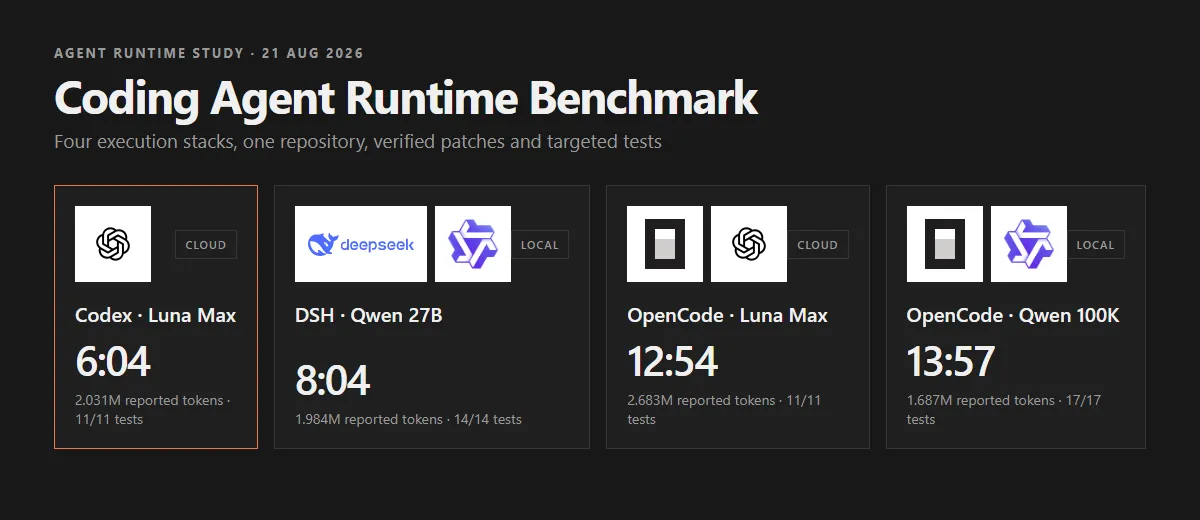
Quatre agents ont modifié le même dépôt et réussi leurs tests ciblés. La durée variait pourtant de 6:04 à 13:57, car modèle, harness, cache et revue agissaient ensemble.
Quatre agents IA testés : tokens, temps et qualité
Le même modèle d’IA, quatre interfaces d’agents et cinq tâches réelles sur des dépôts : les écarts mesurés en qualité, tokens, durée et méthode de travail.