 Cloud
Codex · Luna Max
6:04
Benchmark de durée des agents de code
Quatre piles d’exécution. Un dépôt.
4 correctifs · tous les tests ciblés réussis · 6:04–13:57
Cloud6:04
 Local
8:04
 Cloud
12:54
Local13:57
Relevé le : 2026-08-21T12:39:07+02:00
Système d’exploitation
Windows 11 Pro
CPU
AMD Ryzen 9 7950X
Cœurs
16C/32T
RAM
128 GB
GPU / VRAM
NVIDIA GeForce RTX 4090 / 24 GB
Pilote GPU
610.88
| Exécution | Runtime | Modèle | Format / quantification | Contexte / cache KV | Backend |
|---|---|---|---|---|---|
| Codex · Luna Max (Cloud) | Codex CLI 0.148.0-alpha.21 | gpt-5.6-luna (GPT-5.6 Luna Max) | non communiqué par le fournisseur | 258400 tokens / non communiqué par le fournisseur | non communiqué par le fournisseur |
| DSH · Qwen 3.8 27B (Local) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-Q4-100K-Q8 (Qwen 3.8 27B Q4 (100K Q8 KV)) | GGUF / Q4 | 100K (102400 tokens) / Q8 | llama.cpp |
| OpenCode · Luna Max (Cloud) | OpenCode 1.18.19 | GPT-5.6 Luna | non communiqué par le fournisseur | non communiqué par le fournisseur / non communiqué par le fournisseur | non communiqué par le fournisseur |
| OpenCode · Qwen 100K (Local) | OpenCode 1.18.19 | Qwen3.8-27B Q4 (100K Q8 KV) | GGUF / Q4 | 100K / Q8 | llama.cpp |
Le matériel a été revérifié sur la même machine après la fin des sessions. Les valeurs par exécution proviennent des exports de session conservés ; tout ce qui n’a pas été consigné est marqué comme tel plutôt que deviné.
La quantification des poids (Q4) et celle du cache KV (Q8) sont volontairement présentées séparément pour les exécutions Qwen.
Quatre correctifs différents · tous les tests ciblés réussis
Le benchmark mesure toute la pile d’exécution
Le modèle n’est qu’une entrée du temps total et du volume de tokens.
Prompt système, skills, mémoire et règles de planification
Entrée nouvelle, cache, compactage et continuation
Lecture du dépôt, modifications, commandes et tests
Réponses utilisateur, reviewer et règles de vérification
Portée du correctif, tests ciblés et compte rendu
Secondes · moins est préférable
Millions de tokens · pas un score direct de vitesse
Harness direct = 1,00 · moins est préférable
Codex omis faute de compteurs exportés comparables
Pourcentage · entrée nouvelle contre lectures du cache
Secondes · revue contre tout le reste du temps mesuré
Milliers de tokens · sortie plus raisonnement déclaré séparément
| Runtime | Modification choisie | Fichiers | Tests | Résultat |
|---|---|---|---|---|
| Codex · Luna Max | Compatibilité ValueError et garde pour les flashcards non-objets | 2 | 11 | 11/11 |
| DSH · Qwen 27B | Sauvegarde atomique de RunKeyStore avec fichier temporaire et os.replace | 2 | 14 | 14/14 |
| OpenCode · Luna Max | FlashcardValidationError hérite de ValueError | 3 | 11 | 11/11 |
| OpenCode · Qwen 100K | Correction des espaces OCR dans le calcul du taux de déchets | 2 | 17 | 17/17 |
Quatre sessions d’agents de code ont reçu le même dépôt et la même mission générale. Chacune a produit une modification et réussi ses tests ciblés. La durée totale variait pourtant de 6:04 à 13:57.
Codex avec Luna Max a été l’exécution la plus courte. DSH avec Qwen 3.8 27B a été l’exécution locale la plus courte. Les deux configurations OpenCode ont pris davantage de temps, même si OpenCode Qwen déclarait le volume total de tokens le plus faible.
La conclusion principale n’est donc pas un classement universel des modèles. Un agent de code comprend aussi les instructions système, les skills, la mémoire, la gestion du contexte, le cache, les outils, les validations utilisateur, la politique de revue et la vérification finale.
Les quatre sessions partaient du même dépôt et de la même mission abstraite, sans être contraintes de choisir le même défaut concret. Les deux exécutions Luna ont convergé vers la même zone de flashcards, avec une portée différente. Les exécutions Qwen ont choisi d’autres défauts.
Le test compare donc des profils de runtime complets, et non quatre modèles dans une condition contrôlée « même correctif ». Une session peut être plus longue à cause de la génération, d’un plus grand nombre d’actions outils, d’une revue indépendante ou du compactage et de la continuation du contexte.
OpenCode Luna a pris 2,13 fois le temps de Codex Luna. OpenCode Qwen a pris 1,73 fois le temps de DSH Qwen. Pourtant, OpenCode Qwen a été la session la plus longue tout en déclarant le moins de tokens. Un volume réduit n’est donc pas automatiquement un score de vitesse ou de qualité.
Les schémas de tokens diffèrent aussi. Codex inclut le raisonnement dans la sortie. OpenCode le sépare et combine entrée nouvelle et lectures du cache dans le prompt. DSH expose des totaux de prompt et de sortie. Ces valeurs normalisées décrivent une charge de travail, pas directement une facture, une consommation énergétique ou une limite d’abonnement.
Plus de 91 pour cent du volume côté prompt provenait du cache dans les deux sessions OpenCode. OpenCode Luna déclarait 220 630 tokens d’entrée nouvelle et 2 451 456 tokens lus du cache ; OpenCode Qwen en déclarait respectivement 145 146 et 1 514 973.
DSH Qwen a utilisé 36 tours assistant et 57 appels d’outils. OpenCode Luna a utilisé 32 tours et 67 appels ; OpenCode Qwen, 31 tours et 39 appels. L’export Codex ne fournissait pas de compteurs directement comparables ; il est donc omis de cette vue au lieu de recevoir un zéro trompeur.
OpenCode Luna a activé brainstorming, planification, développement piloté par les tests, revue de code et vérification finale. Le reviewer a représenté environ 299 secondes, soit 38,6 pour cent de la session. Ce protocole peut être pertinent pour une modification importante ou risquée. Pour un petit correctif, son coût fixe est devenu une partie substantielle du temps total.
Codex Luna utilisait les recommandations de Karpathy et une mémoire de travail antérieure. Ces éléments ont peut-être favorisé un correctif plus petit, des hypothèses explicites et une vérification directe. Une seule exécution ne permet toutefois pas d’en mesurer l’effet indépendant ; il faut un bras expérimental skills activés contre skills désactivés.
Chaque condition n’a été exécutée qu’une fois. Les agents n’ont pas produit le même correctif, les exports de tokens n’utilisent pas la même sémantique et Qwen fonctionnait localement alors que Luna utilisait le cloud. Le nombre de tests n’est pas un classement de qualité puisque les portées diffèrent.
Le prochain test devrait imposer un seul défaut, un même test d’acceptation, les mêmes outils, les mêmes instructions système et les mêmes limites de contexte et de temps. Chaque condition devrait être répétée au moins trois fois. Pour Qwen, il faut enregistrer le matériel, la quantification, la limite de contexte, le format du KV cache et le débit de génération. Des horodatages par étape sépareraient enfin latence du modèle, outils et revue.
Les mesures ont été reconstruites depuis quatre exports conservés : `lunamax-session.jsonl`, `session.jsonl`, `session-ses_fdda.md` et `session-ses_fdd8.md`.
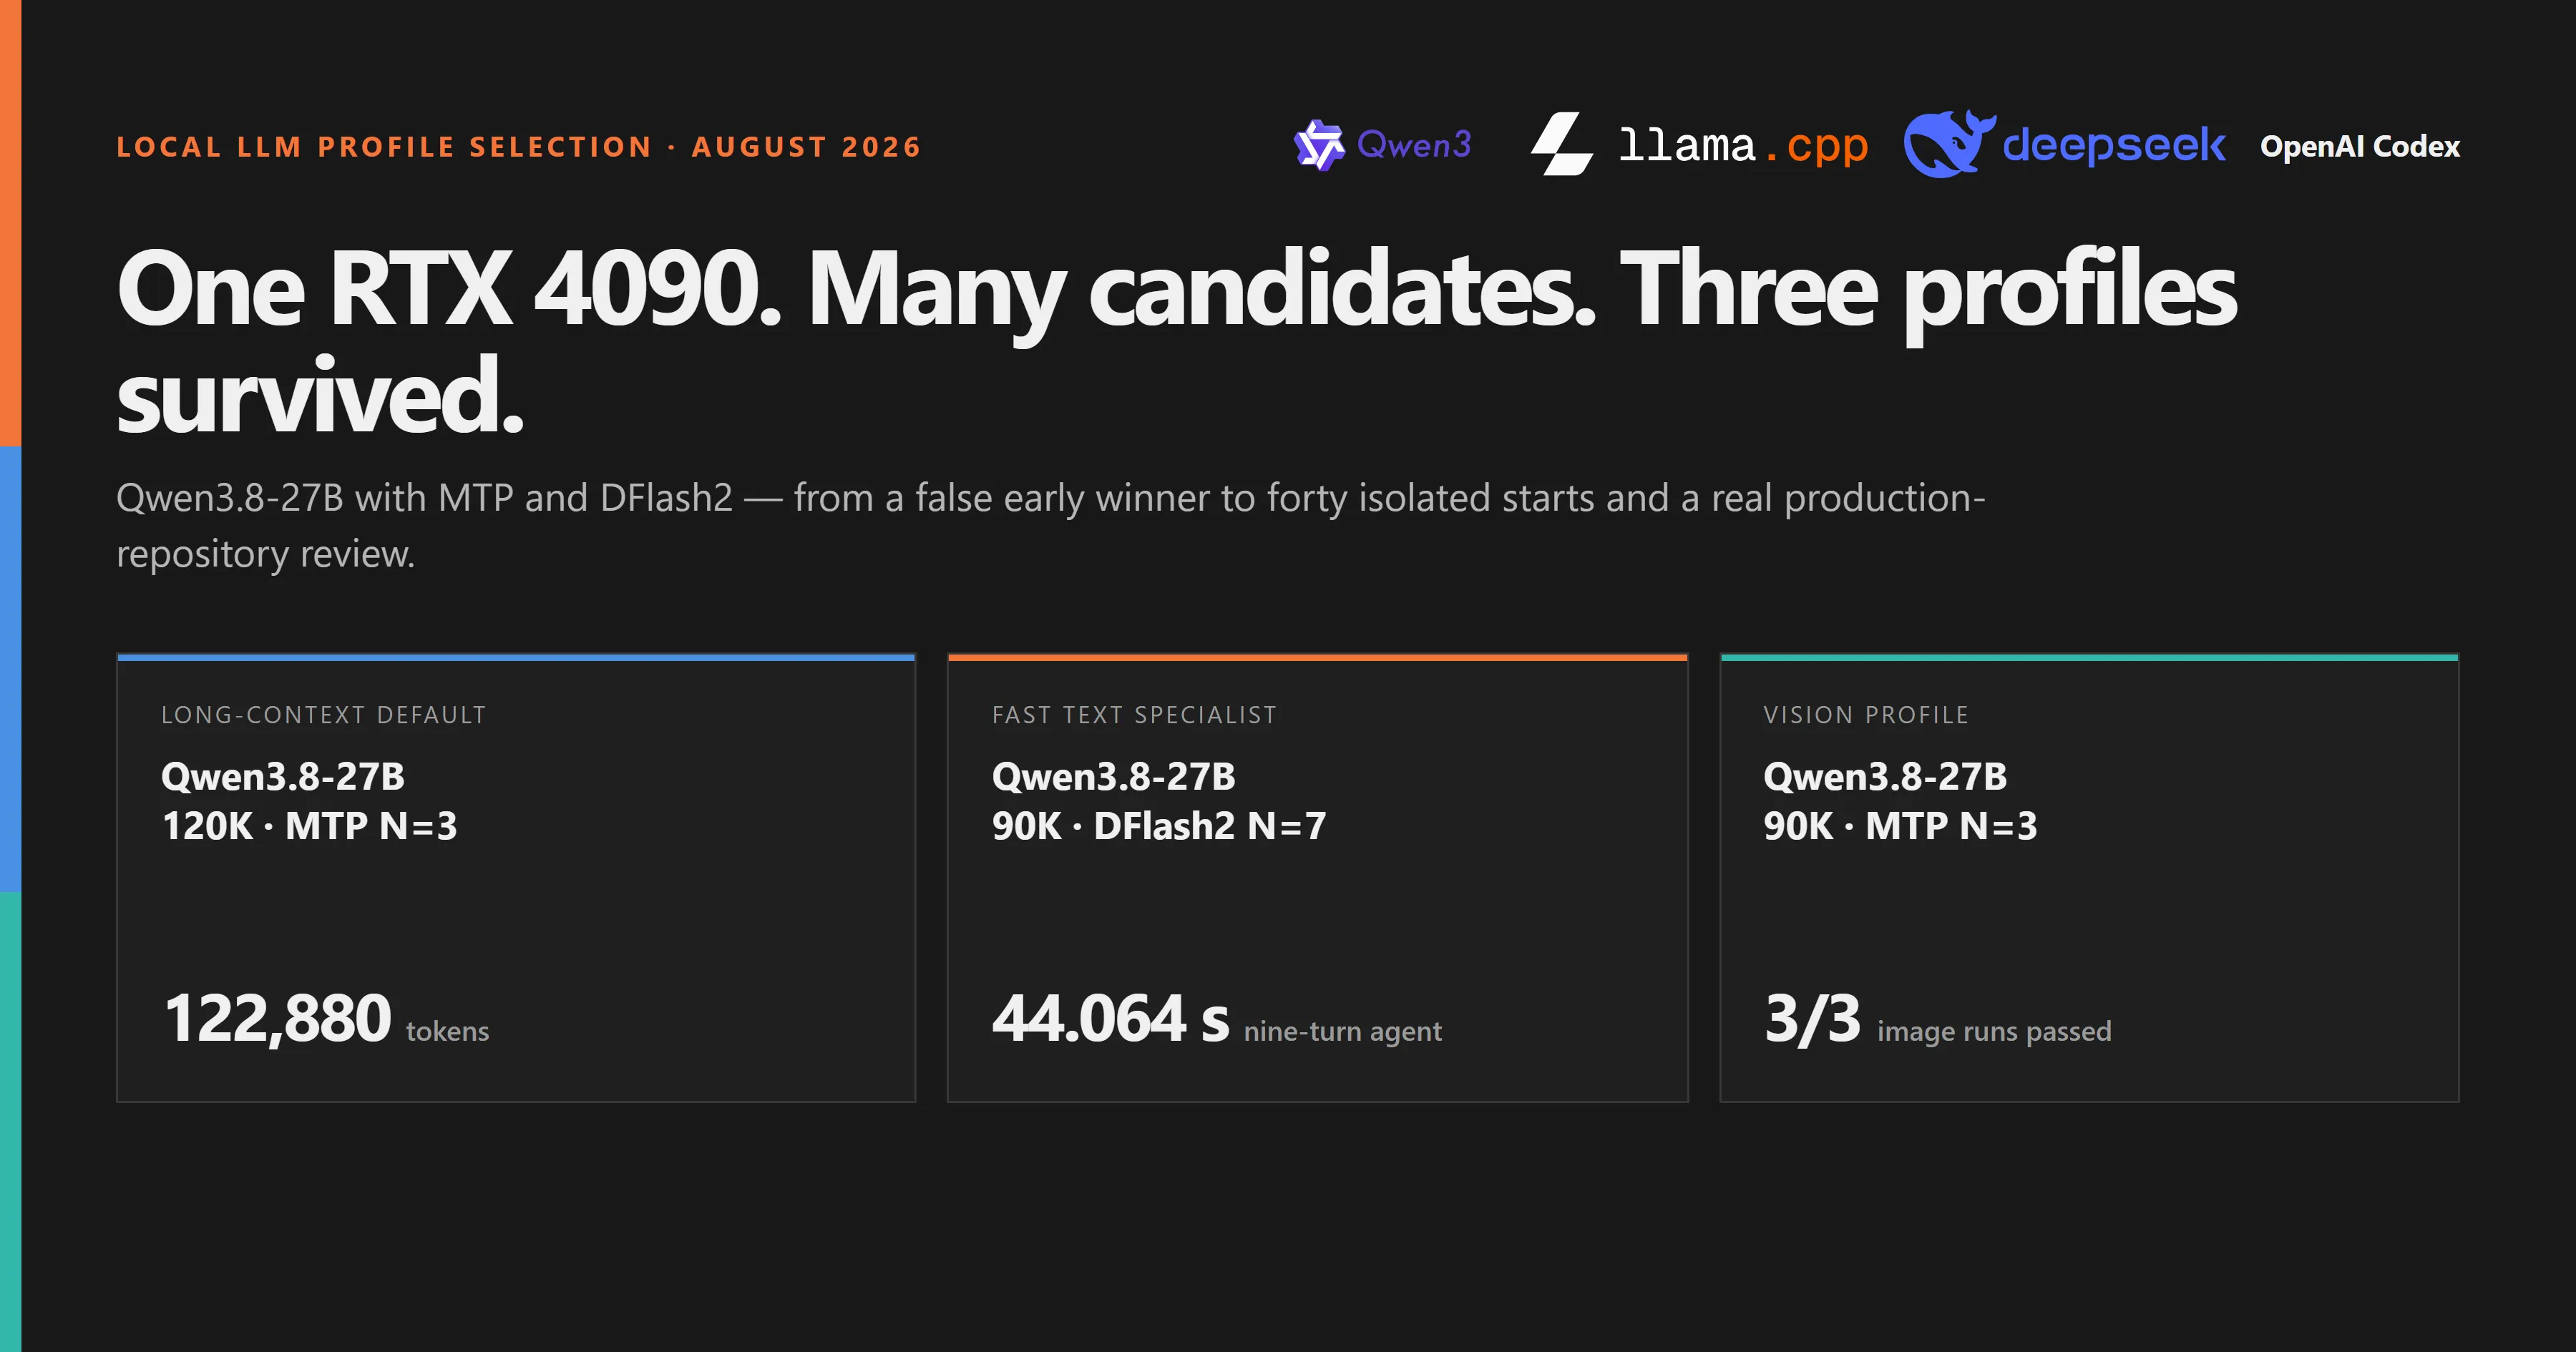
De nombreux candidats à trois profils : Qwen3.8-27B avec MTP et DFlash2
Sur une RTX 4090, les profils MTP et DFlash2 ont été éliminés étape par étape. Le résultat n'est pas un vainqueur universel, mais un profil MTP 120K par défaut, un spécialiste texte DFlash2 90K et un profil vision MTP 90K vérifié.
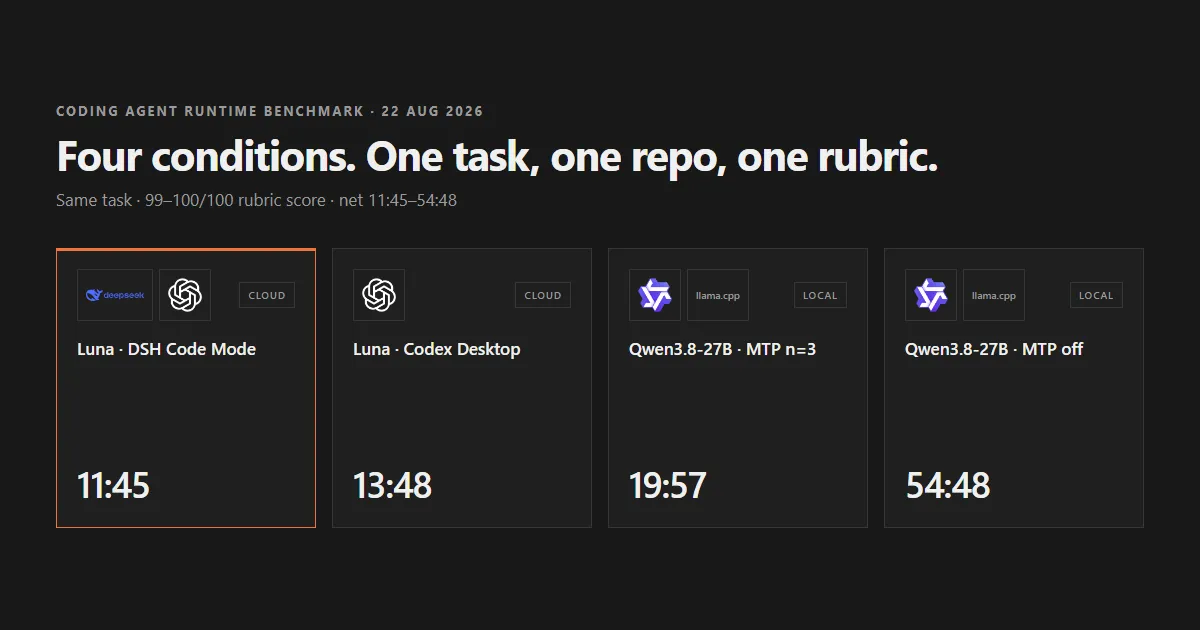
Quatre conditions, une tâche : ce que coûtent vraiment le décodage spéculatif et le choix de l'outil d'agent
Quatre conditions ont résolu la même tâche dans le même dépôt et ont toutes obtenu 99 ou 100 points sur 100. La durée nette de la tâche — temps d'attente d'approbation et de compactage automatique du contexte exclus de chaque mesure — allait de 11:45 pour l'exécution cloud via le mode standard de DSH à 54:48 pour le modèle local sans décodage spéculatif.
Quatre agents IA testés : tokens, temps et qualité
Le même modèle d’IA, quatre interfaces d’agents et cinq tâches réelles sur des dépôts : les écarts mesurés en qualité, tokens, durée et méthode de travail.