Benchmark delle interfacce agentiche
Un modello. Quattro interfacce.
5 attività · 20 esecuzioni nuove · 12/12 controlli qualità
Quattro agenti IA a confronto: token, tempo e qualità
Il benchmark in breve
20 risposte · 12/12 controlli qualità superati
- 96.49Codex App
- Token
- 4.09M
- Tempo
- 30.98 min
- Chiamate
- 66
- Lettura
- Miglior equilibrio
- 95.77Codex CLI
- Token
- 4.09M
- Tempo
- 30.86 min
- Chiamate
- 62
- Lettura
- Esecuzione più rapida
- Pi95.75
- Token
- 3.37M
- Tempo
- 37.48 min
- Chiamate
- 170
- Lettura
- Meno token
- 93.65OpenCode
- Token
- 4.20M
- Tempo
- 36.13 min
- Chiamate
- 186
- Lettura
- Alternativa flessibile
Quattro letture delle stesse esecuzioni
Punteggio complessivo ponderato
Scala focalizzata 90–100 · più alto è meglio
Token elaborati
Milioni di token · meno è meglio
Durata totale
Minuti · meno è meglio
Chiamate agli strumenti
Chiamate su cinque attività · meno è meglio
Nell’architettura, l’IA non si limita più alla generazione di immagini. Compare nell’analisi di brief, regolamenti edilizi e siti, negli studi di layout e nelle attività ricorrenti di validazione o documentazione. Il RIBA AI Report 2025 descrive questi impieghi tra pre-design, progettazione e verifica. Allo stesso tempo, una ricerca AIA del 2025 rileva che solo l’8% degli studi intervistati aveva implementato formalmente l’IA, mentre un ulteriore 20% stava lavorando per adottarla.
In questa fase di transizione si parla molto del modello e troppo poco dell’interfaccia che lo dirige davvero. Due agenti possono usare lo stesso modello, ma elaborare quantità diverse di contesto, effettuare un numero diverso di chiamate agli strumenti e terminare in tempi differenti. Per uno studio di architettura che usa l’IA nell’analisi di gare, nella ricerca progettuale, nell’automazione vicina al BIM o nel controllo qualità interno, questa differenza è operativa. Incide su costi e velocità, ma anche su tracciabilità, automazione e livello di supervisione umana.
Ho quindi confrontato quattro interfacce agentiche nelle stesse condizioni: Codex App, Codex CLI, Pi e OpenCode.
Che cosa misura davvero il test
Non si trattava di un confronto tra diversi modelli locali. In tutte le 20 sessioni nuove è stato usato lo stesso modello gpt-5.6-luna, con il massimo sforzo di ragionamento. Il benchmark isola il livello agentico che lo circonda: gestione del contesto, uso degli strumenti, durata e capacità di ricavare una risposta difendibile da un repository reale.
Le cinque attività provenivano da cinque repository diversi e coprivano indagini impegnative in sola lettura: stato di pubblicazione, workflow di approvazione, controlli delle evidenze per un inventario 3D, coerenza degli output CAD/DXF e consegna concorrente delle notifiche. Ogni attività è stata eseguita sulle quattro interfacce con lo stesso prompt. Dopo aver normalizzato le terminazioni di riga e gli spazi finali, le quattro copie del prompt di ogni attività producevano lo stesso hash SHA-256.
Ogni risposta è stata poi verificata rispetto al codice sorgente attuale. La rubrica valutava traccia comportamentale, accuratezza dei rischi, evidenze o test e rispetto del contratto di risposta. Tutte le 20 risposte finali hanno ottenuto 12 su 12. Questo non dimostra che gli agenti siano generalmente intelligenti allo stesso modo; indica che queste cinque attività di ricerca hanno raggiunto il tetto qualitativo del test.
Risultati complessivi
Il punteggio ponderato assegnava 60 punti alla qualità, 15 al volume di token elaborati, 15 al tempo e 10 all’affidabilità.
- Codex App: 96,49/100 · 4.093.797 token elaborati · 494.181 token non in cache · 30,98 minuti · 66 chiamate agli strumenti
- Codex CLI: 95,77/100 · 4.088.140 token elaborati · 492.620 token non in cache · 30,86 minuti · 62 chiamate agli strumenti
- Pi: 95,75/100 · 3.370.229 token elaborati · 545.013 token non in cache · 37,48 minuti · 170 chiamate agli strumenti
- OpenCode: 93,65/100 · 4.198.888 token elaborati · 633.320 token non in cache · 36,13 minuti · 186 chiamate agli strumenti
La classifica è più equilibrata di quanto sembri. Codex App vince il punteggio ponderato; Codex CLI è più veloce di soli 6,85 secondi nel totale. Pi termina appena 0,02 punti dietro la CLI, ma con un profilo di risorse nettamente diverso. OpenCode offre la stessa qualità misurata, senza però guidare questo campione per token, tempo o numero di chiamate agli strumenti.
La domanda su Pi: usa davvero meno token?
Pi è l’approccio più recente e volutamente minimalista di questo confronto. La documentazione ufficiale di Pi descrive un ambiente terminale piccolo ed estensibile; la documentazione sulla compattazione spiega come riassumere il contesto meno recente e limitare output degli strumenti molto lunghi. Questo design ha alimentato nella comunità la percezione di Pi come soluzione particolarmente leggera. Le impressioni aneddotiche, tuttavia, non sono una misura controllata.
Le nostre cinque attività forniscono una risposta più precisa. Pi registra il volume totale di token elaborati più basso, 3,37 milioni: il 17,7% in meno rispetto a Codex App, il 17,6% in meno rispetto a Codex CLI e il 19,7% in meno rispetto a OpenCode. L’aspettativa di un’elaborazione complessiva del contesto più leggera è quindi confermata in questo benchmark.
Ma soltanto per questa metrica. Codex CLI e Codex App usano meno token non in cache. Pi richiede anche circa il 21% di tempo in più rispetto alla CLI e quasi 2,7 volte il numero di chiamate agli strumenti. Dire “meno token” è quindi incompleto se non si specifica se l’obiettivo è ridurre il volume totale di contesto, il contenuto elaborato per la prima volta, il costo API reale oppure il tempo di attesa umano.
Anche la parola “token” richiede cautela. I quattro formati di esportazione non esponevano esattamente gli stessi campi; la misura comune è stata quindi normalizzata come carico di lavoro: input, attività della cache, output e, dove separato, ragionamento. Non è un importo diretto di fattura né una misura dei limiti di abbonamento.
Quale interfaccia per quale workflow di architettura?
Codex App è la scelta predefinita più solida per un’indagine interattiva. Quando disegni, screenshot, rapporti e risultati intermedi devono essere valutati insieme con interventi umani regolari, l’app offre il miglior equilibrio tra visibilità, velocità e consegna.
Codex CLI si adatta ai flussi ripetibili: audit standardizzati dei repository, generazione automatica di documentazione, controlli vicini alla CI o quality gate ben definiti. È stata l’interfaccia più veloce del benchmark e ha usato il minor numero di chiamate agli strumenti.
Pi è interessante quando contano soprattutto un livello agentico leggero e adattabile o il volume totale del contesto. Questo può essere utile per stack sperimentali di modelli locali, finestre di contesto limitate o catene di strumenti personalizzate. Il benchmark non ha però utilizzato un modello locale e non dimostra quindi come Pi si comporti con inferenza locale.
OpenCode resta utile per la flessibilità dei provider e come seconda interfaccia indipendente. Ha superato tutti i controlli di qualità, ma non ha mostrato un vantaggio generale di efficienza in queste cinque attività.
La domanda pratica non è quindi “Qual è l’agente migliore?”, ma “Quale attrito deve minimizzare questo workflow?” Per una verifica visiva occasionale di progetto può dominare l’interattività. Per controlli notturni di codice, norme o documentazione, contano di più riproducibilità e durata. Per la sperimentazione locale, budget di contesto ed estensibilità possono essere più importanti della velocità pura.
Limiti e prossimo benchmark
Le cinque attività erano reali e impegnative, ma in sola lettura. Il benchmark misura la qualità della ricerca e l’efficienza operativa, non la correttezza delle modifiche al codice. Non sono ancora stati testati un bug fix mirato con test, una piccola funzionalità multi-file, la riparazione di un test volutamente rotto, un workflow browser con lettura persistente e la ripresa sicura di una sessione interrotta.
Queste attività costituiscono la seconda fase logica. Solo allora potremo capire se i risultati qualitativi quasi identici di oggi rimangono tali quando un agente modifica davvero un sistema e diventa responsabile delle regressioni.
La mia conclusione attuale è pragmatica: Codex App come scelta interattiva predefinita, Codex CLI per l’automazione, Pi per esperimenti orientati ai token e all’harness, OpenCode per flessibilità o una seconda opinione. Pi ha confermato l’aspettativa di un volume totale di token elaborati più basso, ma non gratuitamente: il vantaggio è arrivato con una durata maggiore e molti più passaggi di strumenti.
Altri articoli
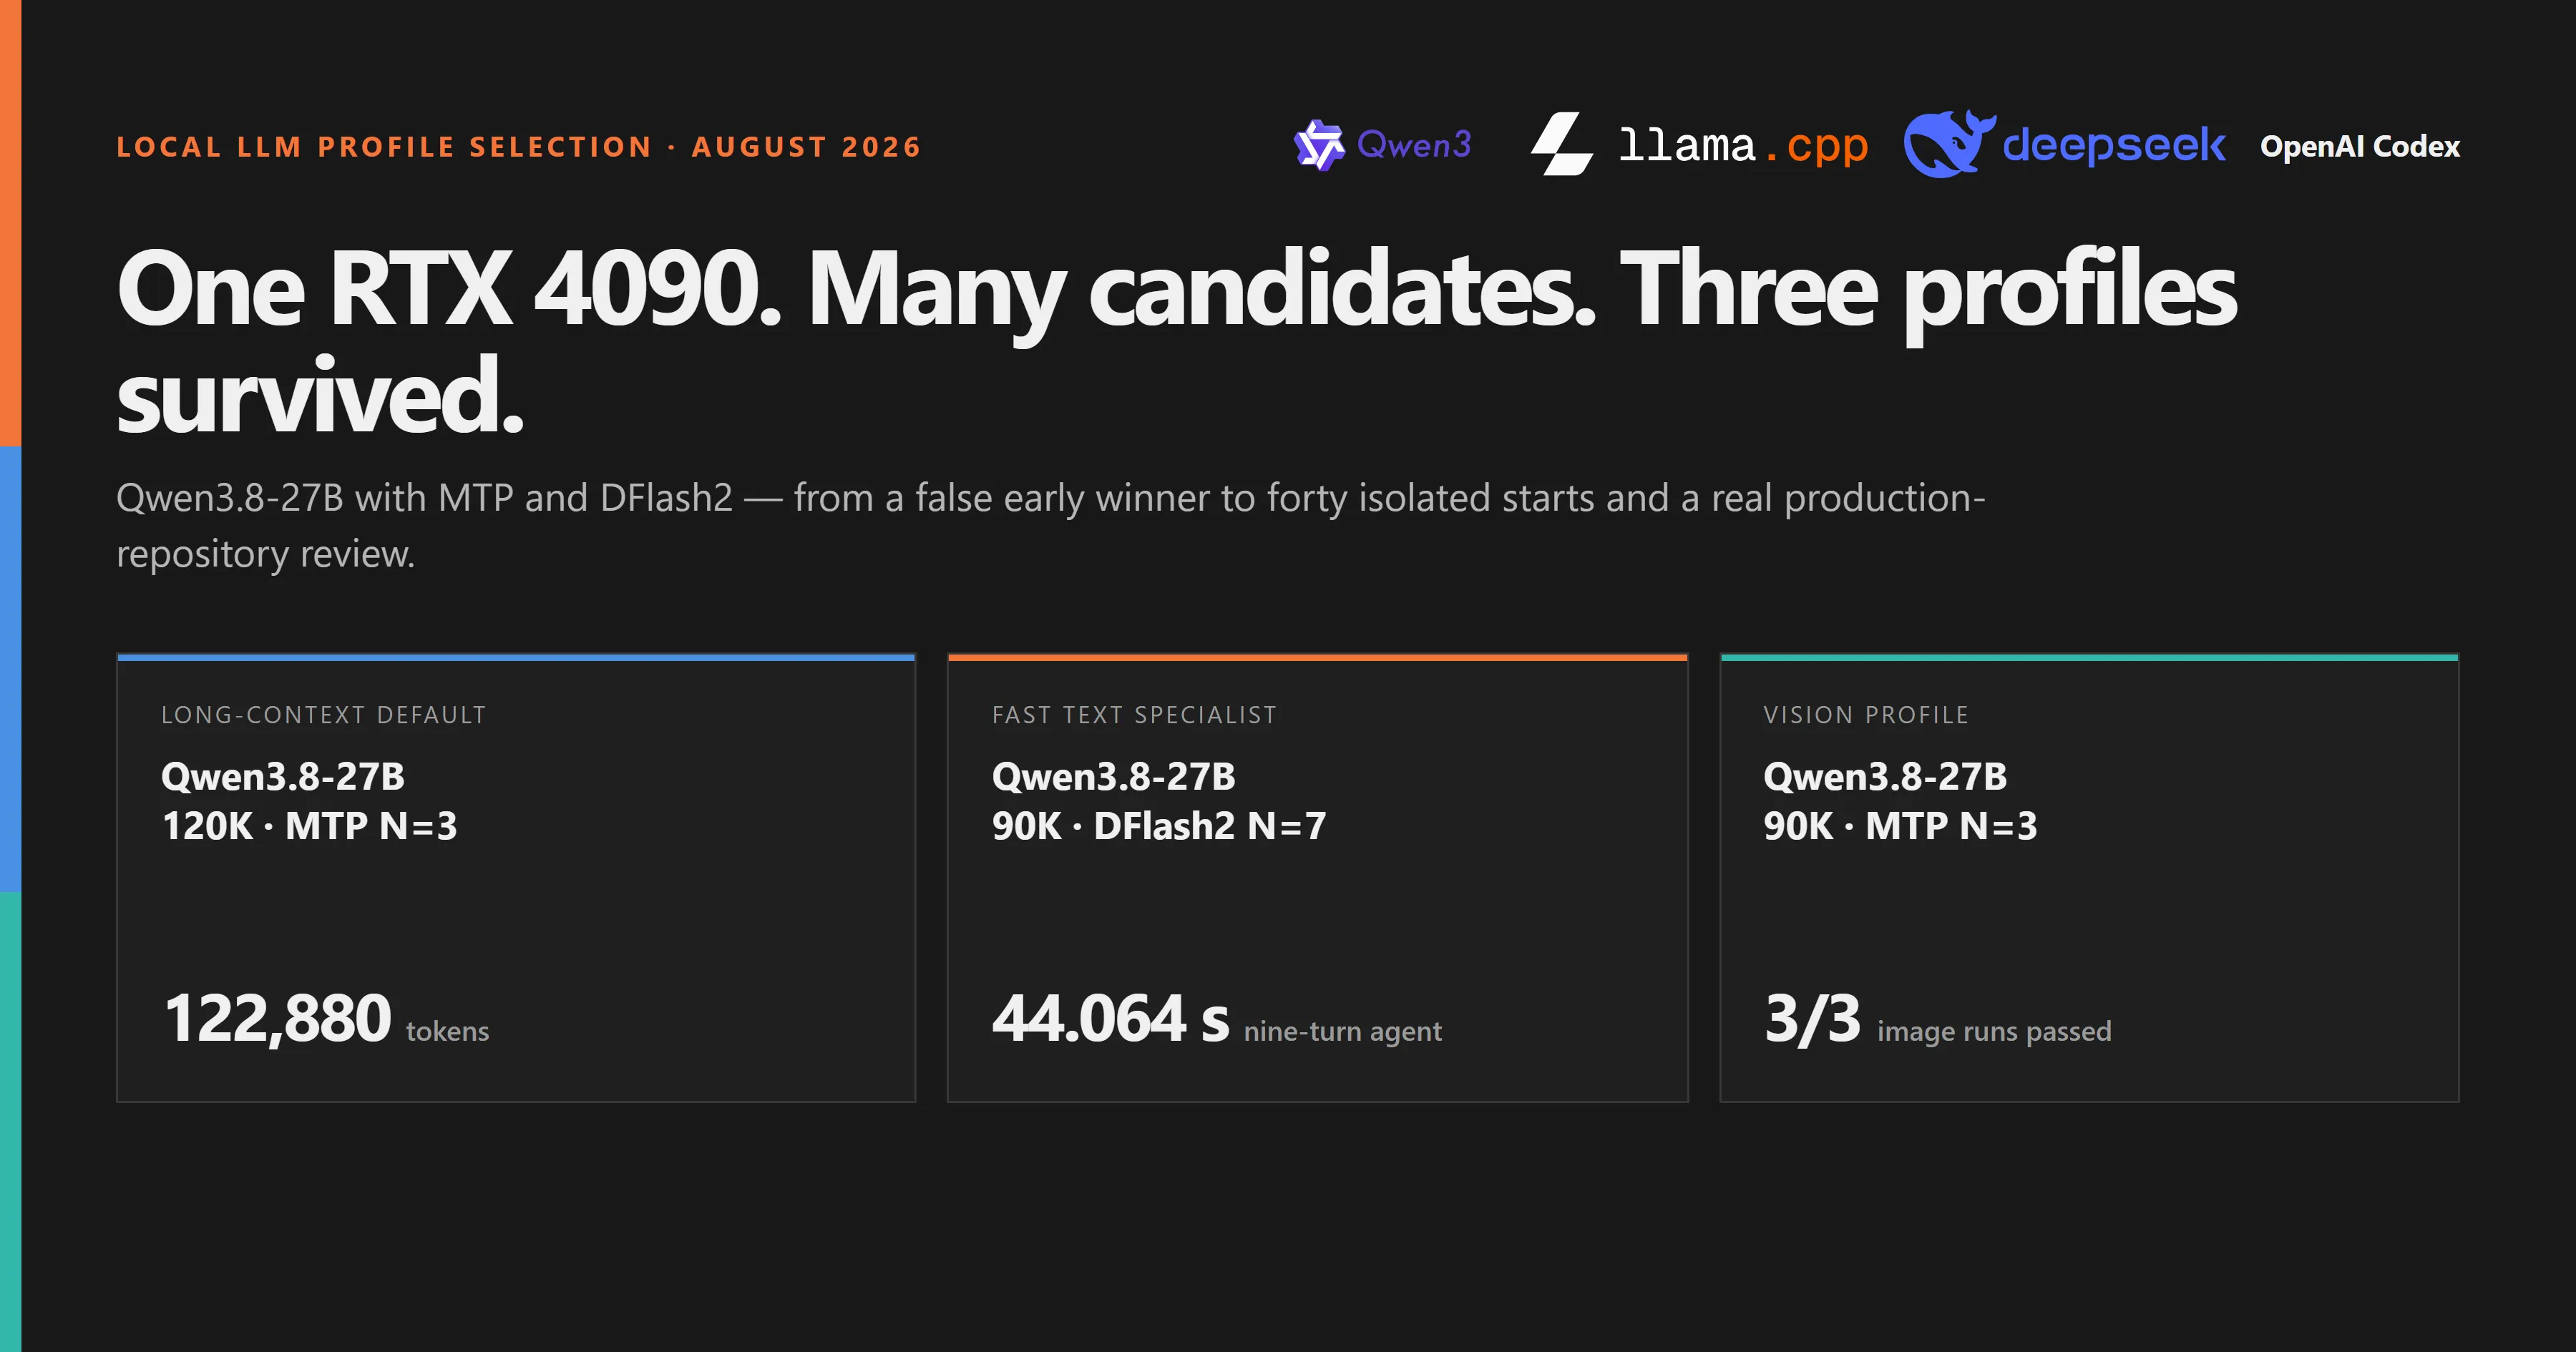
Da molti candidati a tre profili: Qwen3.8-27B con MTP e DFlash2
Su una RTX 4090, i profili MTP e DFlash2 sono stati eliminati fase dopo fase. Il risultato non è un vincitore universale, ma un profilo MTP 120K predefinito, uno specialista testo DFlash2 90K e un profilo vision MTP 90K verificato.
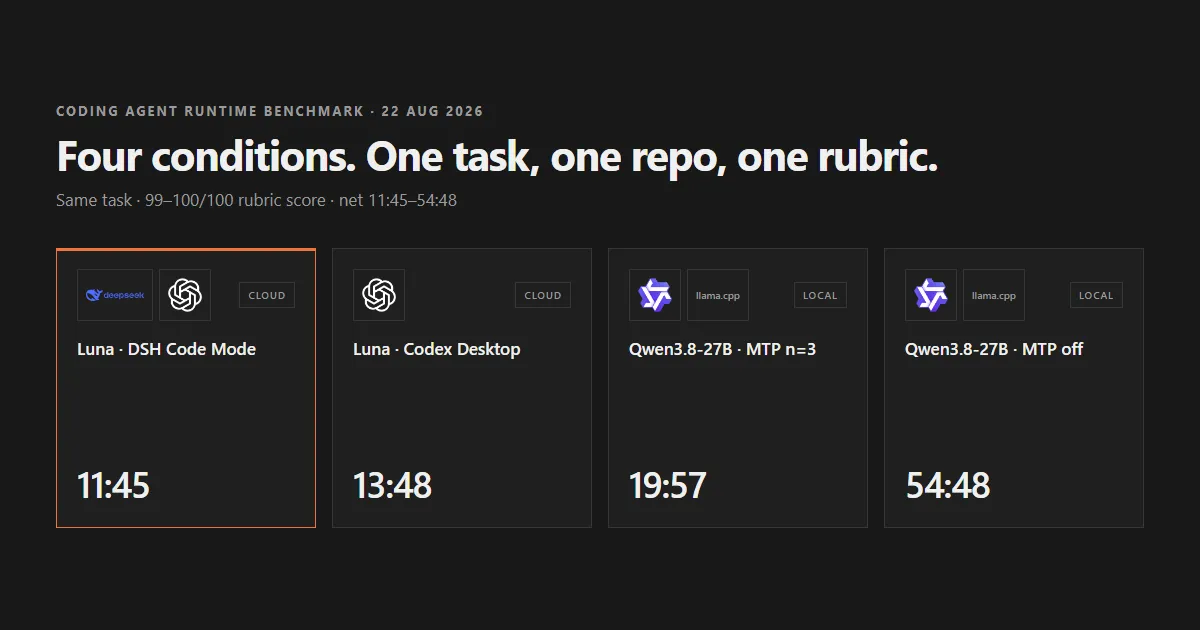
Quattro condizioni, un compito: quanto costano davvero la decodifica speculativa e la scelta dello strumento agente
Quattro condizioni hanno risolto lo stesso compito nello stesso repository e ognuna ha ottenuto 99 o 100 punti su 100. La durata netta del compito — tempo di attesa per l'approvazione e di compattazione automatica del contesto esclusi da ogni misurazione — andava da 11:45 per l'esecuzione cloud tramite modalità standard di DSH a 54:48 per il modello locale senza decodifica speculativa.
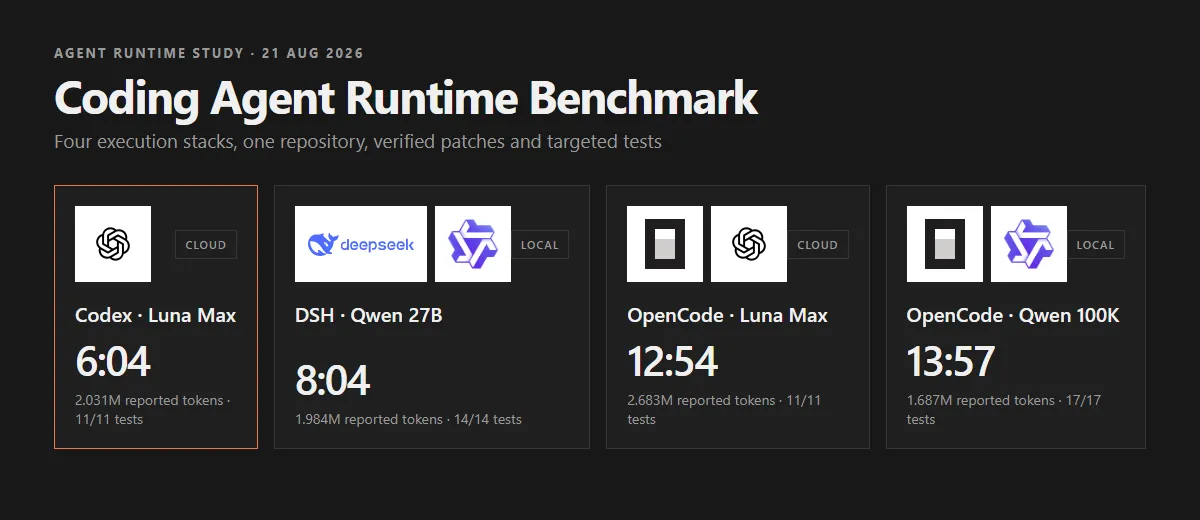
Benchmark degli agenti di codice: l’impatto del runtime
Quattro agenti hanno modificato lo stesso repository e superato i test mirati. La durata variava comunque da 6:04 a 13:57 per l’effetto combinato di modello, harness, cache e revisione.