 Cloud
Luna · DSH Standard Mode
11:45
Benchmark de durée des agents de code
Quatre conditions. Une tâche, un dépôt, une grille d’évaluation.
Même tâche · 99–100/100 points · net 11:45–54:48
Cloud11:45
Cloud13:48
 llama.cppLocal
19:57
llama.cppLocal54:48
Relevé le : 2026-08-22T09:15:00+02:00
Système d’exploitation
Windows 11 Pro
CPU
AMD Ryzen 9 7950X
Cœurs
16C/32T
RAM
128 GB
GPU / VRAM
NVIDIA GeForce RTX 4090 / 24 GB
Pilote GPU
610.88
| Exécution | Runtime | Modèle | Format / quantification | Contexte / cache KV | Backend |
|---|---|---|---|---|---|
| Qwen3.8-27B · MTP off (Local) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-UD-Q4_K_XL.gguf (spec. decoding: none) | GGUF / UD-Q4_K_XL | 131072 tokens (128K) / Q8 (q8_0 K, q8_0 V) | llama.cpp llama-server 0.1.0-rc.8 |
| Qwen3.8-27B · MTP n=3 (Local) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-UD-Q4_K_XL.gguf (spec. decoding: draft-mtp, n=3) | GGUF / UD-Q4_K_XL | 131072 tokens (128K) / Q8 (q8_0 K, q8_0 V) | llama.cpp llama-server 0.1.0-rc.8 |
| Luna · DSH Standard Mode (Cloud) | DeepSeek Harness (dsh), openai-codex provider, 0.1.0-rc.8 | gpt-5.6-luna (reasoning effort: max) | non communiqué par le fournisseur | 272000 tokens / non communiqué par le fournisseur | non communiqué par le fournisseur |
| Luna · Codex Desktop (Cloud) | Codex Desktop 0.149.0-alpha.4.1 | gpt-5.6-luna (reasoning effort: max) | non communiqué par le fournisseur | 258400 tokens / non communiqué par le fournisseur | non communiqué par le fournisseur |
Les valeurs par exécution proviennent de l’export propre à chaque session (en-têtes de session DSH, ou export de token-usage/rollout propre à Codex Desktop) ; le matériel a été revérifié sur la même machine le 22.08.2026.
Les deux exécutions cloud déclarent, dans leurs propres en-têtes de session, des fenêtres de contexte différentes (272 000 contre 258 400 tokens) pour le même modèle, ce qui reflète probablement des chemins de fournisseur/routage différents plutôt qu’une réelle différence de modèle.
Quatre conditions · 99–100/100 points
Ce que contient réellement la durée brute de session
Deux des trois composantes ci-dessous n'ont rien à voir avec le travail effectif du modèle.
Modèle, outils et orchestration effectuant réellement le travail
Temps de réaction humain à une demande d'escalade du bac à sable
L'appel de résumé automatique de l'outil une fois le contexte plein, sans intervention humaine
Moins est préférable · minutes, corrigées de l'attente d'approbation et du compactage
Composition de la durée brute ; le temps net de la tâche est ce qui reste
Plus est préférable · tokens de sortie par seconde, net de la correction
Comptabilité propre à chaque système ; pas une unité commune entre local et cloud (voir limites)
Nombre d'appels d'outils distincts ; aucune direction n'est intrinsèquement meilleure
Plus est préférable · sur 100, noté par un reviewer ayant lu le diff et exécuté la vérification
| Condition | Exactitude /45 | Tests /20 | Robustesse /15 | Maintenabilité /10 | Portée /10 | Total |
|---|---|---|---|---|---|---|
| Luna · DSH Standard Mode | 45 | 20 | 15 | 10 | 10 | 100 |
| Luna · Codex Desktop | 44 | 20 | 15 | 10 | 10 | 99 |
| Qwen3.8-27B · MTP n=3 | 45 | 20 | 15 | 9 | 10 | 99 |
| Qwen3.8-27B · MTP off | 45 | 20 | 15 | 10 | 10 | 100 |
Quatre copies indépendantes et isolées du même dépôt Cloudflare Worker ont reçu la même tâche, sur le même commit : ajouter un registre D1 durable pour qu'une mise à jour de webhook Telegram ne soit jamais planifiée deux fois, même en cas de doublons concurrents ou d'une erreur de base de données transitoire et ambiguë, plus une tâche de 14 jours qui ne purge que les lignes terminales. Quatre conditions l'ont exécutée : un Qwen3.8-27B local avec décodage spéculatif désactivé, le même modèle avec décodage spéculatif activé (draft-mtp, n=3), et un GPT-5.6 « Luna » hébergé au niveau de raisonnement « max » via deux outils d'agent différents, le mode standard de DSH et l'application Codex Desktop d'OpenAI elle-même. Un reviewer indépendant a ensuite noté chaque soumission selon la même grille de 100 points en lisant le diff, en exécutant lui-même `type-check` et la suite de tests, et en vérifiant une à une les 11 scénarios de test requis.
Les quatre ont obtenu 99 ou 100 points sur 100. La qualité du code n'était donc pas ce qui distinguait les quatre conditions sur cette tâche — c'était la durée nette de la tâche. Pour chaque condition, le temps d'attente d'approbation et le compactage automatique du contexte ont été exclus du temps mesuré, ces deux éléments étant du surcoût, pas du travail du modèle ; toutes les durées ci-dessous sont déjà des valeurs nettes.
Le mode standard de DSH déclenche une demande d'escalade du bac à sable (par exemple pour permettre au chargeur de configuration de Vitest de lancer un processus enfant) et attend qu'un humain clique sur « autoriser » ; l'écart entre cette demande et le clic est un temps de réaction pur, pas du travail d'agent, et a été exclu de la mesure. Par ailleurs, une fois la fenêtre de contexte pleine, DSH déclenche de sa propre initiative un appel de résumé automatique, sans intervention humaine, mais cela consomme tout de même de vraies minutes — ce temps est également exclu.
Un seul clic d'approbation représentait à lui seul 11:53 exclues de l'exécution DSH+Luna. Le temps net de la tâche pour le mode standard de DSH + Luna est de 11:45 — devant les 13:48 de Codex Desktop, qui n'a déclenché aucune demande d'approbation comparable. Le même calcul s'applique aux deux exécutions locales de Qwen : MTP désactivé a eu 5:54 exclues sur deux compactages automatiques, MTP n=3 seulement 1:42 exclues sur un seul.
Le temps net de la tâche pour le modèle local identique est passé de 54:48 avec décodage spéculatif désactivé à 19:57 avec décodage activé — 2,7 fois plus rapide, avec un débit de sortie passant de 33,8 à 55,5 tokens par seconde. Le nombre d'appels d'outils a évolué dans l'autre sens : MTP désactivé a nécessité 93 appels pour atteindre le même résultat, MTP n=3 seulement 61. Aucun de ces chiffres n'est une estimation ; les deux proviennent directement des événements d'appels d'outils de la session DSH.
Non. Chaque soumission a réussi `type-check` et sa suite de tests complète, couvert les 11 scénarios de test requis avec des assertions comportementales plutôt qu'une simple comparaison de chaînes SQL, et implémenté correctement la partie la plus difficile de la spécification : une réclamation SQL atomique (`INSERT ... ON CONFLICT`) avec le même jeton de réclamation réutilisé à travers les tentatives, de sorte qu'une relecture après une réponse perdue puis une nouvelle tentative soit reconnue comme la propre réclamation réussie de l'appelant plutôt que comme un doublon. Personne n'a touché à un fichier interdit, ajouté de dépendance, ni montré le moindre signe de délégation. Les deux retraits d'un point étaient tous deux de simples points de placement — la purge de rétention déclenchée à chaque webhook accepté au lieu de passer par le déclencheur cron existant, et une fonction de finalisation qui a légèrement dépassé la consigne « garder la route petite » de la tâche — et non des bugs de comportement.
Un reviewer, travaillant sur la soumission Luna/Codex Desktop, a repéré quelque chose que la grille ne note pas. Cette soumission génère un nouveau jeton de réclamation à chaque invocation du Worker au lieu de le dériver de manière déterministe de l'identifiant de mise à jour. Si chaque tentative dans la boucle de nouvelle tentative d'une même livraison signale une erreur transitoire à l'appelant, alors qu'une de ces tentatives a en réalité validé silencieusement, la ligne reste dans l'état « processing » sous un jeton qu'aucune requête future ne connaît. Une nouvelle livraison Telegram est une nouvelle requête HTTP avec un jeton nouvellement généré ; elle lit le jeton désormais différent de la ligne existante, le traite comme la réclamation de quelqu'un d'autre, et la mise à jour peut rester bloquée définitivement. Comme la rétention ne purge que les lignes terminales, elle n'est jamais non plus nettoyée. Cela n'a pas été revérifié indépendamment sur le code exact de génération de jeton des trois autres implémentations ; considérez-le donc comme une question à examiner de plus près sur les quatre, pas comme un défaut confirmé sur une seule.
Il s'agit d'une seule répétition par condition, un essai pilote. Le manifeste du benchmark lui-même recommande au moins trois répétitions par condition avec un ordre nouvellement randomisé avant de considérer un classement comme définitif. La comptabilité des tokens locale et cloud n'est pas une unité commune : DSH additionne l'entrée nouvelle, la sortie et les lectures de cache comme trois compteurs additifs distincts, tandis que Codex Desktop déclare un compteur d'entrée cumulatif dans lequel l'entrée mise en cache est déjà un sous-ensemble ; ne calculez donc pas de ratio à travers cette frontière. Les tokens de sortie par seconde constituent une mesure du temps jusqu'au résultat utile, pas un benchmark isolé de vitesse de décodage : cela inclut le temps d'exécution des outils pour chaque exécution ainsi que la mise en file d'attente réseau et API pour les deux exécutions cloud. Les deux exécutions cloud déclarent, dans leurs propres en-têtes de session, des fenêtres de contexte différentes pour le modèle identique, ce qui n'a pas été résolu de manière indépendante et pourrait refléter des chemins de routage différents chez le fournisseur plutôt qu'une réelle différence de modèle. Le risque de ligne bloquée décrit ci-dessus a été identifié dans une soumission et n'a pas été vérifié indépendamment sur le code exact de génération de jeton des trois autres.
Le résultat propre de ce test est la comparaison du décodage spéculatif : même modèle, même matériel, un seul paramètre changé, un écart de 2,7 fois sans coût de qualité dans cette exécution. Le résultat plus confus est la comparaison des outils d'agent : le mode standard de DSH et Codex Desktop ont produit une quantité nettement différente de surcoût hors tâche sur le même modèle effectuant le même travail, et ce surcoût était invisible tant que les journaux de session n'avaient pas été lus événement par événement. Avant de faire confiance à l'un ou l'autre chiffre comme une propriété de l'outil plutôt que de cette seule exécution, il faudrait trois répétitions par condition avec un ordre randomisé, et idéalement une logique d'approbation qui ne place pas le temps de réaction d'un humain au milieu d'une escalade de bac à sable routinière.
Les mesures ont été reconstruites à partir de quatre exports de session conservés : trois fichiers `session.jsonl` de DSH ainsi que l'export de token-usage et de rollout de la CLI Codex Desktop.
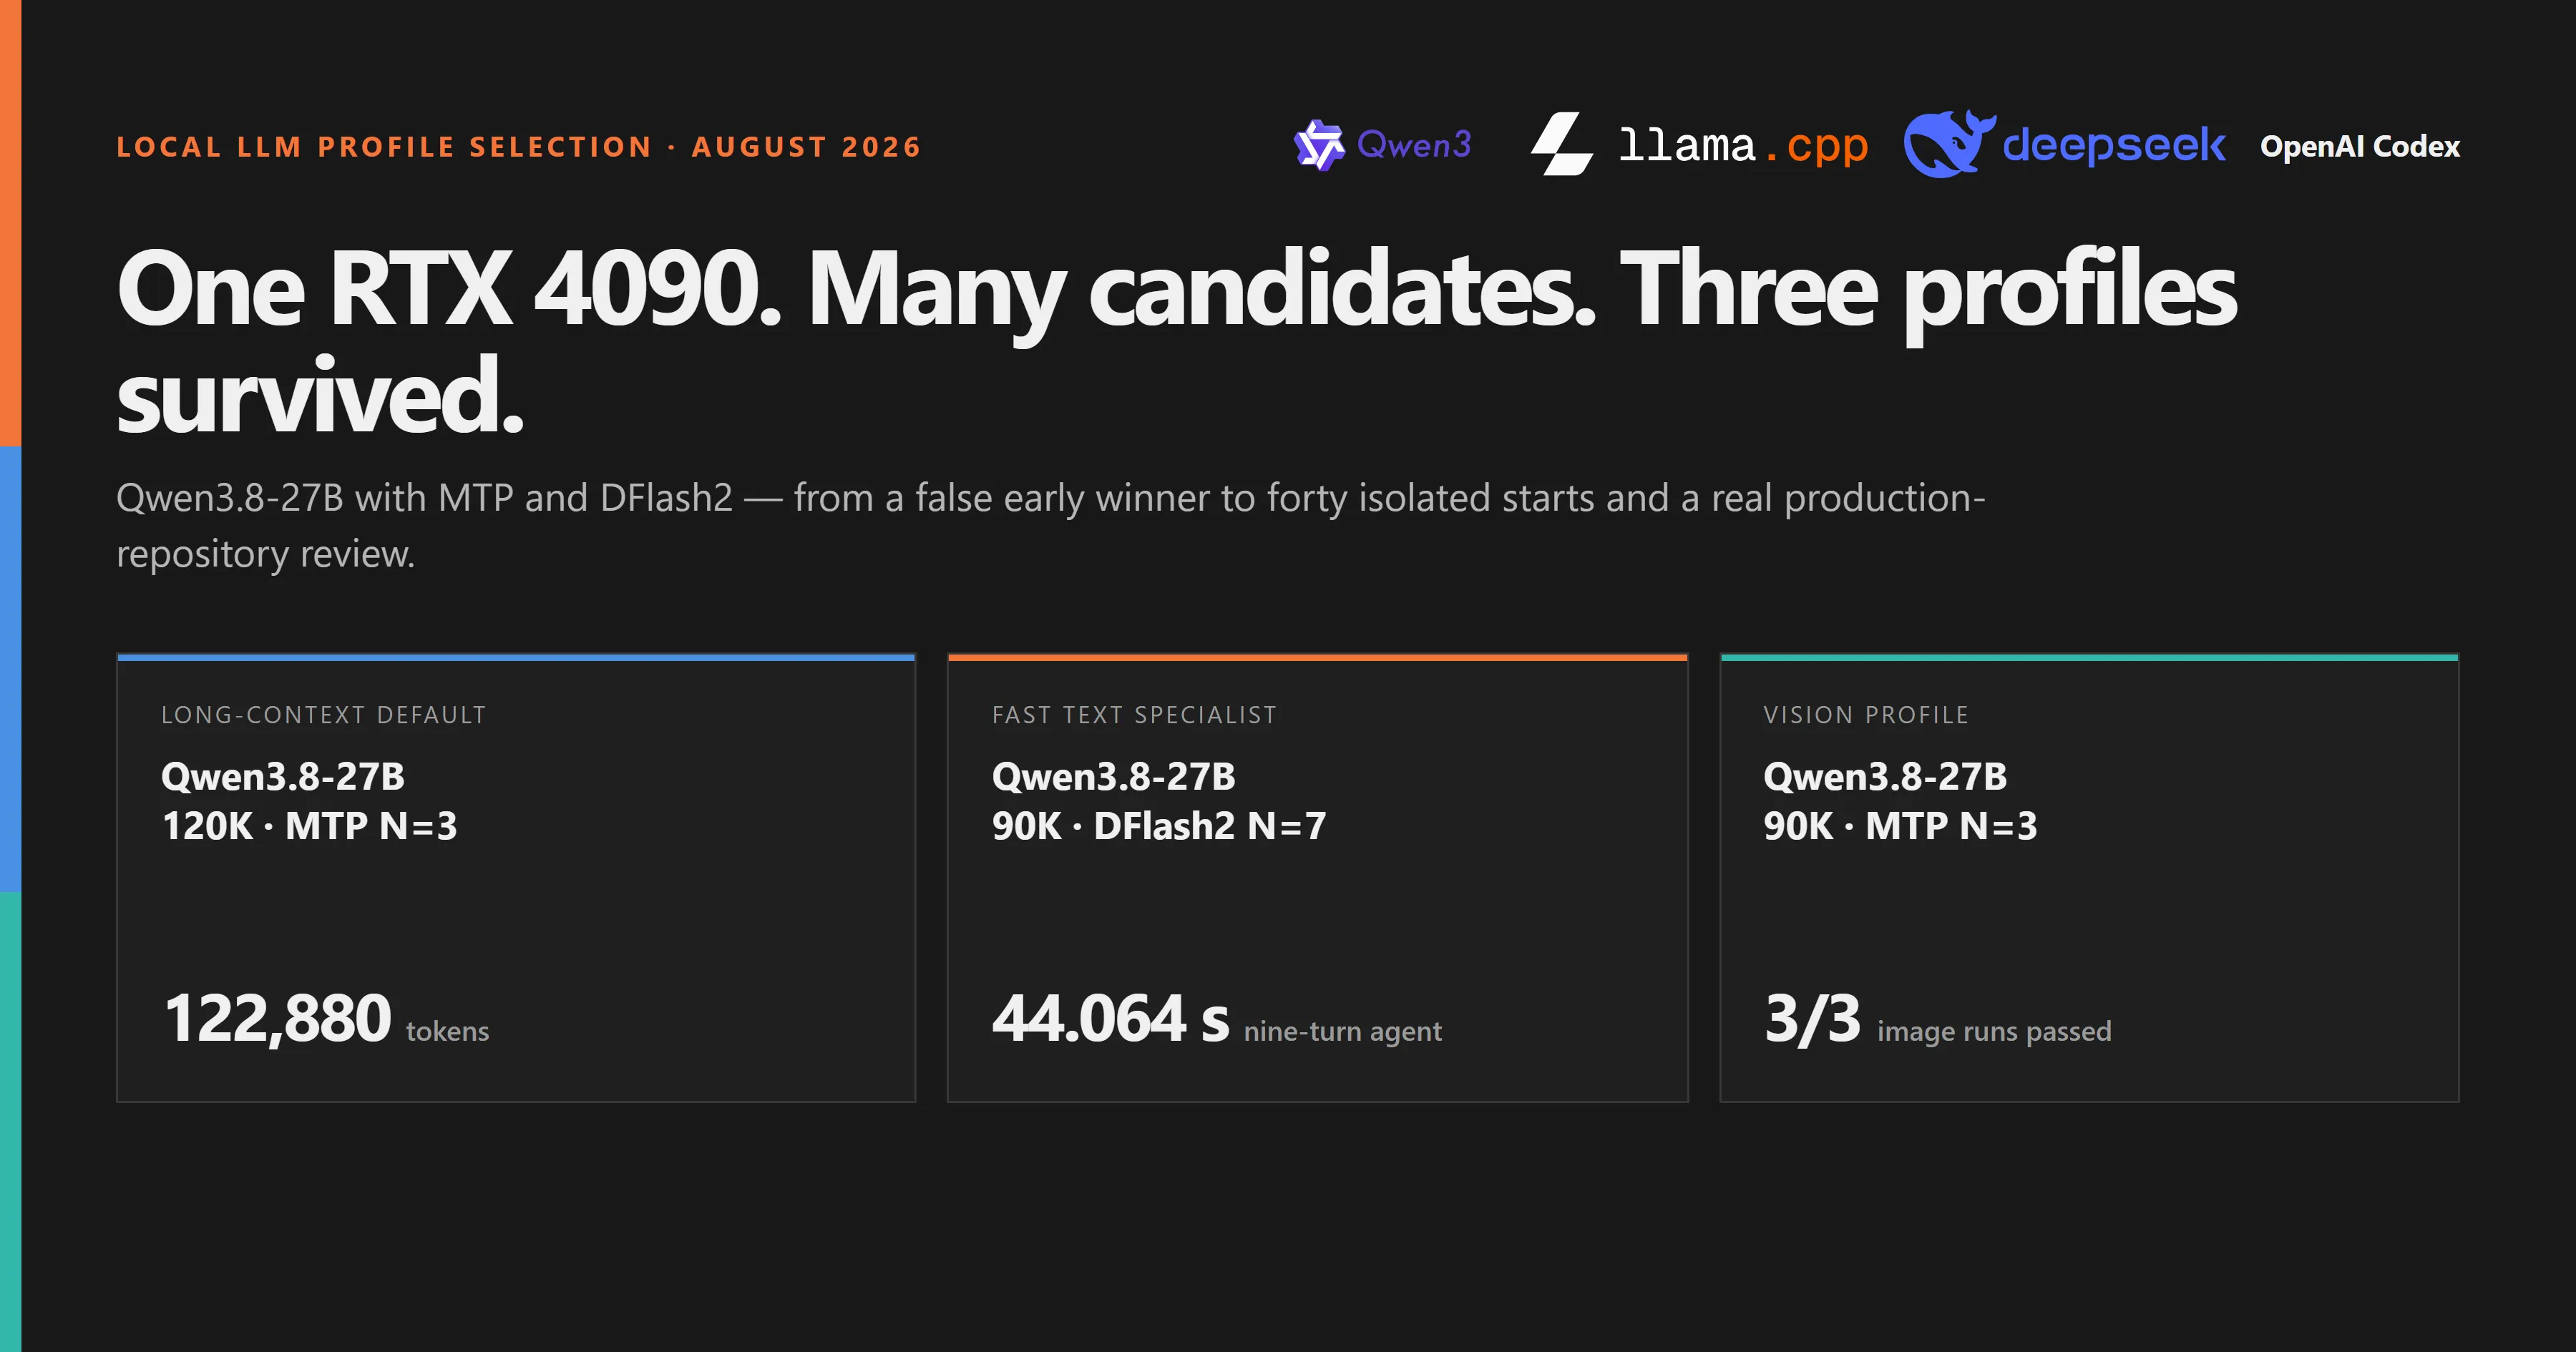
De nombreux candidats à trois profils : Qwen3.8-27B avec MTP et DFlash2
Sur une RTX 4090, les profils MTP et DFlash2 ont été éliminés étape par étape. Le résultat n'est pas un vainqueur universel, mais un profil MTP 120K par défaut, un spécialiste texte DFlash2 90K et un profil vision MTP 90K vérifié.
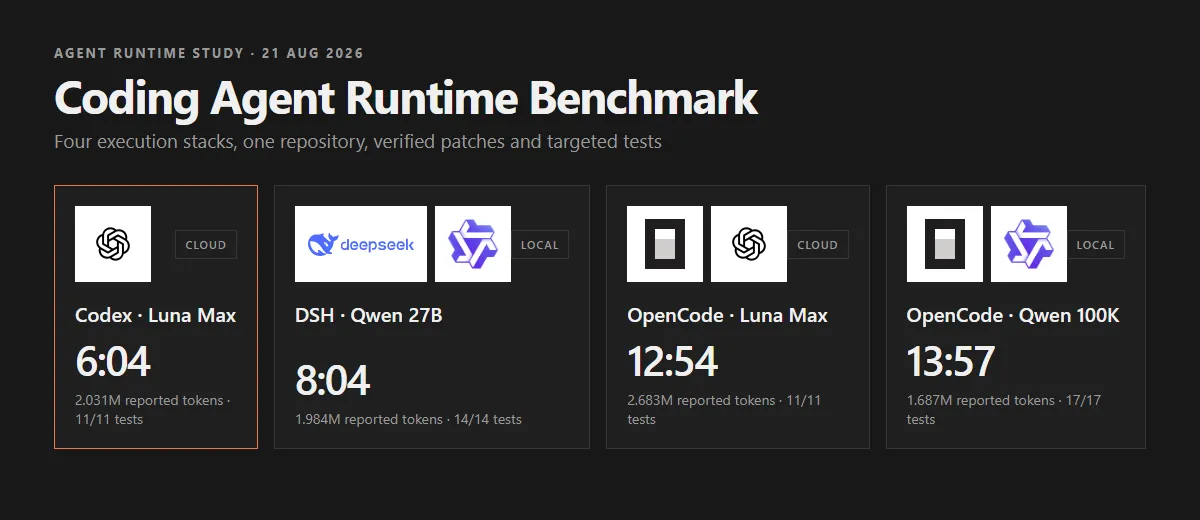
Benchmark d’agents de code : l’impact de la couche d’exécution
Quatre agents ont modifié le même dépôt et réussi leurs tests ciblés. La durée variait pourtant de 6:04 à 13:57, car modèle, harness, cache et revue agissaient ensemble.
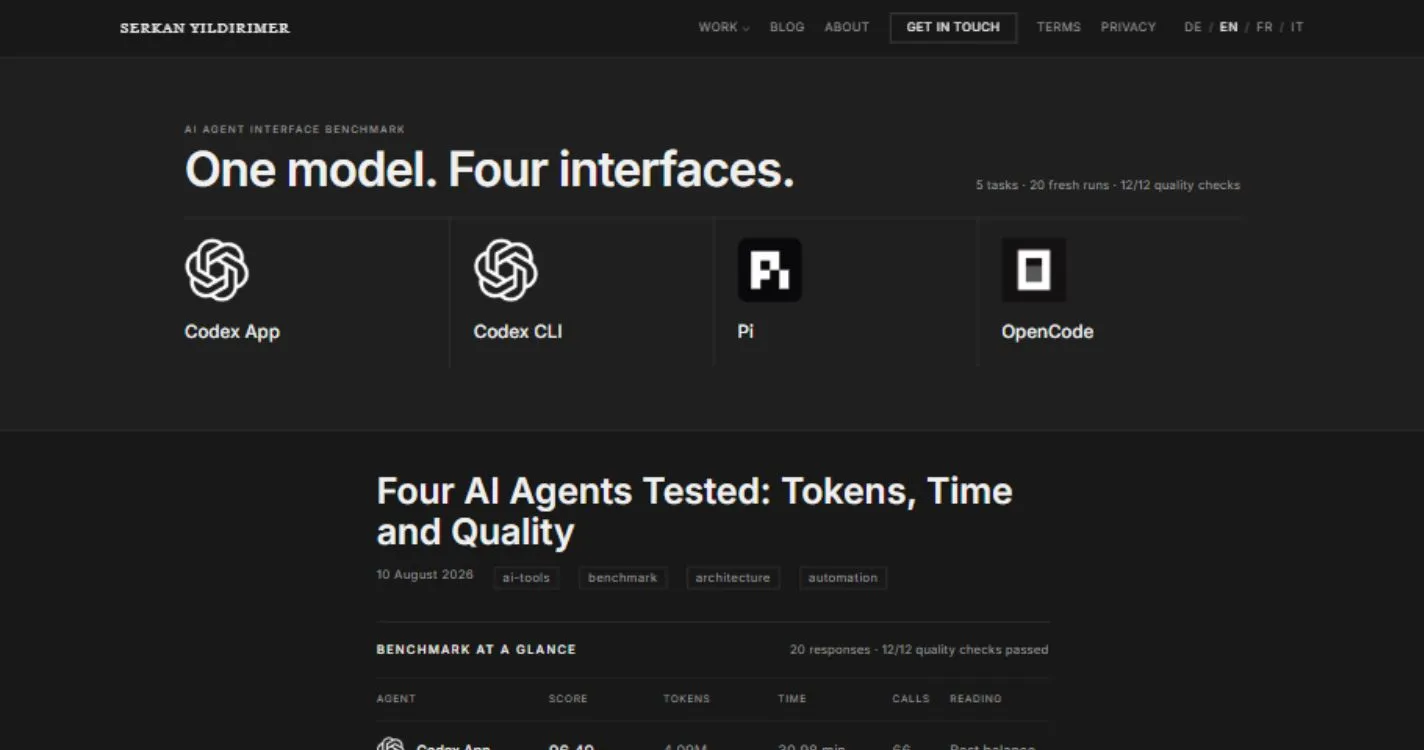
Quatre agents IA testés : tokens, temps et qualité
Le même modèle d’IA, quatre interfaces d’agents et cinq tâches réelles sur des dépôts : les écarts mesurés en qualité, tokens, durée et méthode de travail.