
Claude Haiku vs. DeepSeek V4 pour la rédaction de propositions IA : ce qui a vraiment fonctionné en production
Je fais tourner un pipeline assisté par IA pour rédiger mes propositions freelance : il lit une offre de mission, extrait les questions clés du client et rédige une proposition en trois étapes — Détails, Questions et Proposition. Claude Haiku est le modèle derrière ces trois étapes depuis que j'ai construit ce pipeline.
Les modèles d'IA sont sans cesse comparés sur leur « intelligence » — profondeur de raisonnement, scores de benchmarks, vitesse de « réflexion » — mais les résultats concordent rarement entre eux, et rien de tout cela ne me dit si un modèle tiendra réellement la route dans mon propre pipeline, sur mes propres missions, avec mes propres contraintes de coût. Les modèles à fort raisonnement apparaissent de plus en plus dans ce type de flux de travail — rédaction de propositions, réponses aux questions d'appels d'offres, travail de rédaction derrière une offre. Je voulais donc une vraie réponse, pas un argument marketing.
Alors, plutôt que de me fier à un benchmark, j'ai fait tourner la comparaison en conditions réelles.
Le test
J'ai sélectionné trois missions freelance réelles et actuellement ouvertes dans ma propre file d'attente — un rendu pour un centre commercial, une refonte de plan architectural et une visualisation de procédé pour une scierie (la description la plus longue et la plus complexe des trois, environ 3 000 caractères). Chaque mission a suivi l'intégralité du pipeline — Détails, extraction des questions et génération de la proposition — trois fois : une fois avec Claude Haiku (le modèle par défaut en production), une fois avec DeepSeek V4 Pro en effort de raisonnement maximal, et une fois avec DeepSeek V4 Flash, également en effort de raisonnement maximal. Mêmes prompts à chaque fois, pas de doublons recopiés à la main. Neuf exécutions au total.
L'API de DeepSeek n'expose que high et max comme valeurs réelles d'effort de raisonnement — il n'existe pas de véritable réglage « X-High », j'ai donc utilisé max tout du long.
Ce qui s'est passé
Claude Haiku n'a eu aucun échec sur les neuf exécutions et a terminé de 3 à 10 fois plus vite que chacune des deux variantes de DeepSeek, de bout en bout.
DeepSeek V4 Pro en raisonnement maximal n'était pas assez fiable pour envisager un remplacement. Sur la mission de la scierie — la plus longue des trois — la seule étape Détails a pris 67 secondes, et l'extraction des questions a totalement atteint son délai d'expiration, sans aucune question détectée. Ce n'était pas vraiment moins cher non plus : sur un appel Détails échantillonné, 1 951 des 2 151 tokens de sortie étaient des tokens de raisonnement invisibles, et non le résumé réellement utilisé par le pipeline.
DeepSeek V4 Flash a donné le résultat le plus intéressant. C'était clairement l'option la moins chère, à environ un tiers du coût par mission de Haiku, mais il restait tout de même 3 à 5 fois plus lent de bout en bout et a connu son propre délai d'expiration lors de la génération d'une réponse, dans ce petit échantillon.
Limites
Trois missions et trois modèles, cela fait neuf exécutions — pas un benchmark à grande échelle. La tendance de ces résultats est plus fiable que les multiplicateurs exacts. L'API de DeepSeek ne propose pas de véritable réglage de raisonnement « X-High », d'où l'utilisation de max en remplacement. Et il s'agissait d'un diagnostic de production interne sur mon propre pipeline, pas d'une comparaison publiée ou évaluée par des pairs.
Ce que j'en fais
Claude Haiku reste le modèle par défaut en production. Aucune des deux variantes de DeepSeek ne m'a donné de raison de changer — Pro était plus lent, pas vraiment moins cher en pratique, et a justement échoué sur la mission qui le mettait le plus à l'épreuve ; Flash était bon marché mais restait trop lent et pas totalement fiable à cette taille d'échantillon.
Si le coût devenait un jour une contrainte déterminante, DeepSeek V4 Flash serait le modèle que je réexaminerais — un tiers du prix, c'est une vraie différence. Mais il faudrait un échantillon bien plus large avant de lui faire confiance sur une mission destinée à un client. Pour l'instant, c'est la réponse la moins spectaculaire qui l'emporte : le modèle que j'utilisais déjà en production reste le bon choix.
D'autres articles
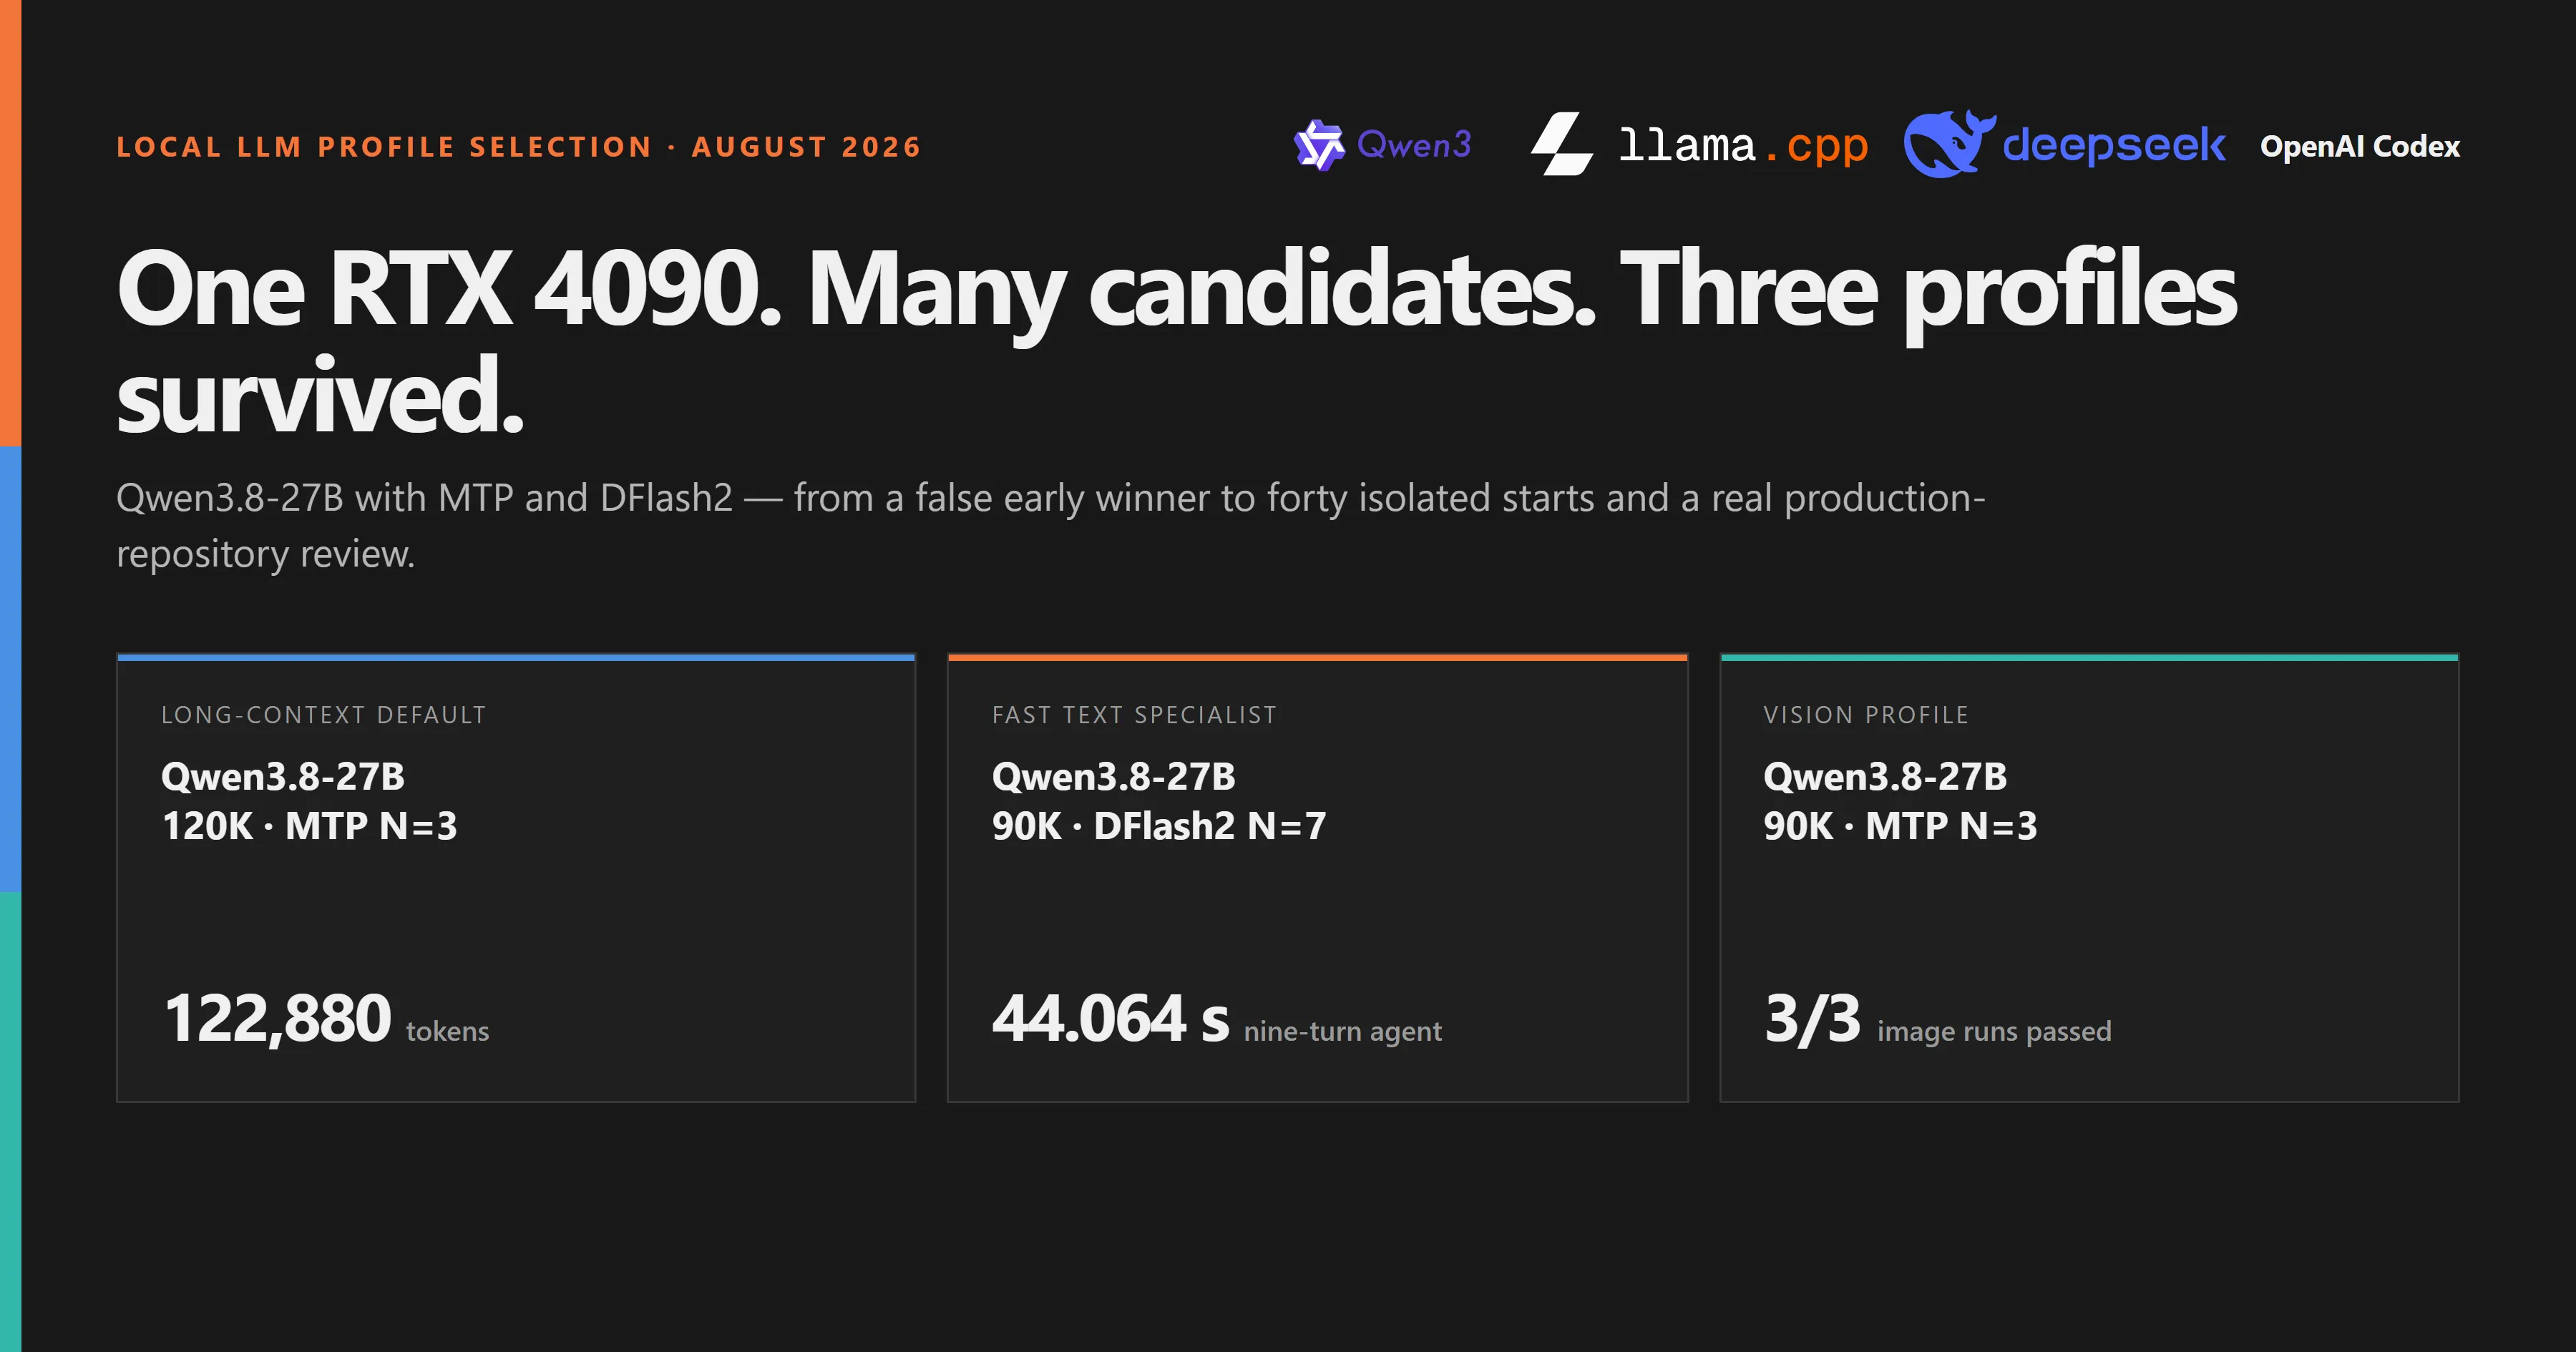
De nombreux candidats à trois profils : Qwen3.8-27B avec MTP et DFlash2
Sur une RTX 4090, les profils MTP et DFlash2 ont été éliminés étape par étape. Le résultat n'est pas un vainqueur universel, mais un profil MTP 120K par défaut, un spécialiste texte DFlash2 90K et un profil vision MTP 90K vérifié.
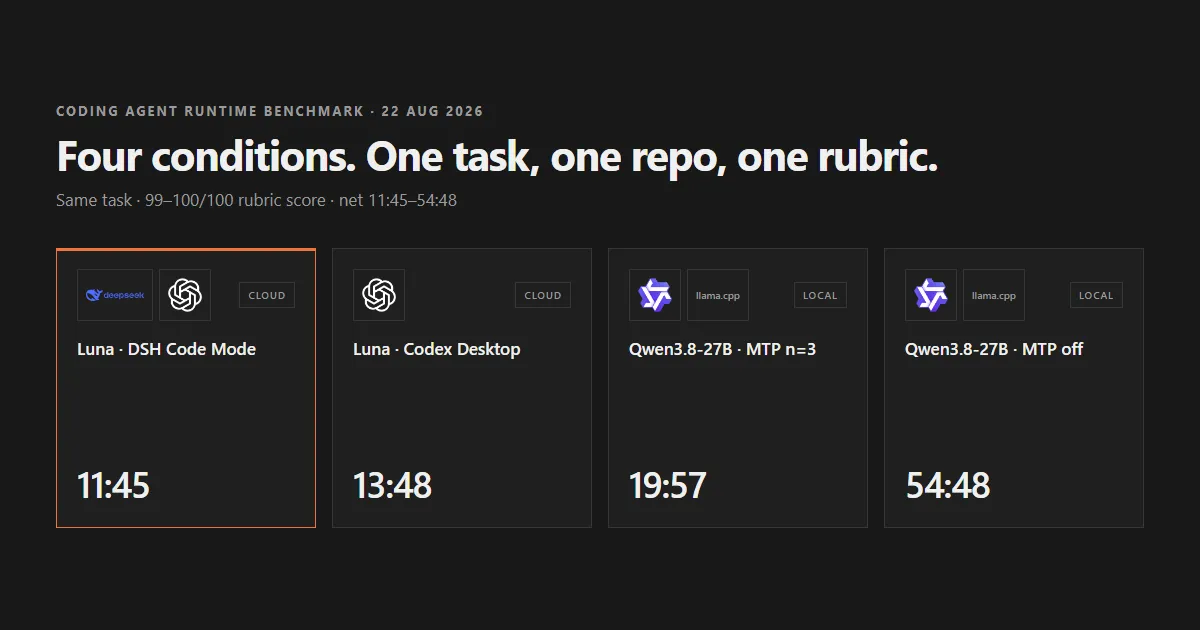
Quatre conditions, une tâche : ce que coûtent vraiment le décodage spéculatif et le choix de l'outil d'agent
Quatre conditions ont résolu la même tâche dans le même dépôt et ont toutes obtenu 99 ou 100 points sur 100. La durée nette de la tâche — temps d'attente d'approbation et de compactage automatique du contexte exclus de chaque mesure — allait de 11:45 pour l'exécution cloud via le mode standard de DSH à 54:48 pour le modèle local sans décodage spéculatif.
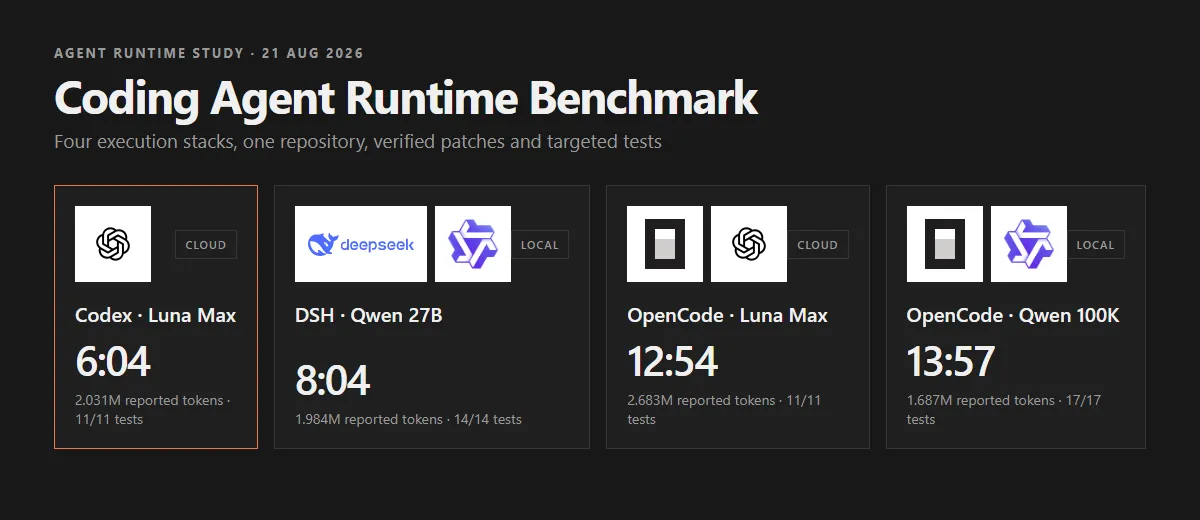
Benchmark d’agents de code : l’impact de la couche d’exécution
Quatre agents ont modifié le même dépôt et réussi leurs tests ciblés. La durée variait pourtant de 6:04 à 13:57, car modèle, harness, cache et revue agissaient ensemble.