
Claude Haiku vs. DeepSeek V4 für KI-Angebotstexte: Was sich in der Praxis bewährt hat
Ich betreibe für meine Freelance-Arbeit eine KI-gestützte Pipeline zur Angebotserstellung: Sie liest eine Stellenausschreibung, extrahiert die wichtigsten Fragen des Auftraggebers und erstellt in drei Schritten ein Angebot – Details, Fragen und Angebotstext. Seit ich die Pipeline gebaut habe, läuft dabei in allen drei Schritten Claude Haiku im Hintergrund.
KI-Modelle werden ständig anhand ihrer „Intelligenz" verglichen – Denktiefe, Benchmark-Werte, wie schnell sie „denken" – aber die Ergebnisse stimmen selten überein, und keiner dieser Werte sagt mir, ob ein Modell in meiner eigenen Pipeline, bei meinen eigenen Aufträgen und unter meinen eigenen Kostenvorgaben tatsächlich standhält. Gerade reasoning-lastige Modelle tauchen zunehmend in genau solchen Arbeitsabläufen auf – beim Verfassen von Angeboten, bei der Beantwortung von Ausschreibungsfragen, bei der eigentlichen Schreibarbeit hinter einem Gebot. Deshalb wollte ich eine echte Antwort statt einer Marketingaussage.
Also habe ich den Vergleich live laufen lassen, statt einem Benchmark zu vertrauen.
Der Test
Ich habe drei reale, aktuell offene Aufträge aus meiner eigenen Warteschlange ausgewählt – einen Rendering-Auftrag für ein Einkaufszentrum, eine Neugestaltung eines Grundrisses und eine Prozessvisualisierung für ein Sägewerk (die längste und komplexeste Beschreibung der drei, mit rund 3.000 Zeichen). Jeder Auftrag durchlief die komplette Pipeline – Details, Fragenextraktion und Angebotserstellung – dreimal: einmal mit Claude Haiku (dem aktuellen Produktions-Standard), einmal mit DeepSeek V4 Pro bei maximalem Reasoning-Aufwand und einmal mit DeepSeek V4 Flash, ebenfalls bei maximalem Reasoning-Aufwand. Jedes Mal dieselben Prompts, keine von Hand kopierten Duplikate. Neun Durchläufe insgesamt.
Die API von DeepSeek kennt nur high und max als tatsächliche Reasoning-Werte – ein echtes „X-High" gibt es nicht, also habe ich durchgehend max verwendet.
Was passiert ist
Claude Haiku hatte über alle neun Durchläufe hinweg keinen einzigen Fehlschlag und war Ende-zu-Ende 3- bis 10-mal schneller als jede der beiden DeepSeek-Varianten.
DeepSeek V4 Pro bei maximalem Reasoning war nicht zuverlässig genug für einen Wechsel. Beim Sägewerk-Auftrag – dem längsten der drei – brauchte allein der Details-Schritt 67 Sekunden, und die Fragenextraktion lief komplett ins Timeout, ohne eine einzige erkannte Frage. Günstiger war es dabei auch nicht wirklich: In einem stichprobenartig geprüften Details-Aufruf waren 1.951 von 2.151 Output-Tokens unsichtbare Reasoning-Tokens – nicht die Zusammenfassung, die die Pipeline tatsächlich nutzt.
DeepSeek V4 Flash war das interessantere Ergebnis. Mit rund einem Drittel der Kosten pro Auftrag im Vergleich zu Haiku war es klar die günstigste Option, blieb aber Ende-zu-Ende trotzdem 3- bis 5-mal langsamer und hatte in dieser kleinen Stichprobe einen eigenen Timeout bei der Antwortgenerierung.
Einschränkungen
Drei Aufträge und drei Modelle ergeben neun Durchläufe – kein groß angelegter Benchmark. Die Richtung der Ergebnisse ist vertrauenswürdiger als die exakten Multiplikatoren. Die API von DeepSeek bietet keinen echten „X-High"-Wert, weshalb hier durchgehend max als Ersatz diente. Und das Ganze war ein interner Produktionstest an meiner eigenen Pipeline, keine veröffentlichte oder begutachtete Vergleichsstudie.
Was ich daraus mache
Claude Haiku bleibt der Produktions-Standard. Keine der beiden DeepSeek-Varianten hat mir einen Grund zum Wechsel geliefert – Pro war langsamer, in der Praxis nicht günstiger und ist ausgerechnet bei dem Auftrag gescheitert, der es wirklich gefordert hat. Flash war günstig, aber weiterhin zu langsam und bei dieser Stichprobengröße nicht durchgehend zuverlässig.
Sollten die Kosten irgendwann zum limitierenden Faktor werden, wäre DeepSeek V4 Flash das Modell, das ich mir noch einmal genauer ansehen würde – ein Drittel des Preises ist ein echter Unterschied. Aber davor bräuchte es eine deutlich größere Stichprobe, bevor ich es bei einem kundenrelevanten Auftrag einsetzen würde. Für den Moment hat die unspektakuläre Antwort gewonnen: Das Modell, das ich schon im Einsatz hatte, ist weiterhin das richtige.
Weitere Beiträge
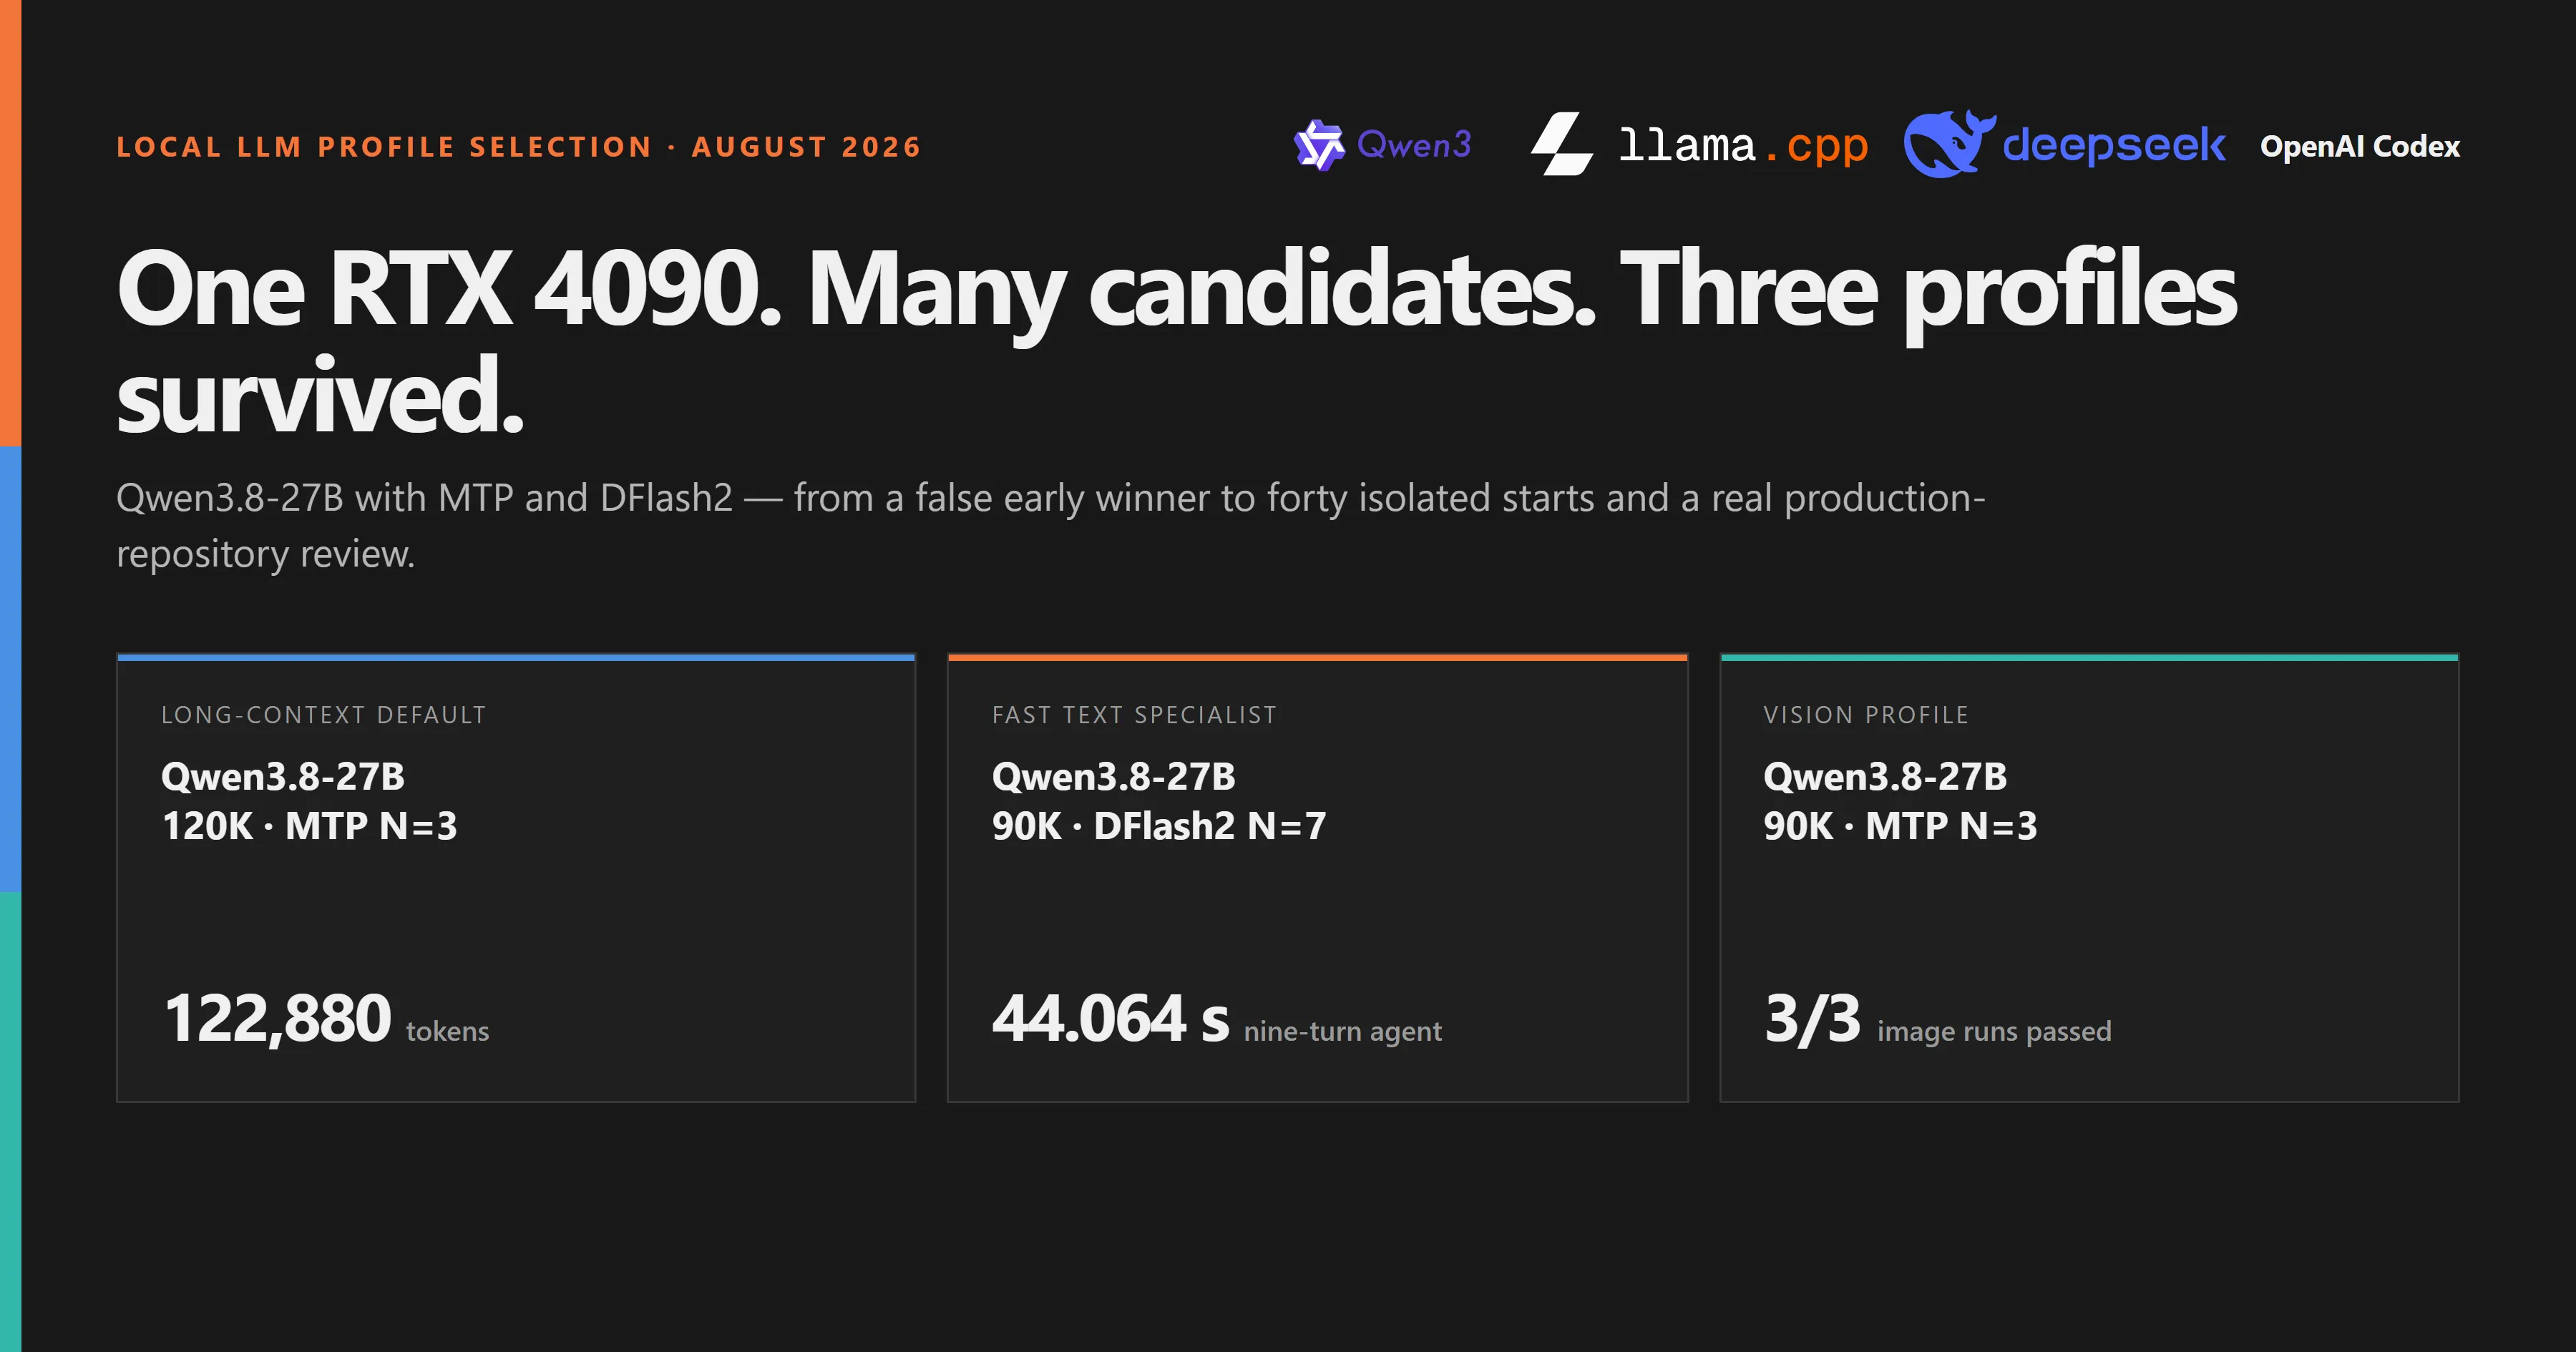
Von vielen Kandidaten zu drei Profilen: Qwen3.8-27B mit MTP und DFlash2
Auf einer RTX 4090 wurden MTP- und DFlash2-Profile schrittweise ausgesiebt. Das Ergebnis ist kein einzelner Sieger, sondern ein 120K-MTP-Standardprofil, ein schnelles 90K-DFlash2-Textprofil und ein verifiziertes 90K-MTP-Visionprofil.
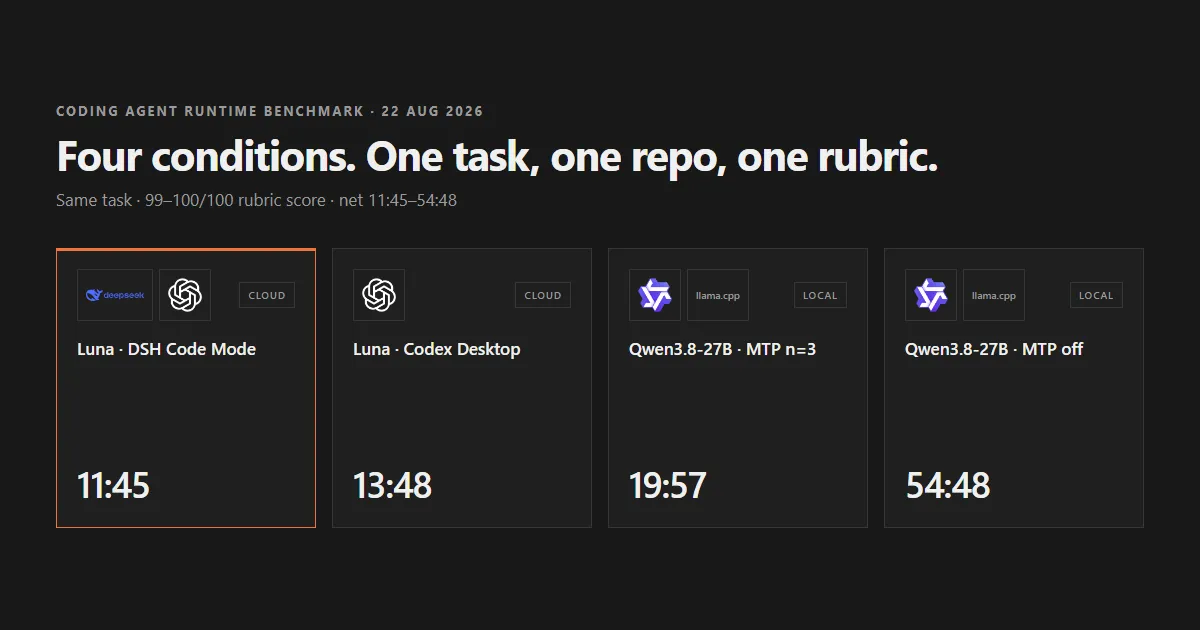
Vier Bedingungen, eine Aufgabe: Was spekulative Dekodierung und die Wahl des Agenten-Tools wirklich kosten
Vier Bedingungen lösten dieselbe Aufgabe im selben Repository und erreichten alle 99 oder 100 von 100 Punkten. Die Netto-Aufgabendauer — Freigabe-Wartezeit und automatische Kontext-Kompaktierung sind aus jeder Messung herausgerechnet — reichte von 11:45 für den Cloud-Lauf über DSH-Standardmodus bis 54:48 für das lokale Modell ohne spekulative Dekodierung.
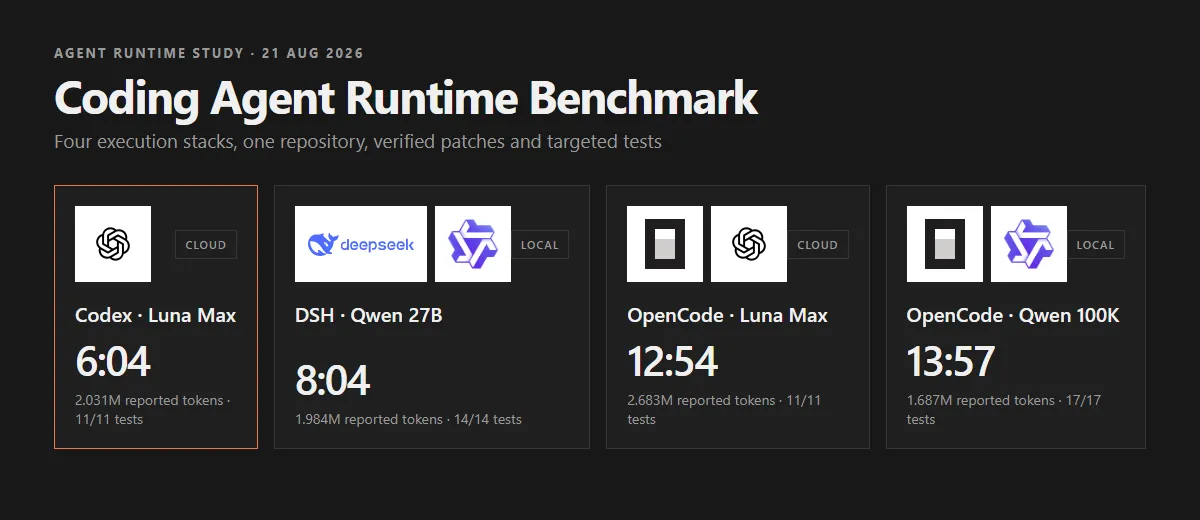
Coding-Agent-Benchmark: Wie stark das Runtime-System die Laufzeit verändert
Vier Coding-Agent-Läufe änderten dasselbe Repository und bestanden ihre Zieltests. Trotzdem reichte die Laufzeit von 6:04 bis 13:57 Minuten — Modell, Harness, Cache und Review wirkten gemeinsam.