
Claude Haiku vs. DeepSeek V4 per la scrittura di proposte con l'IA: cosa ha davvero funzionato in produzione
Gestisco una pipeline assistita dall'IA per scrivere le mie proposte da freelance: legge un annuncio di lavoro, estrae le domande principali del cliente e redige una proposta in tre fasi — Dettagli, Domande e Proposta. Claude Haiku è il modello dietro tutte e tre le fasi da quando ho costruito questa pipeline.
I modelli IA vengono continuamente confrontati sulla loro "intelligenza" — profondità di ragionamento, punteggi nei benchmark, quanto velocemente "pensano" — ma i risultati raramente coincidono tra loro, e nulla di tutto ciò mi dice se un modello reggerà davvero nella mia pipeline, sui miei incarichi, con i miei vincoli di costo. I modelli orientati al ragionamento compaiono sempre più spesso proprio in questo tipo di flusso di lavoro — scrivere proposte, rispondere a domande di gara, il lavoro di scrittura dietro un'offerta. Per questo volevo una risposta vera, non un messaggio di marketing.
Così, invece di fidarmi di un benchmark, ho eseguito il confronto dal vivo.
Il test
Ho scelto tre incarichi freelance reali e attualmente aperti dalla mia lista — un lavoro di rendering per un centro commerciale, una riprogettazione di una planimetria architettonica e una visualizzazione di processo per una segheria (la descrizione più lunga e complessa delle tre, circa 3.000 caratteri). Ogni incarico ha attraversato l'intera pipeline — Dettagli, estrazione delle domande e generazione della proposta — tre volte: una con Claude Haiku (l'attuale modello predefinito in produzione), una con DeepSeek V4 Pro al massimo sforzo di ragionamento, e una con DeepSeek V4 Flash, anch'esso al massimo sforzo di ragionamento. Stessi prompt ogni volta, nessun duplicato copiato a mano. Nove esecuzioni in totale.
L'API di DeepSeek espone solo high e max come valori reali di sforzo di ragionamento — non esiste un vero e proprio "X-High", quindi ho usato sempre max.
Cosa è successo
Claude Haiku non ha avuto alcun fallimento su tutte e nove le esecuzioni ed è stato da 3 a 10 volte più veloce, end-to-end, di entrambe le varianti DeepSeek.
DeepSeek V4 Pro al massimo ragionamento non era abbastanza affidabile da considerare una sostituzione. Sull'incarico della segheria — il più lungo dei tre — il solo passaggio Dettagli ha impiegato 67 secondi, e l'estrazione delle domande è andata completamente in timeout, senza rilevare nessuna domanda. E non era nemmeno davvero più economico di Haiku: in una chiamata Dettagli campionata, 1.951 dei 2.151 token di output erano token di ragionamento invisibili, non il riepilogo effettivamente usato dalla pipeline.
DeepSeek V4 Flash ha dato il risultato più interessante. Era chiaramente l'opzione più economica, a circa un terzo del costo per incarico di Haiku, ma è rimasto comunque da 3 a 5 volte più lento end-to-end e ha avuto un proprio timeout nella generazione della risposta, in questo piccolo campione.
Limiti
Tre incarichi e tre modelli fanno nove esecuzioni — non un benchmark su larga scala. La direzione di questi risultati è più affidabile dei moltiplicatori esatti. L'API di DeepSeek non espone un vero valore di ragionamento "X-High", quindi qui max ha fatto da sostituto. E si è trattato di una diagnostica di produzione interna sulla mia pipeline, non di un confronto pubblicato o sottoposto a revisione paritaria.
Cosa ne faccio
Claude Haiku resta il modello predefinito in produzione. Nessuna delle due varianti DeepSeek mi ha dato un motivo per cambiare — Pro era più lento, non davvero più economico nella pratica, ed è fallito proprio sull'incarico che lo metteva più alla prova; Flash era economico ma restava troppo lento e non del tutto affidabile con questa dimensione di campione.
Se il costo dovesse mai diventare un vincolo determinante, DeepSeek V4 Flash sarebbe il modello che riconsidererei — un terzo del prezzo è una differenza reale. Ma prima servirebbe un campione molto più ampio prima di fidarmene su un incarico rivolto a un cliente. Per ora ha vinto la risposta meno spettacolare: il modello che avevo già in produzione resta quello giusto.
Altri articoli
Da molti candidati a tre profili: Qwen3.8-27B con MTP e DFlash2
Su una RTX 4090, i profili MTP e DFlash2 sono stati eliminati fase dopo fase. Il risultato non è un vincitore universale, ma un profilo MTP 120K predefinito, uno specialista testo DFlash2 90K e un profilo vision MTP 90K verificato.
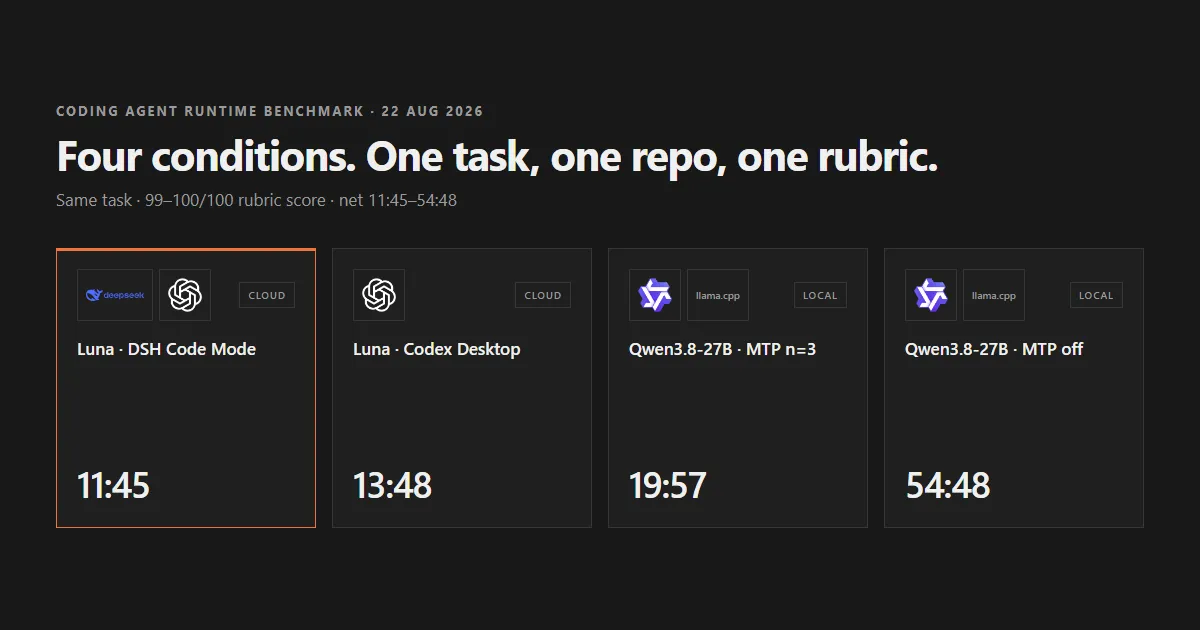
Quattro condizioni, un compito: quanto costano davvero la decodifica speculativa e la scelta dello strumento agente
Quattro condizioni hanno risolto lo stesso compito nello stesso repository e ognuna ha ottenuto 99 o 100 punti su 100. La durata netta del compito — tempo di attesa per l'approvazione e di compattazione automatica del contesto esclusi da ogni misurazione — andava da 11:45 per l'esecuzione cloud tramite modalità standard di DSH a 54:48 per il modello locale senza decodifica speculativa.
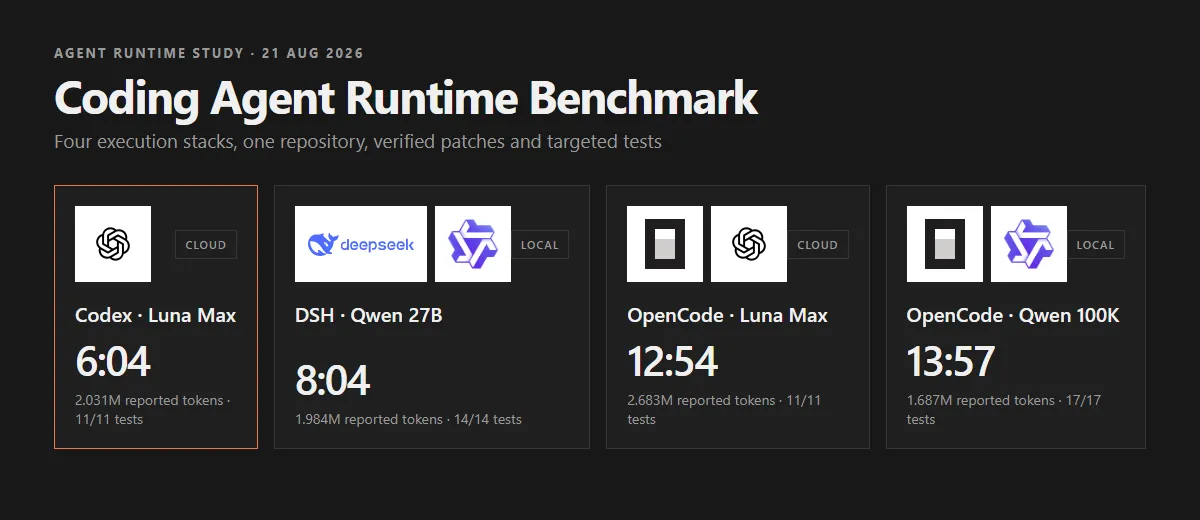
Benchmark degli agenti di codice: l’impatto del runtime
Quattro agenti hanno modificato lo stesso repository e superato i test mirati. La durata variava comunque da 6:04 a 13:57 per l’effetto combinato di modello, harness, cache e revisione.