
Von vielen Kandidaten zu drei Profilen: Qwen3.8-27B mit MTP und DFlash2
Der schnellste Decoder wurde nicht automatisch zum besten Alltagsprofil. Genau das ist die zentrale Erkenntnis dieser Testreihe. Auf derselben Maschine, mit derselben Qwen3.8-27B-Zielfamilie und derselben Gewichtquantisierung wurden MTP- und DFlash2-Konfigurationen über mehrere Stufen geprüft: zuerst breit, danach mit identischer Historie, anschliessend auf dem offiziellen llama.cpp-Runtime, in 40 isolierten Starts, mit Bildinput und schliesslich in einem echten, ausschliesslich lesenden Repository-Review.

Testsystem und genaue Modellbasis
| Komponente | Konfiguration |
|---|---|
| Betriebssystem | Windows 11 Pro, Build 26200 |
| CPU | AMD Ryzen 9 7950X, 16 Kerne / 32 Threads |
| GPU | NVIDIA GeForce RTX 4090, 24.564 MiB gemeldeter VRAM |
| Arbeitsspeicher | 128 GB DDR5, vier Module, 3.600 MT/s |
| Zielfamilie | Qwen3.8-27B |
| Gewichtsquantisierung | UD-Q4_K_XL, GGUF |
| KV-Cache | Q8 Key / Q8 Value |
| Runtime | offizielles llama.cpp b10658, Commit b10f9ca58 |
Die Reasoning-Stufe war keine kontrollierte Testvariable. Zwar enthalten Agenten-Sitzungen entsprechende Felder, doch Reasoning wurde hier weder systematisch ausgewählt noch variiert oder isoliert. Deshalb wird kein Geschwindigkeits- oder Qualitätsunterschied mit einer Reasoning-Stufe erklärt.
Ein früher Sieger, der keiner war
Die erste Auswahl enthielt P0 ohne spekulatives Decoding sowie M3, M3K, D5 und D5K. M3K und D5K kamen weiter; KN verfehlte die geforderte +3-%-Schwelle, K1 und K2 wurden langsamer. Dann sah D5K in einer warmen Historie plötzlich 12,4 % schneller aus. Die Protokollprüfung zeigte jedoch, dass die Gesprächsverläufe nicht identisch waren.
Im Golden-History-Rerun brauchte M3K 53,614 s, D5K dagegen 119,756 s. Das scheinbare Resultat wurde nicht gelöscht, sondern als ungültige Messung im Audit-Trail behalten. Diese Umkehr war wichtiger als jede Tok/s-Zahl: Ohne gleiche Historie gibt es keinen fairen Sieger.
DFlash2 auf dem offiziellen Runtime
Vor der finalen Auswahl wurde DFlash2 vom alten Fork auf das offizielle llama.cpp b10658 migriert. Im warmen Neun-Turn-Bridge-Test stieg N=7 von 114,02 auf 118,12 effektive Tok/s. N=4 und N=5 blieben nahezu gleich, während die nicht-spekulative Referenz auf beiden Builds im selben Bereich lag. N=6 brach bei grossem Kontext auf etwa 34–37 Tok/s ein und wurde verworfen.

DFlash2 konnte im getesteten Pfad zudem keinen brauchbaren Bildoutput liefern. Daher wurde DFlash2 als Textprofil geführt, nicht als Vision-Kandidat.
Warum die höchste Decode-Rate nicht jede Aufgabe gewinnt
Beim gefüllten Prompt mit 56.093 Tokens dekodierte D7K mit 124,13 Tok/s am schnellsten. Trotzdem beendete M3K den gesamten Request früher. Prompt-Evaluation dominierte diese Aufgabe stärker als der reine Decode-Abschnitt.

Im anhaltenden Neun-Turn-Agentenverlauf änderte sich das Bild. D7K-90K lag mit 44,064 s vorn, vor D5K-100K mit 47,255 s und den beiden M3K-Profilen bei etwa 52,5 s.

Vierzig isolierte Starts
Vier tägliche Kandidaten wurden in insgesamt 40 isolierten Serverstarts geprüft. Alle 40 Requests endeten natürlich; es gab keine OOMs, leeren Antworten, Abbrüche oder Requestfehler. Near-cap Retrieval bestand jedes Profil. Funktionaler Code bestand bei allen Kandidaten fünf Tests; alle vier verletzten jedoch dieselbe strenge Formatvorgabe, weil sie einen äusseren Markdown-Codeblock hinzufügten.
| Profil | Kontext | 56K Wall | 9-Turn Wall | Min. freier VRAM | Near-cap Retrieval |
|---|---|---|---|---|---|
| M3K-128K | 131.072 | 34,659 s | 52,576 s | 345 MiB | PASS bei 102.893 Tokens |
| M3K-120K | 122.880 | 34,479 s | 52,471 s | 699 MiB | PASS bei 96.788 Tokens |
| D5K-100K | 102.400 | 36,445 s | 47,255 s | 423 MiB | PASS bei 80.246 Tokens |
| D7K-90K | 90.000 | 36,714 s | 44,064 s | 582 MiB | PASS bei 71.240 Tokens |

M3K-128K gewann keinen praktischen Alltagspunkt gegenüber 120K, reduzierte den gemessenen Mindestpuffer aber von 699 auf 345 MiB. D5K-100K wurde von zwei Seiten dominiert: D7K war im anhaltenden Textlauf schneller, M3K-120K bot mehr Kontext und mehr Headroom.
Die drei finalen Profile
| Rolle | Exakte Profil-ID | Entscheidung |
|---|---|---|
| Long-context Standard | Qwen3.8-27B-120K-Q8-M3K-Text | 122.880 Tokens, MTP N=3, K4V, Text |
| Schneller Textspezialist | Qwen3.8-27B-90K-Q8-D7K-Official-TextOnly | 90.000 Tokens, DFlash2 N=7, K4V, nur Text |
| Visionprofil | Qwen3.8-27B-90K-Q8-M3K-VisionVRAM | 90.000 Tokens, MTP N=3, K4V, Text + Bild |
Das Visionprofil bestand drei unabhängige Bildläufe plus einen gerouteten Smoke-Test. Der Mittelwert lag bei 2,034 s Wall Time, 858 ms TTFT, 1.323,92 Prompt-Tok/s und 69,61 Decode-Tok/s; der minimale freie VRAM betrug 924 MiB.
Der echte Repository-Review
Zum Schluss prüften die Profile dasselbe Produktions-Repository read-only. Hier ist Vorsicht nötig: Die beiden Qwen-Läufe verwendeten Luna-Helfer, der direkte Lauf von gpt-5.6-luna nicht. Das ist ein Workflow-Vergleich, kein reiner Modellvergleich.
| Lauf | Aktive LLM+Tool-Zeit | Lokale Decode-TPS | Ø TTFT | Cache-Anteil | Kompaktierung | Ergebnis |
|---|---|---|---|---|---|---|
| Qwen D7K-90K | 13:51,705 | 62,683 | 2,902 s | 88,64 % | 1 | 12 bestätigte Funde + 6 Risiken |
| Qwen M3K-120K | 13:36,616 | 62,325 | 2,098 s | 94,01 % | 0 | 27 Funde + 5 Risiken |
| gpt-5.6-luna direkt | nicht offengelegt | nicht offengelegt | nicht offengelegt | 93,125 % | nicht erfasst | 13 priorisierte Funde |

M3K-120K brachte alle vier Helfer zum Abschluss. Beim D7K-Lauf scheiterten vier von sechs Helfern am Kontingent; Qwen musste ihre Arbeit nachholen und kompaktierte einmal. Der direkte Luna-Lauf dauerte 44:33,227 Wall Time und lieferte die stärkste Priorisierung kritischer Zustandsautomaten. Seine 35,174 Output-Tokens pro Wall-Sekunde sind jedoch keine Decode-TPS, weil der Provider weder aktive Inferenzzeit noch Decode-Zeit oder TTFT offenlegte.
Die praktische Empfehlung lautet daher: M3K-120K plus schnelle Luna-Helfer für breite Erstabdeckung; gpt-5.6-luna direkt für die abschliessende Beurteilung kritischer Zustandsautomaten; D7K-90K für anhaltende lokale Textgenerierung.
Grenzen und Quellen
Die Resultate gelten für dieses System, diese Quantisierung, diesen Runtime-Build, diese Kontexte und diese Workloads. Fundzahlen messen berichtete Abdeckung, nicht automatisch Wahrheit. Die realen Reviews unterschieden sich in der Orchestrierung. Reasoning war keine kontrollierte Variable.
Weitere Beiträge
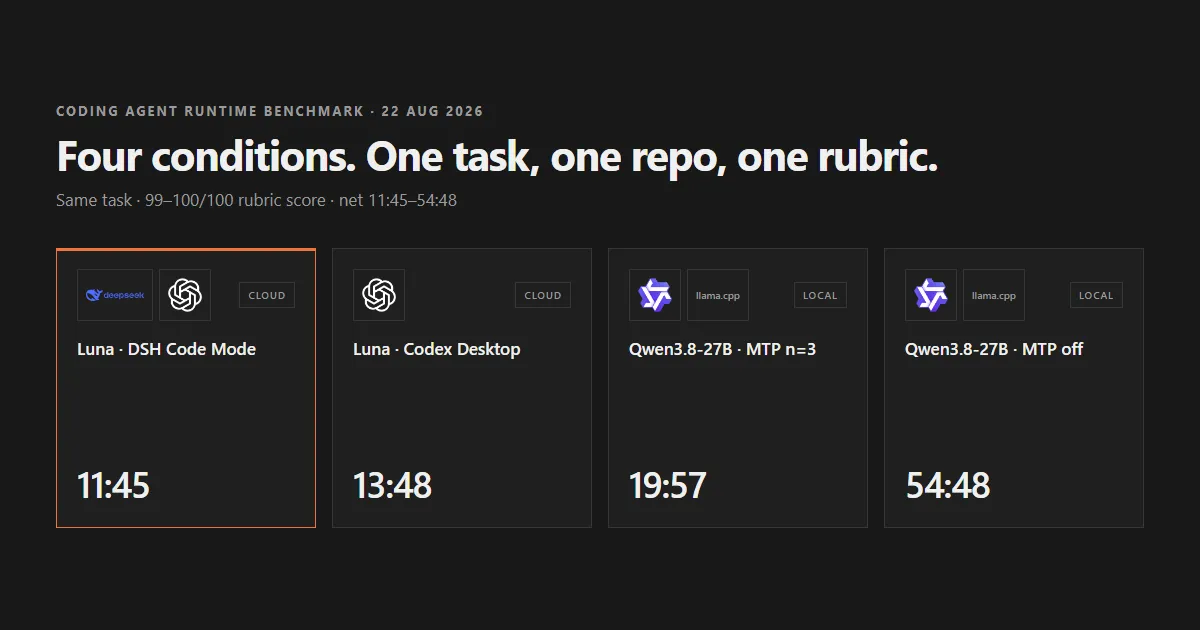
Vier Bedingungen, eine Aufgabe: Was spekulative Dekodierung und die Wahl des Agenten-Tools wirklich kosten
Vier Bedingungen lösten dieselbe Aufgabe im selben Repository und erreichten alle 99 oder 100 von 100 Punkten. Die Netto-Aufgabendauer — Freigabe-Wartezeit und automatische Kontext-Kompaktierung sind aus jeder Messung herausgerechnet — reichte von 11:45 für den Cloud-Lauf über DSH-Standardmodus bis 54:48 für das lokale Modell ohne spekulative Dekodierung.
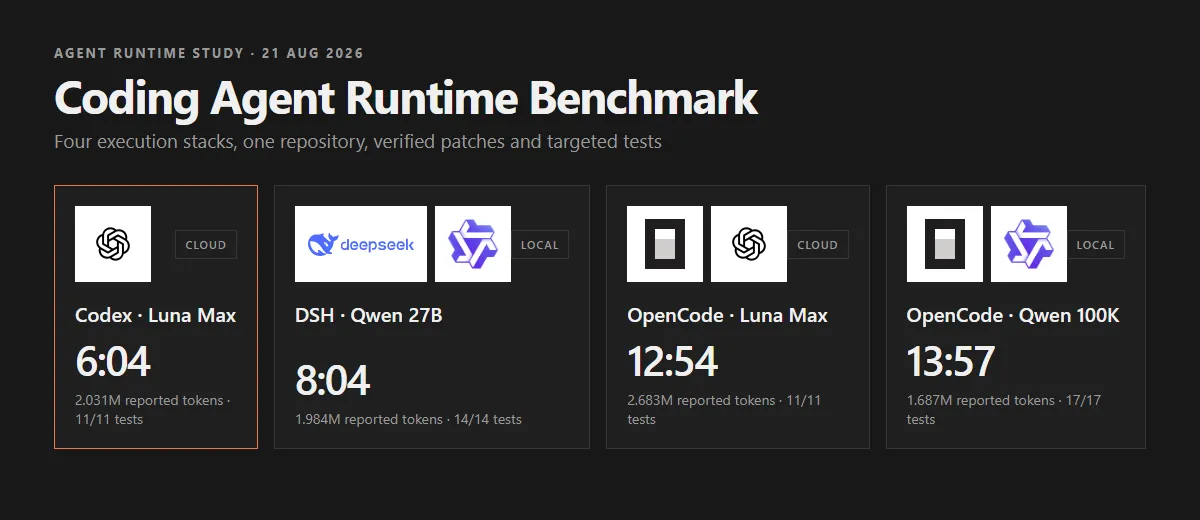
Coding-Agent-Benchmark: Wie stark das Runtime-System die Laufzeit verändert
Vier Coding-Agent-Läufe änderten dasselbe Repository und bestanden ihre Zieltests. Trotzdem reichte die Laufzeit von 6:04 bis 13:57 Minuten — Modell, Harness, Cache und Review wirkten gemeinsam.
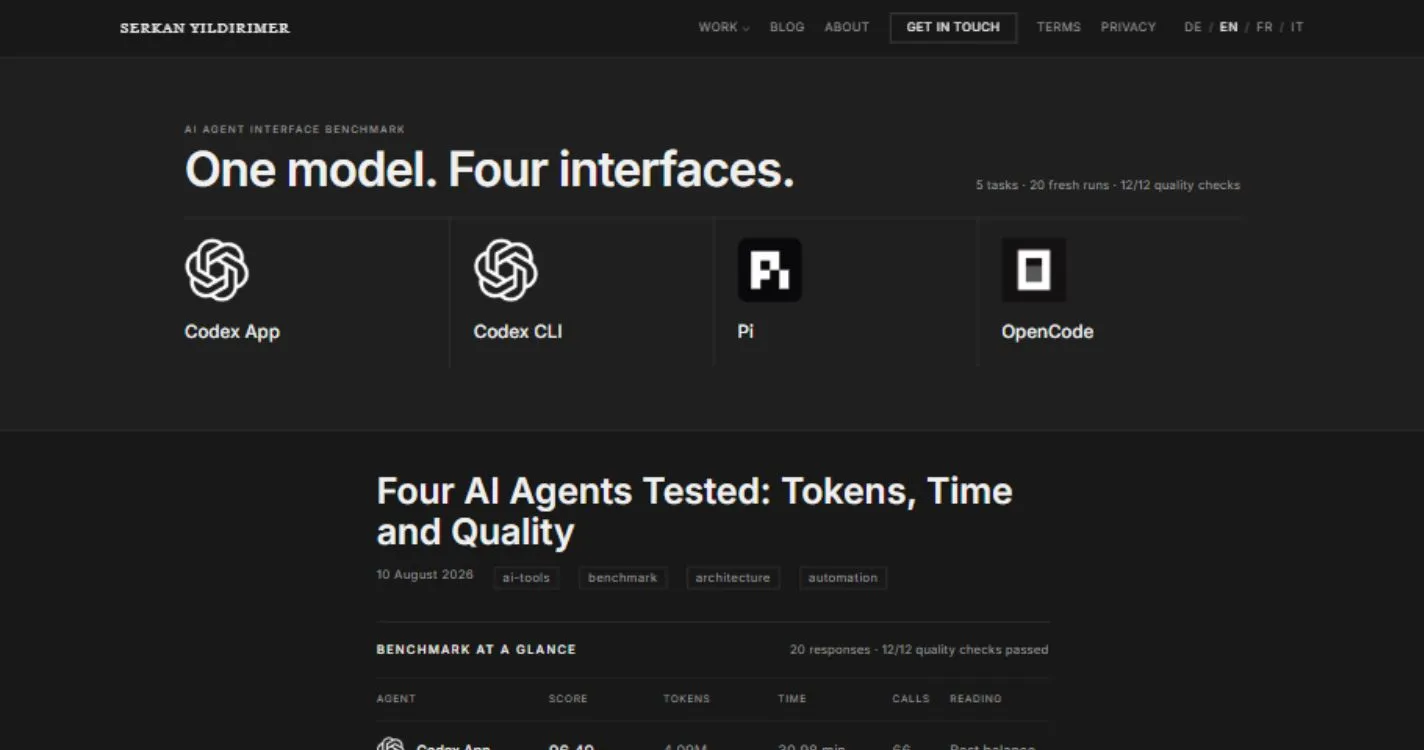
Vier KI-Agenten im Praxistest: Token, Zeit und Qualität
Dasselbe KI-Modell, vier Agenten-Oberflächen, fünf reale Repository-Aufgaben: Was sich bei Qualität, Tokenvolumen, Laufzeit und Arbeitsweise tatsächlich unterschied.