
Da molti candidati a tre profili: Qwen3.8-27B con MTP e DFlash2
Il decoder più veloce non è diventato automaticamente il miglior profilo quotidiano. Sulla stessa macchina, con la stessa famiglia Qwen3.8-27B e la stessa quantizzazione, le configurazioni MTP e DFlash2 sono state eliminate in più fasi: selezione ampia, storico identico, migrazione al runtime ufficiale, 40 avvii isolati, input immagine e infine una review read-only di un repository di produzione.

Sistema e base modello
| Componente | Configurazione |
|---|---|
| OS | Windows 11 Pro, build 26200 |
| CPU | AMD Ryzen 9 7950X, 16 core / 32 thread |
| GPU | NVIDIA RTX 4090, 24.564 MiB di VRAM dichiarata |
| Memoria | 128 GB DDR5, quattro moduli, 3.600 MT/s |
| Modello target | Qwen3.8-27B, UD-Q4_K_XL GGUF |
| Cache KV | Q8 key / Q8 value |
| Runtime | llama.cpp ufficiale b10658, commit b10f9ca58 |
Il reasoning effort non era una variabile controllata. Non è stato selezionato, variato o isolato sistematicamente; nessun risultato viene quindi attribuito a quel parametro.
Dal falso vincitore al runtime ufficiale
La prima selezione comprendeva P0, M3, M3K, D5 e D5K. M3K e D5K avanzarono; KN non superò la soglia del +3% e K1/K2 peggiorarono. Un primo risultato mostrava D5K avanti del 12,4%, ma l'audit trovò storici diversi. Con uno storico identico M3K chiuse in 53,614 s, D5K in 119,756 s.
DFlash2 fu poi migrato a llama.cpp b10658. N=7 passò da 114,02 a 118,12 tok/s effettivi nel bridge caldo a nove turni. N=6 collassò a contesto ampio e venne eliminato. Il percorso immagine DFlash2 non produsse contenuto utile, quindi DFlash2 rimase text-only.

Due carichi, due vincitori
Sul prompt pieno da 56.093 token, D7K decodificava a 124,13 tok/s, ma M3K completava prima l'intera richiesta: la valutazione del prompt dominava il carico.

Nello storico agente a nove turni, D7K-90K vinse con 44,064 s.

Tutti i 40 avvii isolati terminarono naturalmente, senza OOM, risposte vuote, troncamenti o errori di richiesta. Ogni profilo superò il near-cap retrieval e cinque test funzionali sul codice.
| Profilo | Contesto | Wall 56K | Wall nove turni | VRAM libera min. |
|---|---|---|---|---|
| M3K-128K | 131.072 | 34,659 s | 52,576 s | 345 MiB |
| M3K-120K | 122.880 | 34,479 s | 52,471 s | 699 MiB |
| D5K-100K | 102.400 | 36,445 s | 47,255 s | 423 MiB |
| D7K-90K | 90.000 | 36,714 s | 44,064 s | 582 MiB |

I tre profili finali
- Qwen3.8-27B-120K-Q8-M3K-Text: default locale long-context.
- Qwen3.8-27B-90K-Q8-D7K-Official-TextOnly: specialista testo sostenuto.
- Qwen3.8-27B-90K-Q8-M3K-VisionVRAM: profilo testo + immagine verificato.
Il profilo vision superò tre run immagine indipendenti e uno smoke test instradato. La media fu 2,034 s, TTFT 858 ms e VRAM libera minima 924 MiB.
Review reale del repository
I due coordinatori Qwen usarono helper Luna; il run diretto gpt-5.6-luna non ne usò. È quindi un confronto di workflow, non un confronto puro tra modelli.
| Run | Tempo attivo LLM+tool | Decode TPS locale | TTFT medio | Cache | Compaction |
|---|---|---|---|---|---|
| Qwen D7K-90K | 13:51,705 | 62,683 | 2,902 s | 88,64% | 1 |
| Qwen M3K-120K | 13:36,616 | 62,325 | 2,098 s | 94,01% | 0 |
| gpt-5.6-luna diretto | non esposto | non esposto | non esposto | 93,125% | non registrato |

M3K-120K completò tutti e quattro gli helper. Nel run D7K, quattro su sei raggiunsero il limite d'uso e Qwen dovette recuperare il lavoro. Luna diretto impiegò 44:33,227 wall-clock e produsse la migliore priorità sui percorsi critici. I suoi 35,174 token di output per secondo di wall time non sono decode TPS confrontabili.
Il workflow consigliato usa M3K-120K con helper Luna per la copertura ampia, Luna diretto per l'arbitraggio critico, D7K-90K per testo locale sostenuto e M3K-90K per le immagini.
Limiti e fonti
I risultati dipendono da sistema, build, quantizzazione, contesti e workload testati. Il numero di finding non ne verifica da solo la correttezza. Il reasoning non era una variabile controllata.
Altri articoli
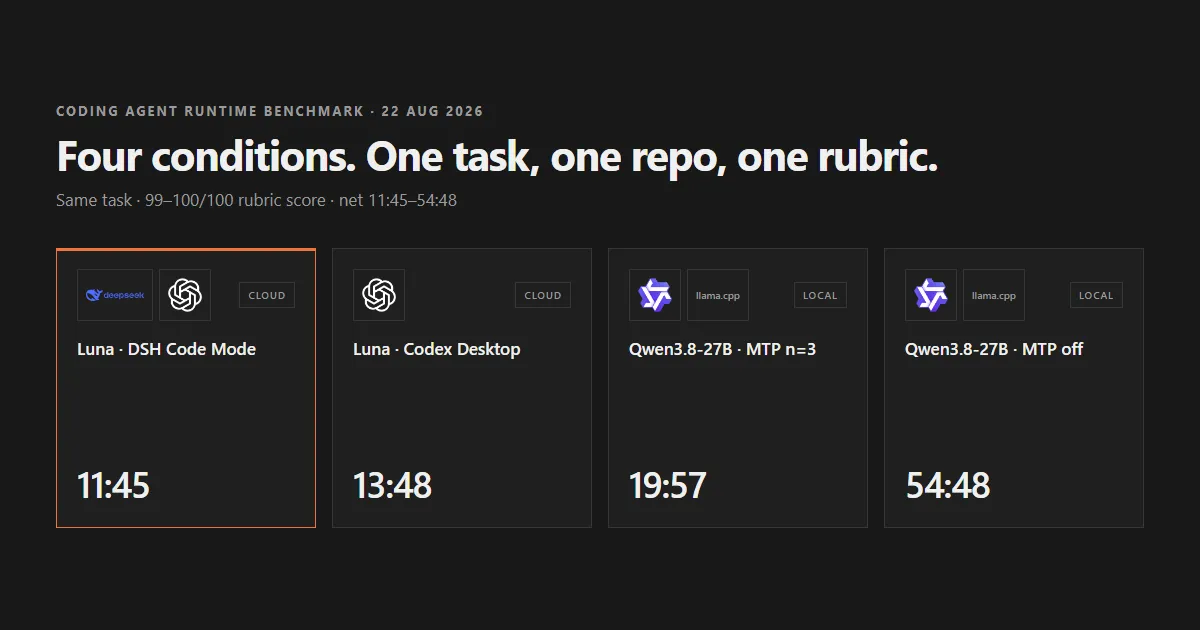
Quattro condizioni, un compito: quanto costano davvero la decodifica speculativa e la scelta dello strumento agente
Quattro condizioni hanno risolto lo stesso compito nello stesso repository e ognuna ha ottenuto 99 o 100 punti su 100. La durata netta del compito — tempo di attesa per l'approvazione e di compattazione automatica del contesto esclusi da ogni misurazione — andava da 11:45 per l'esecuzione cloud tramite modalità standard di DSH a 54:48 per il modello locale senza decodifica speculativa.
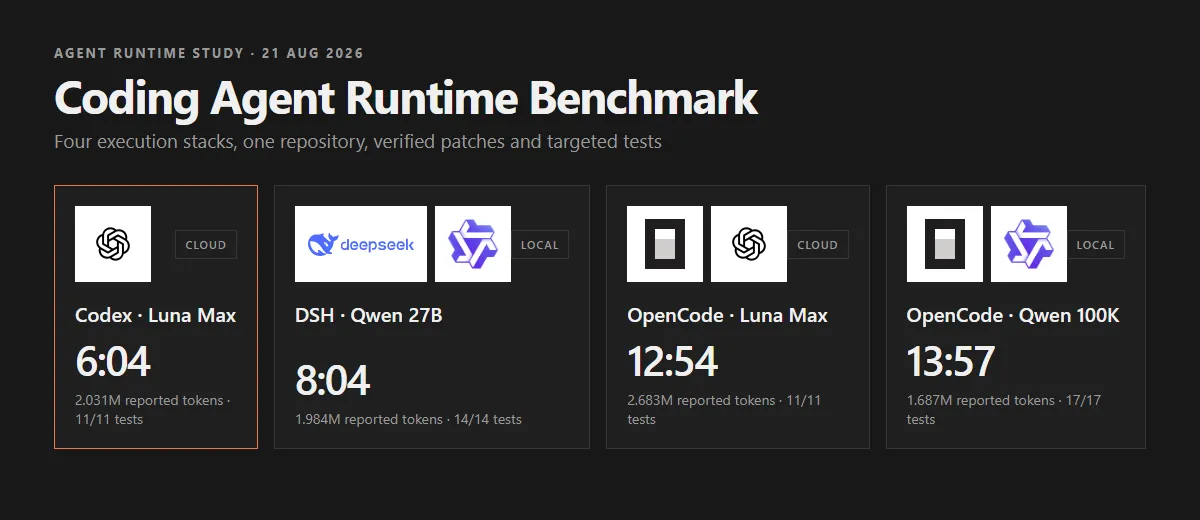
Benchmark degli agenti di codice: l’impatto del runtime
Quattro agenti hanno modificato lo stesso repository e superato i test mirati. La durata variava comunque da 6:04 a 13:57 per l’effetto combinato di modello, harness, cache e revisione.
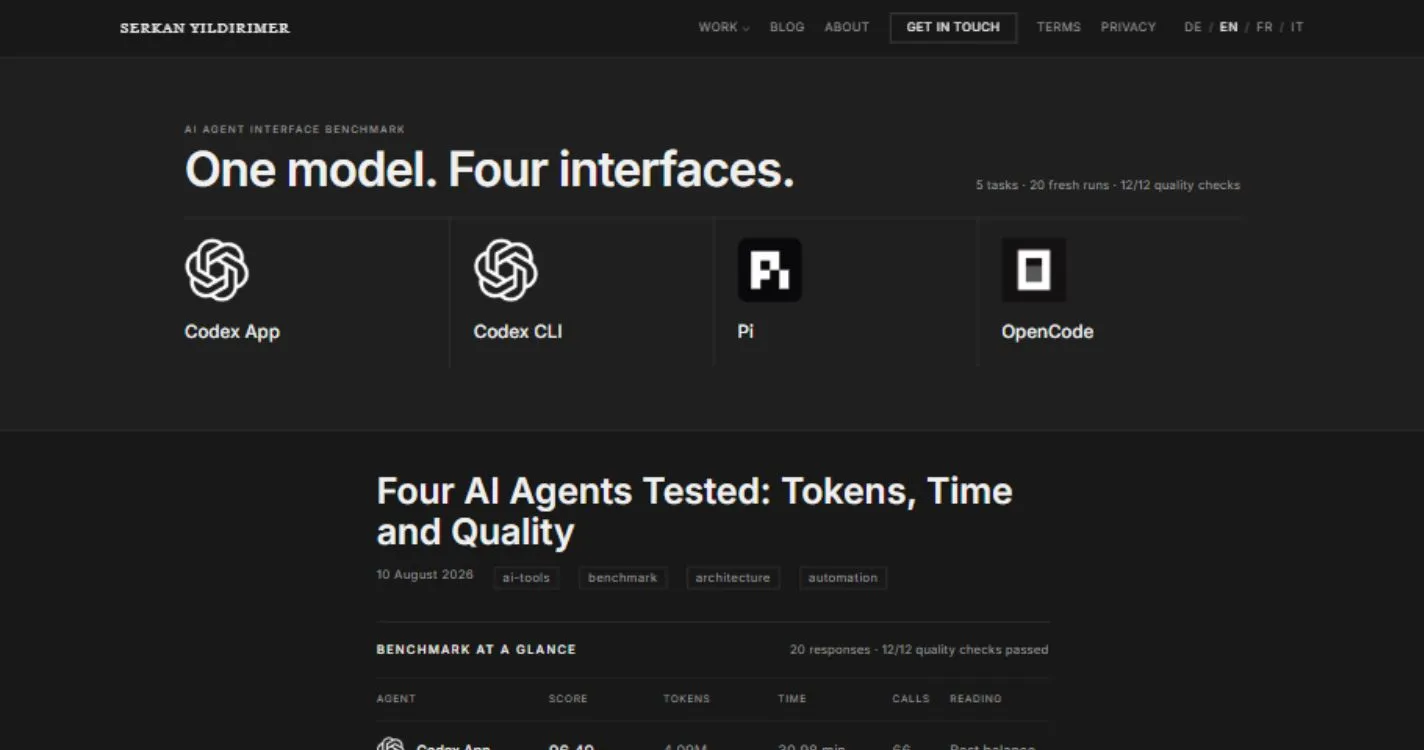
Quattro agenti IA a confronto: token, tempo e qualità
Lo stesso modello IA, quattro interfacce agentiche e cinque attività reali su repository: le differenze misurate in qualità, token, tempo e metodo di lavoro.