 Cloud
Luna · DSH Standard Mode
11:45
Benchmark dei runtime per agenti di codice
Quattro condizioni. Un compito, un repository, una rubrica.
Stesso compito · 99–100/100 punti · netto 11:45–54:48
Cloud11:45
Cloud13:48
 llama.cppLocale
19:57
llama.cppLocale54:48
Rilevato: 2026-08-22T09:15:00+02:00
Sistema operativo
Windows 11 Pro
CPU
AMD Ryzen 9 7950X
Core
16C/32T
RAM
128 GB
GPU / VRAM
NVIDIA GeForce RTX 4090 / 24 GB
Driver GPU
610.88
| Esecuzione | Runtime | Modello | Formato / quantizzazione | Contesto / KV cache | Backend |
|---|---|---|---|---|---|
| Qwen3.8-27B · MTP off (Locale) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-UD-Q4_K_XL.gguf (spec. decoding: none) | GGUF / UD-Q4_K_XL | 131072 tokens (128K) / Q8 (q8_0 K, q8_0 V) | llama.cpp llama-server 0.1.0-rc.8 |
| Qwen3.8-27B · MTP n=3 (Locale) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-UD-Q4_K_XL.gguf (spec. decoding: draft-mtp, n=3) | GGUF / UD-Q4_K_XL | 131072 tokens (128K) / Q8 (q8_0 K, q8_0 V) | llama.cpp llama-server 0.1.0-rc.8 |
| Luna · DSH Standard Mode (Cloud) | DeepSeek Harness (dsh), openai-codex provider, 0.1.0-rc.8 | gpt-5.6-luna (reasoning effort: max) | non dichiarato dal fornitore | 272000 tokens / non dichiarato dal fornitore | non dichiarato dal fornitore |
| Luna · Codex Desktop (Cloud) | Codex Desktop 0.149.0-alpha.4.1 | gpt-5.6-luna (reasoning effort: max) | non dichiarato dal fornitore | 258400 tokens / non dichiarato dal fornitore | non dichiarato dal fornitore |
I valori per esecuzione provengono dall’export della singola sessione (intestazioni di sessione DSH, oppure l’export token-usage/rollout proprio di Codex Desktop); l’hardware è stato riverificato sulla stessa macchina il 22.08.2026.
Le due esecuzioni cloud dichiarano, nelle proprie intestazioni di sessione, finestre di contesto diverse (272.000 contro 258.400 token) per lo stesso modello, molto probabilmente per percorsi di provider/routing diversi e non per una reale differenza di modello.
Quattro condizioni · 99–100/100 punti
Che cosa contiene davvero la durata grezza della sessione
Due delle tre componenti seguenti non hanno nulla a che fare con il lavoro effettivo del modello.
Modello, strumenti e orchestrazione che svolgono davvero il lavoro
Tempo di reazione umano a una richiesta di escalation della sandbox
La chiamata di riepilogo automatico dello strumento quando il contesto si riempie, senza intervento umano
Meno è meglio · minuti, corretti per attesa di approvazione e compattazione
Composizione della durata grezza; il tempo netto del compito è ciò che resta
Più è meglio · token di output al secondo, al netto della correzione
Contabilità propria di ciascun sistema; non un'unità comune tra locale e cloud (vedi limiti)
Numero di chiamate distinte agli strumenti; nessuna direzione è intrinsecamente migliore
Più è meglio · su 100, valutato da un reviewer che ha letto il diff ed eseguito la verifica
| Condizione | Correttezza /45 | Test /20 | Robustezza /15 | Manutenibilità /10 | Ambito /10 | Totale |
|---|---|---|---|---|---|---|
| Luna · DSH Standard Mode | 45 | 20 | 15 | 10 | 10 | 100 |
| Luna · Codex Desktop | 44 | 20 | 15 | 10 | 10 | 99 |
| Qwen3.8-27B · MTP n=3 | 45 | 20 | 15 | 9 | 10 | 99 |
| Qwen3.8-27B · MTP off | 45 | 20 | 15 | 10 | 10 | 100 |
Quattro copie indipendenti e isolate dello stesso repository Cloudflare Worker hanno ricevuto lo stesso compito, sullo stesso commit: aggiungere un registro D1 durevole affinché un aggiornamento webhook di Telegram non venga mai pianificato due volte, anche in presenza di duplicati concorrenti o di un errore di database transitorio e ambiguo, più un lavoro di 14 giorni che elimina solo le righe terminali. Quattro condizioni lo hanno eseguito: un Qwen3.8-27B locale con decodifica speculativa disattivata, lo stesso modello con decodifica speculativa attivata (draft-mtp, n=3), e un GPT-5.6 "Luna" ospitato con livello di ragionamento "max" tramite due strumenti agente diversi, la modalità standard di DSH e l'app Codex Desktop di OpenAI stessa. Un reviewer indipendente ha poi valutato ogni invio secondo la stessa rubrica da 100 punti leggendo il diff, eseguendo personalmente `type-check` e la suite di test, e verificando uno per uno tutti gli 11 scenari di test richiesti.
Tutti e quattro hanno ottenuto 99 o 100 punti su 100. La qualità del codice non era quindi ciò che distingueva le quattro condizioni in questo compito — lo era la durata netta del compito. Per ogni condizione, il tempo di attesa per l'approvazione e la compattazione automatica del contesto sono stati esclusi dal tempo misurato, perché entrambi sono sovraccarico, non lavoro del modello; tutte le durate qui sotto sono già valori netti.
La modalità standard di DSH solleva una richiesta di escalation della sandbox (ad esempio per permettere al config loader di Vitest di avviare un processo figlio) e attende che un essere umano clicchi su "consenti"; l'intervallo tra questa richiesta e il clic è puro tempo di reazione, non lavoro dell'agente, ed è stato escluso dalla misurazione. Inoltre, una volta che la finestra di contesto si riempie, DSH esegue di propria iniziativa una chiamata di riepilogo automatico, senza alcun intervento umano, ma che consuma comunque minuti reali — anche questo tempo è escluso.
Un singolo clic di approvazione da solo ha rappresentato 11:53 esclusi dall'esecuzione DSH+Luna. Il tempo netto del compito per la modalità standard di DSH + Luna è di 11:45 — davanti ai 13:48 di Codex Desktop, che non ha sollevato alcuna richiesta di approvazione comparabile. Lo stesso calcolo vale per le due esecuzioni locali di Qwen: MTP disattivato ha avuto 5:54 esclusi su due compattazioni automatiche, MTP n=3 solo 1:42 esclusi su una.
Il tempo netto del compito per lo stesso modello locale è sceso da 54:48 con decodifica speculativa disattivata a 19:57 con decodifica attivata — 2,7 volte più veloce, con il throughput di output che è passato da 33,8 a 55,5 token al secondo. Il numero di chiamate agli strumenti si è mosso nella direzione opposta: MTP disattivato ha richiesto 93 chiamate per raggiungere lo stesso risultato, MTP n=3 solo 61. Nessuno di questi numeri è stimato; entrambi provengono direttamente dagli eventi di chiamata agli strumenti della sessione DSH.
No. Ogni invio ha superato `type-check` e la sua suite di test completa, ha coperto tutti gli 11 scenari di test richiesti con asserzioni comportamentali anziché un semplice confronto di stringhe SQL, e ha implementato correttamente la parte più difficile della specifica: una richiesta SQL atomica (`INSERT ... ON CONFLICT`) con lo stesso token di richiesta riutilizzato tra i tentativi, in modo che una rilettura dopo una risposta persa e un nuovo tentativo venga riconosciuta come la richiesta riuscita del chiamante stesso invece che come un duplicato. Nessuno ha toccato un file vietato, aggiunto una dipendenza o mostrato alcun segno di delega. Le due detrazioni di un punto erano entrambe semplici questioni di collocazione — la pulizia di retention innescata a ogni webhook accettato invece che tramite il trigger cron esistente, e una funzione di finalizzazione cresciuta leggermente oltre l'indicazione "mantieni la route piccola" del compito — non bug di comportamento.
Un reviewer, lavorando sull'invio Luna/Codex Desktop, ha notato qualcosa che la rubrica non valuta. Quell'invio genera un token di richiesta nuovo a ogni invocazione del Worker invece di derivarlo in modo deterministico dall'ID dell'aggiornamento. Se ogni tentativo all'interno del ciclo di retry di una singola consegna segnala al chiamante un errore transitorio, mentre uno di quei tentativi in realtà ha eseguito il commit in silenzio, la riga resta nello stato "processing" sotto un token che nessuna richiesta futura conosce. Una nuova consegna di Telegram è una nuova richiesta HTTP con un token appena generato; legge il token ormai diverso della riga esistente, lo tratta come la richiesta di qualcun altro, e l'aggiornamento può restare bloccato permanentemente. Poiché la retention elimina solo le righe terminali, non viene mai ripulito nemmeno in quel modo. Questo non è stato riverificato in modo indipendente sul codice esatto di generazione del token delle altre tre implementazioni, quindi va considerato come una domanda da approfondire su tutte e quattro, non come un difetto confermato in una sola.
Si tratta di una singola ripetizione per condizione, un test pilota. Il manifesto stesso del benchmark raccomanda almeno tre ripetizioni per condizione con un ordine nuovamente randomizzato prima di considerare definitiva una classifica. La contabilità dei token locale e cloud non è un'unità comune: DSH somma input nuovo, output e letture cache come tre contatori additivi separati, mentre Codex Desktop dichiara un contatore di input cumulativo in cui l'input in cache è già un sottoinsieme; non calcolate quindi un rapporto attraverso questo confine. I token di output al secondo sono una misura del tempo fino al risultato utile, non un benchmark isolato di velocità di decodifica: include il tempo di esecuzione degli strumenti per ogni esecuzione, oltre alla coda di rete e API per le due esecuzioni cloud. Le due esecuzioni cloud dichiarano, nelle proprie intestazioni di sessione, finestre di contesto diverse per lo stesso modello, il che non è stato risolto in modo indipendente e potrebbe riflettere percorsi di routing del provider diversi piuttosto che una reale differenza di modello. Il rischio di riga bloccata descritto sopra è stato identificato in un invio e non è stato verificato in modo indipendente sul codice esatto di generazione del token degli altri tre.
Il risultato pulito di questo test è il confronto sulla decodifica speculativa: stesso modello, stesso hardware, un solo parametro cambiato, una differenza di 2,7 volte senza alcun costo di qualità in questa esecuzione. Il risultato più confuso è il confronto tra gli strumenti agente: la modalità standard di DSH e Codex Desktop hanno prodotto una quantità nettamente diversa di sovraccarico estraneo al compito sullo stesso modello che svolgeva lo stesso lavoro, e questo sovraccarico era invisibile finché i log di sessione non sono stati letti evento per evento. Prima di considerare uno dei due numeri come una proprietà dello strumento anziché di questa singola esecuzione, servono tre ripetizioni per condizione con ordine randomizzato, e idealmente una logica di approvazione che non metta il tempo di reazione di un essere umano in mezzo a una normale escalation della sandbox.
Le misurazioni sono state ricostruite da quattro export di sessione conservati: tre file `session.jsonl` di DSH e l'export di token-usage e rollout della CLI di Codex Desktop.
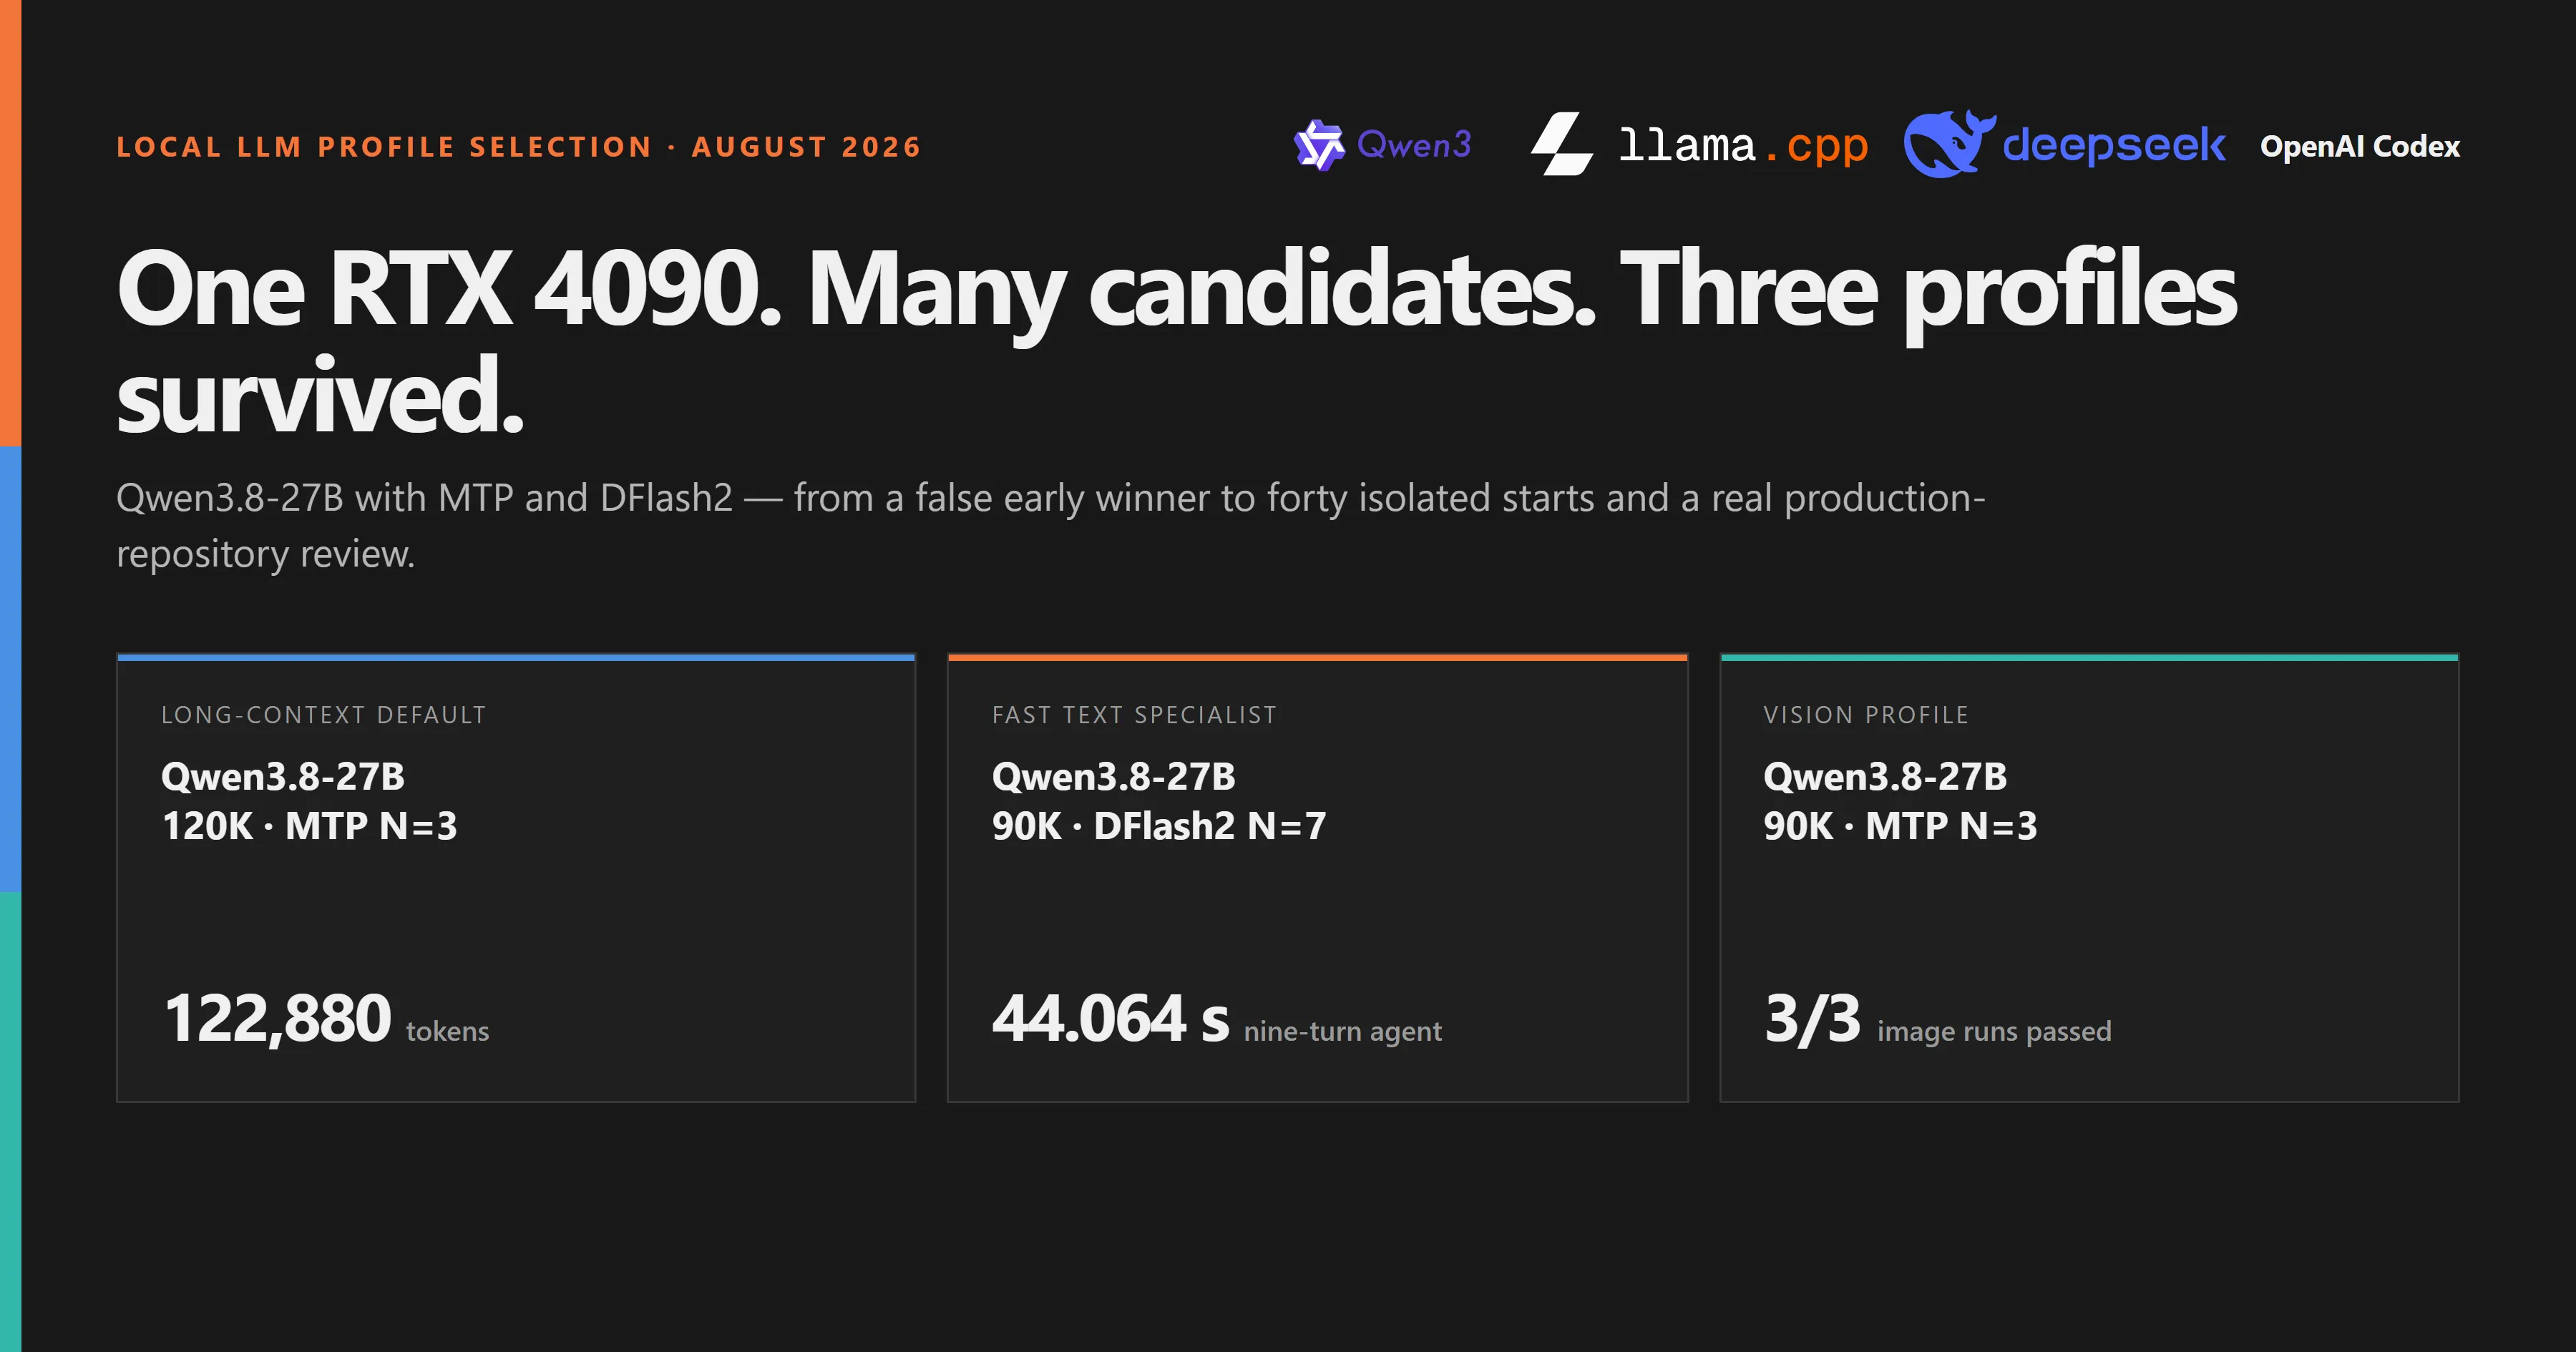
Da molti candidati a tre profili: Qwen3.8-27B con MTP e DFlash2
Su una RTX 4090, i profili MTP e DFlash2 sono stati eliminati fase dopo fase. Il risultato non è un vincitore universale, ma un profilo MTP 120K predefinito, uno specialista testo DFlash2 90K e un profilo vision MTP 90K verificato.
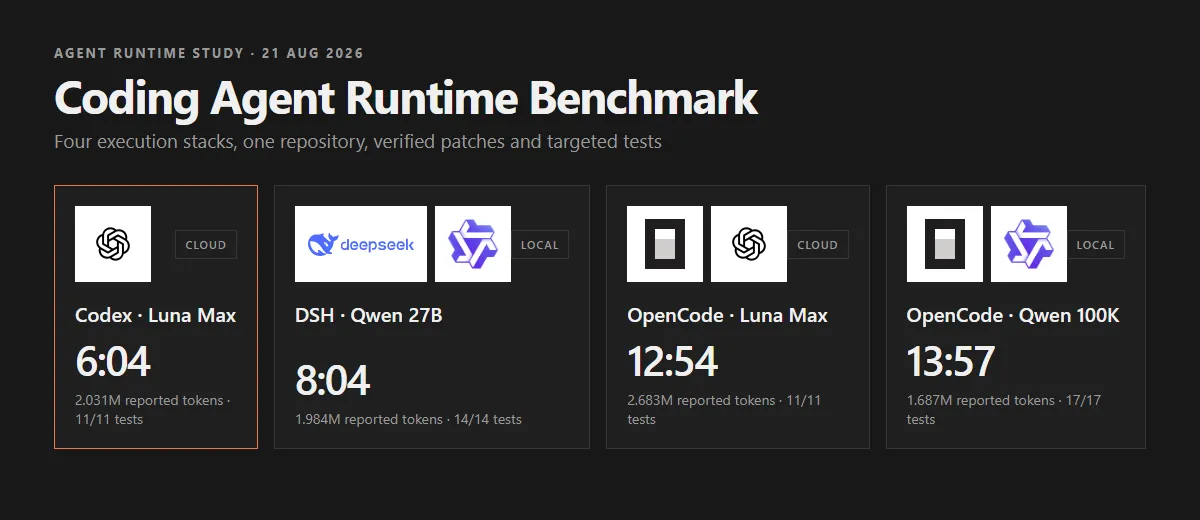
Benchmark degli agenti di codice: l’impatto del runtime
Quattro agenti hanno modificato lo stesso repository e superato i test mirati. La durata variava comunque da 6:04 a 13:57 per l’effetto combinato di modello, harness, cache e revisione.
Quattro agenti IA a confronto: token, tempo e qualità
Lo stesso modello IA, quattro interfacce agentiche e cinque attività reali su repository: le differenze misurate in qualità, token, tempo e metodo di lavoro.