 Cloud
Luna · DSH Standard Mode
11:45
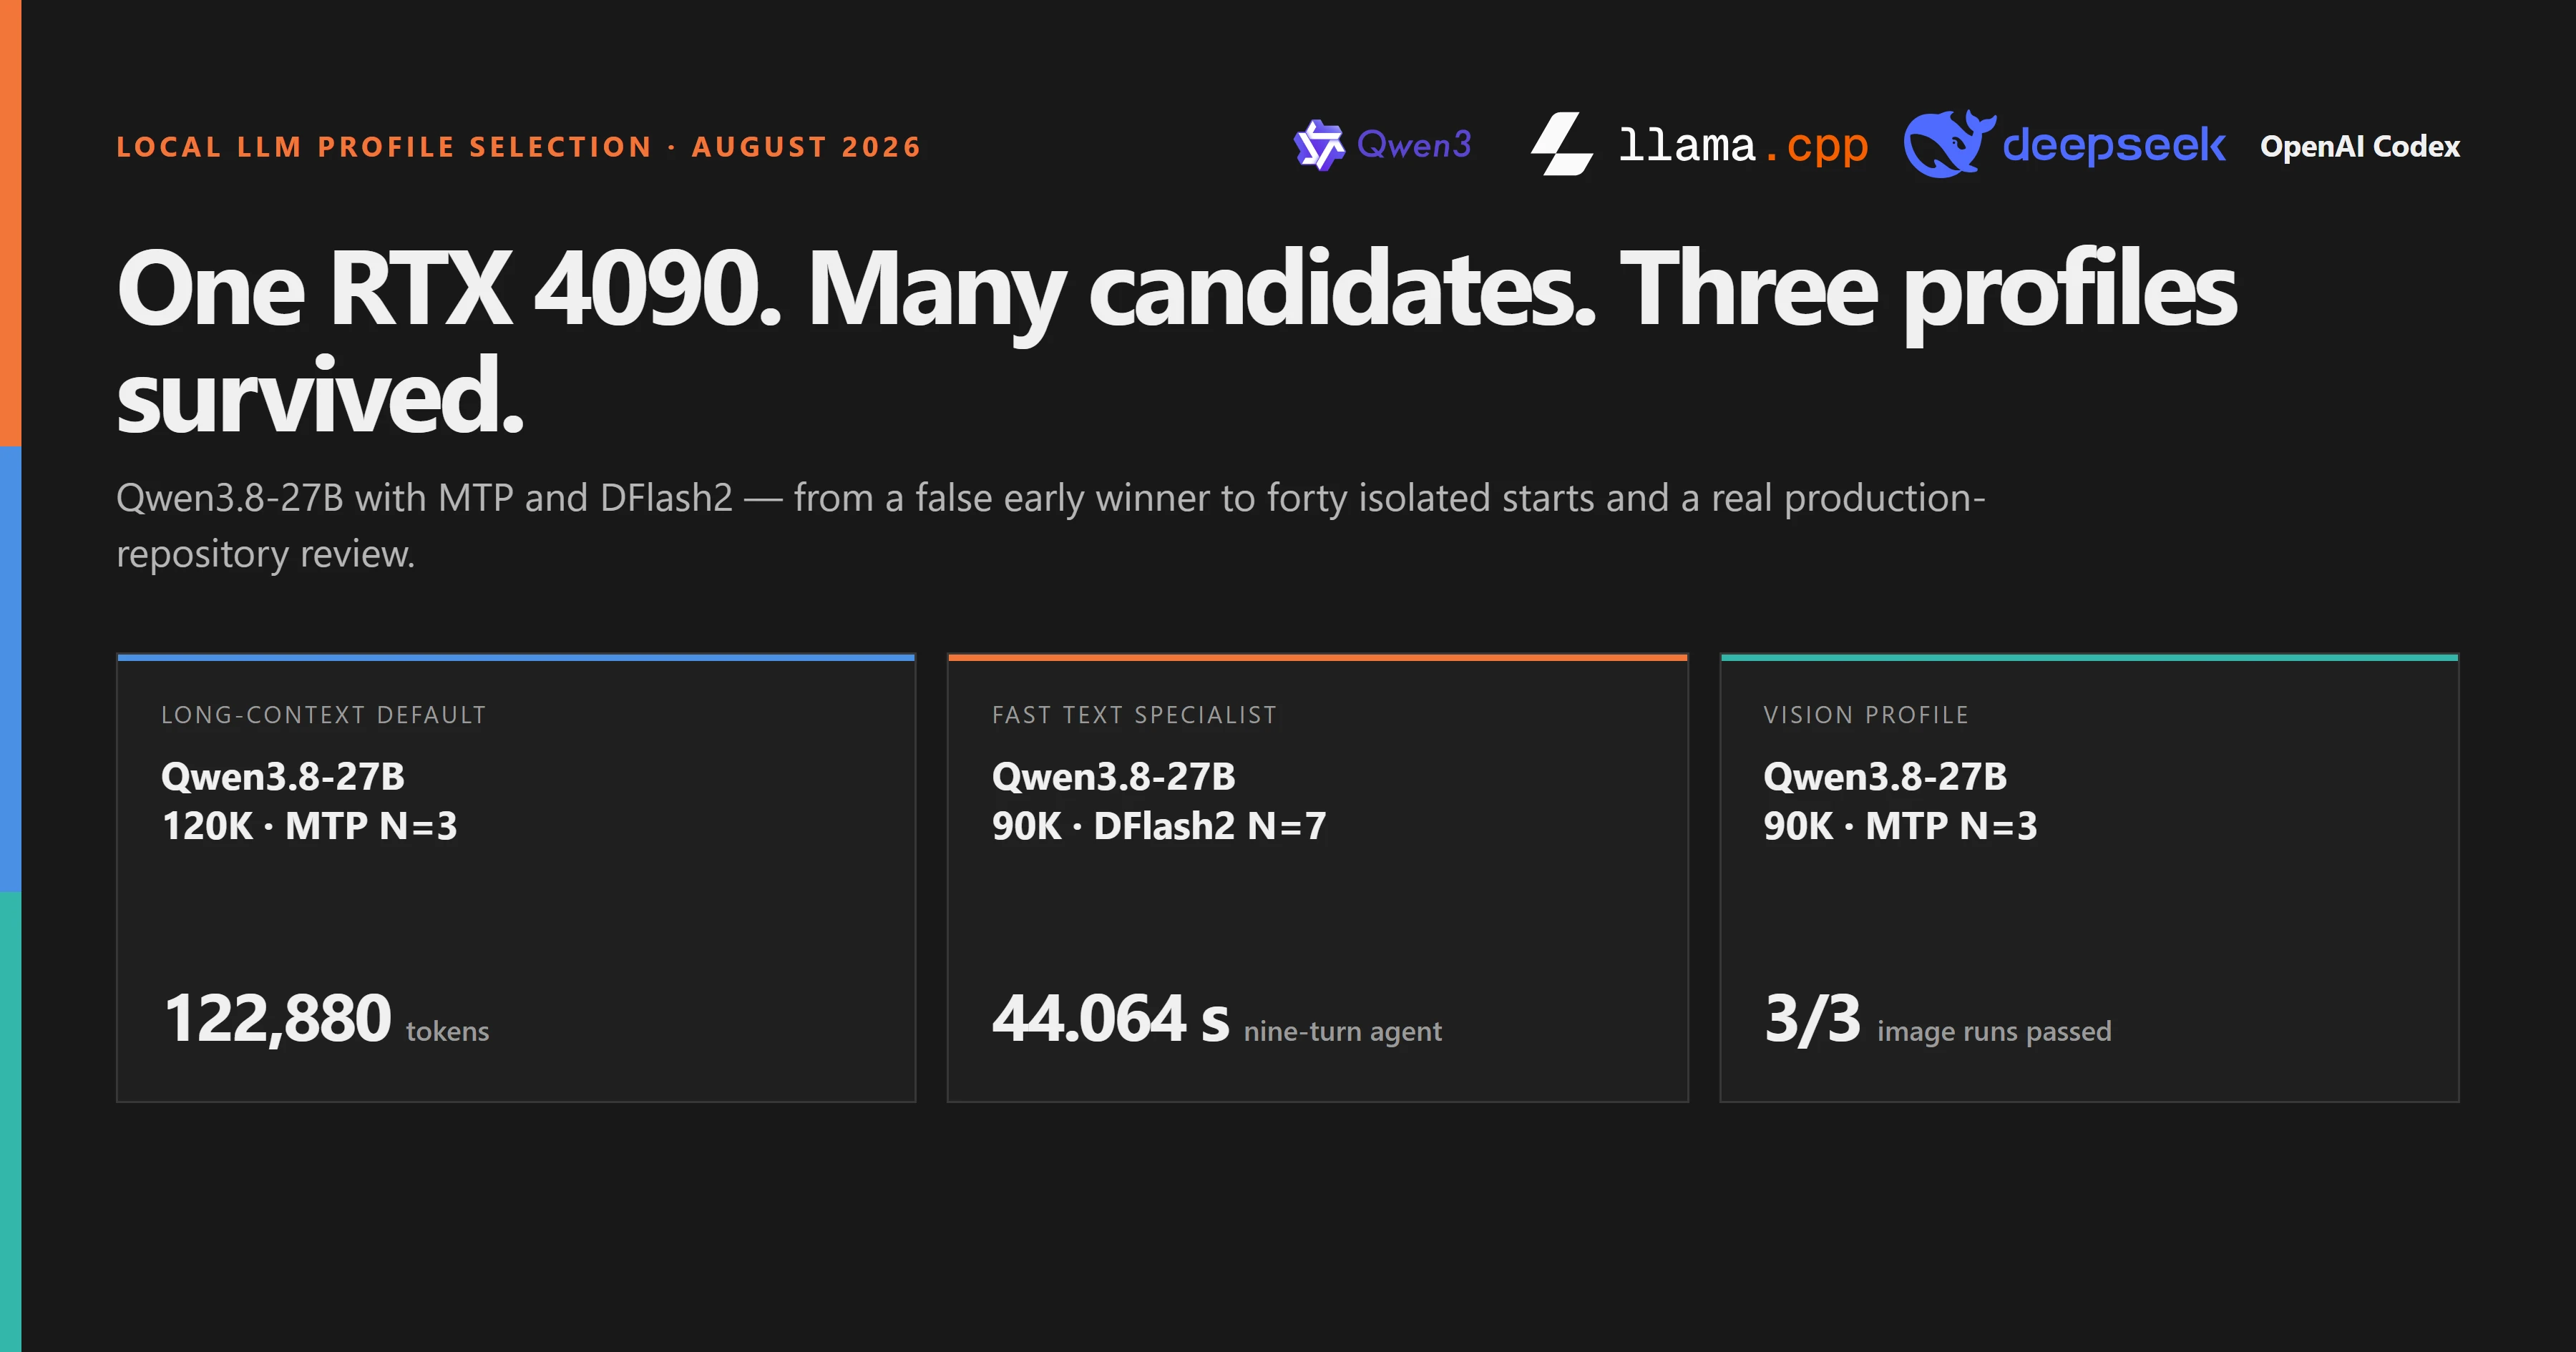
Su una RTX 4090, i profili MTP e DFlash2 sono stati eliminati fase dopo fase. Il risultato non è un vincitore universale, ma un profilo MTP 120K predefinito, uno specialista testo DFlash2 90K e un profilo vision MTP 90K verificato.
Benchmark dei runtime per agenti di codice
Quattro condizioni. Un compito, un repository, una rubrica.
Stesso compito · 99–100/100 punti · netto 11:45–54:48
Cloud11:45
Cloud13:48
 llama.cppLocale
19:57
llama.cppLocale54:48
Quattro condizioni hanno risolto lo stesso compito nello stesso repository e ognuna ha ottenuto 99 o 100 punti su 100. La durata netta del compito — tempo di attesa per l'approvazione e di compattazione automatica del contesto esclusi da ogni misurazione — andava da 11:45 per l'esecuzione cloud tramite modalità standard di DSH a 54:48 per il modello locale senza decodifica speculativa.
Benchmark dei runtime per agenti di codice
Quattro stack di esecuzione. Un repository.
4 modifiche · tutti i test mirati superati · 6:04–13:57
Cloud6:04
Locale8:04
 Cloud
12:54
Locale13:57
Quattro agenti hanno modificato lo stesso repository e superato i test mirati. La durata variava comunque da 6:04 a 13:57 per l’effetto combinato di modello, harness, cache e revisione.
Benchmark delle interfacce agentiche
Un modello. Quattro interfacce.
5 attività · 20 esecuzioni nuove · 12/12 controlli qualità
Lo stesso modello IA, quattro interfacce agentiche e cinque attività reali su repository: le differenze misurate in qualità, token, tempo e metodo di lavoro.
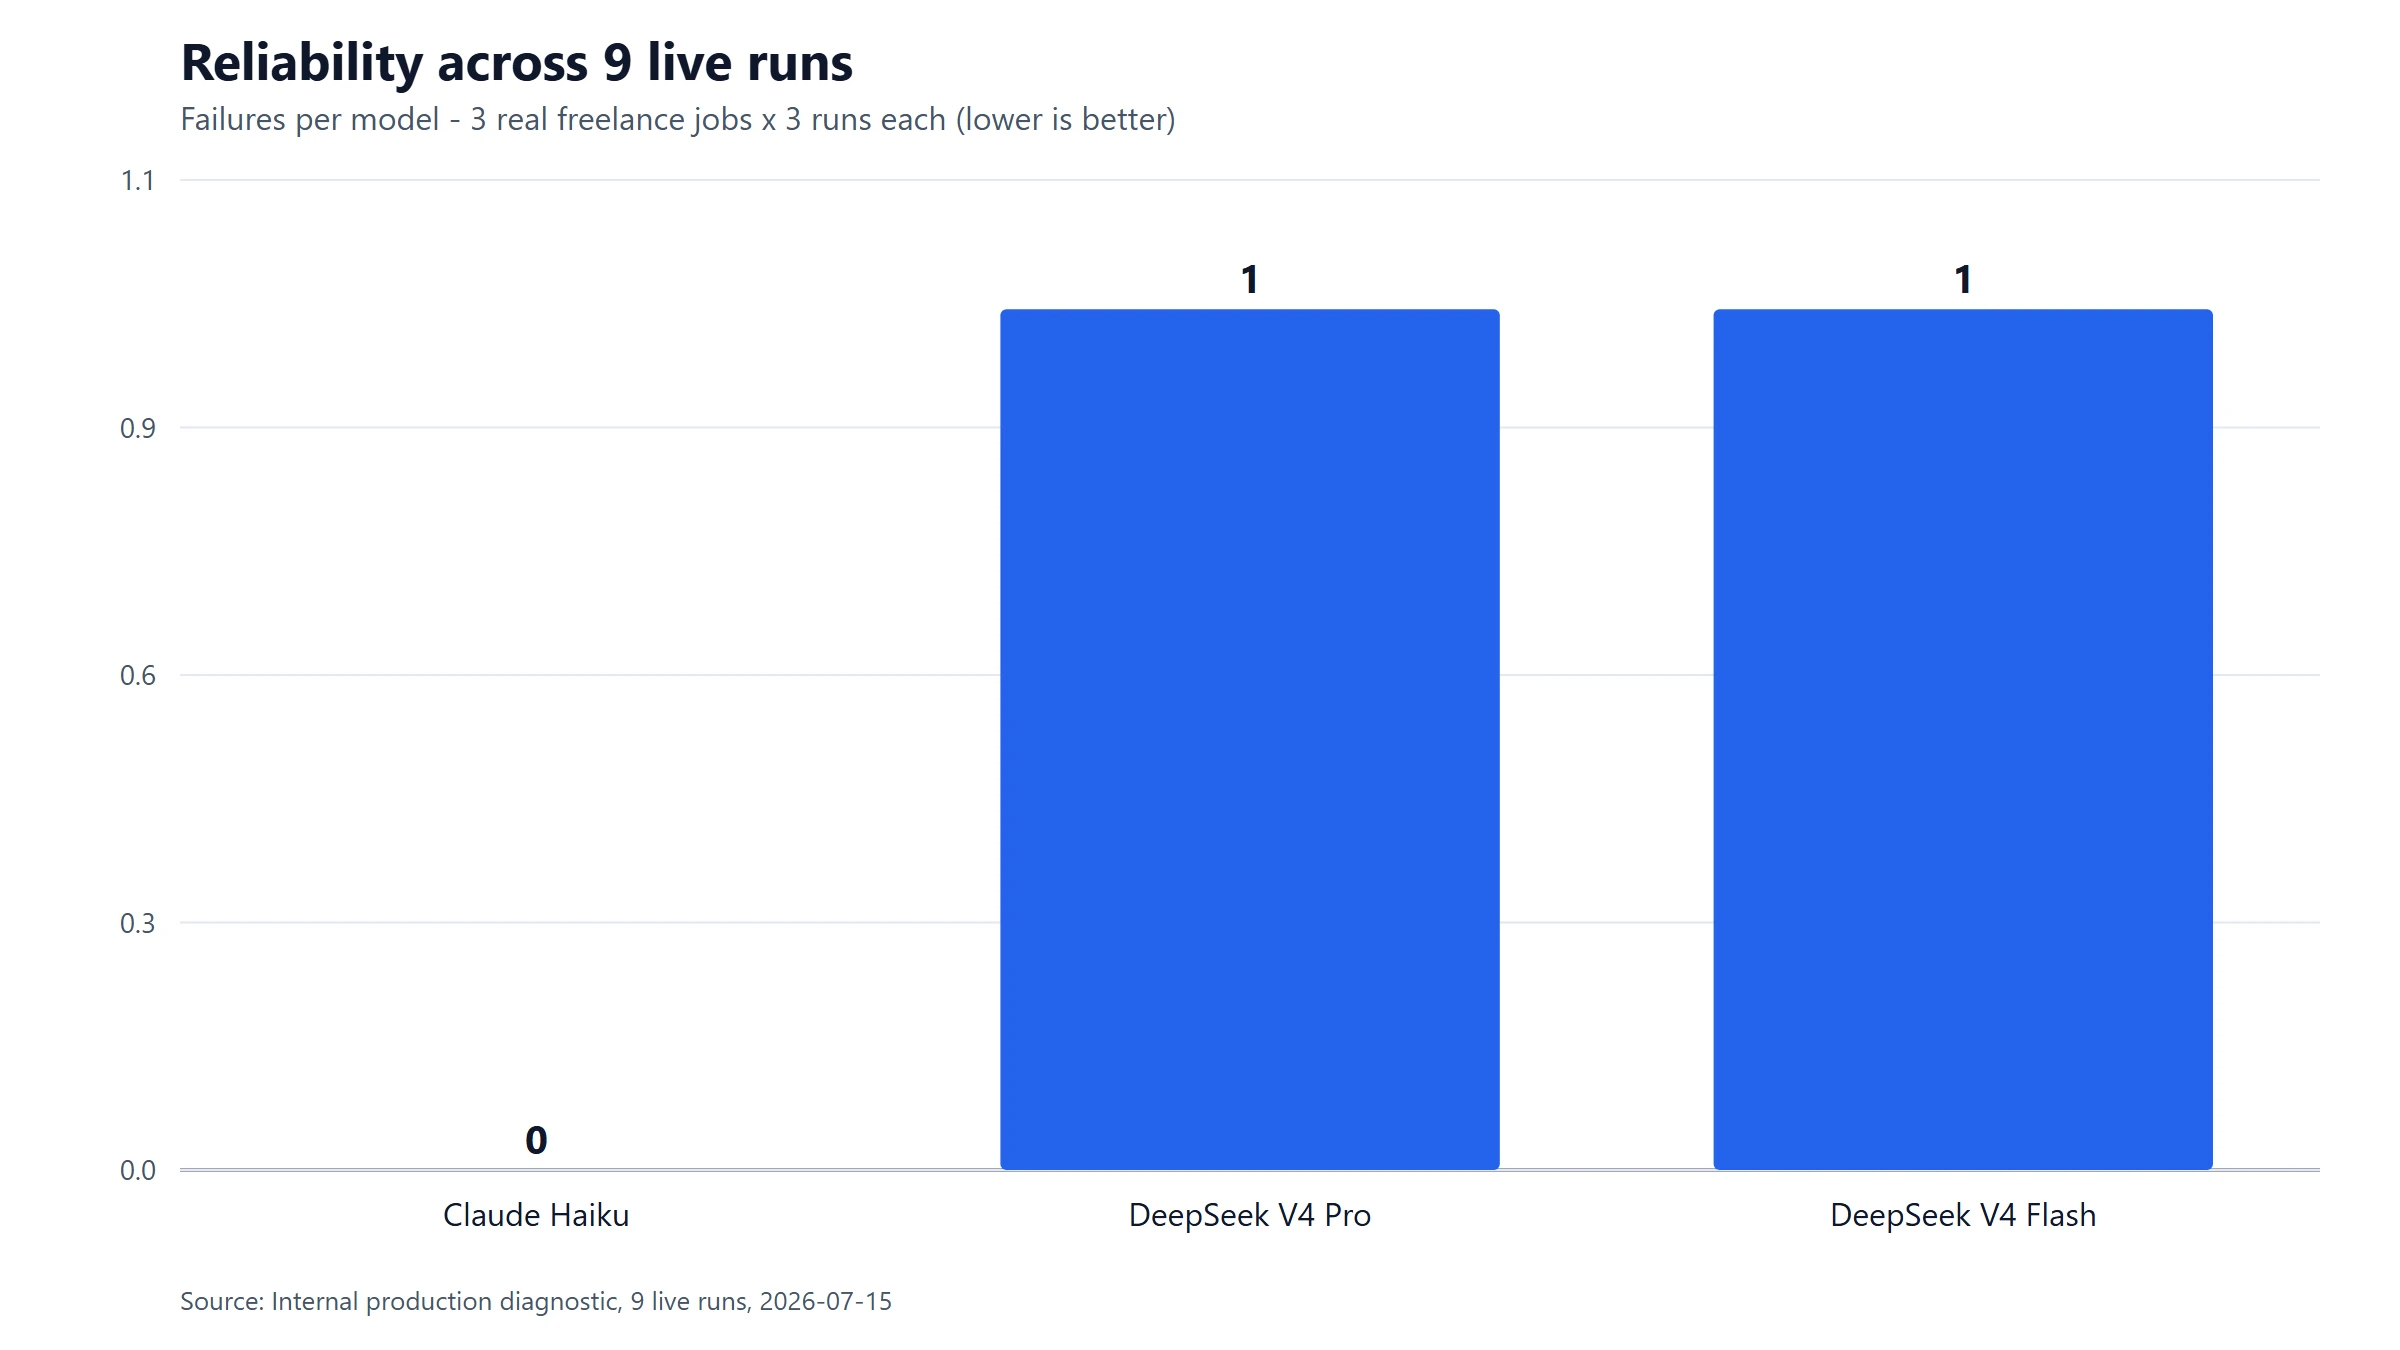
Ho testato Claude Haiku contro DeepSeek V4 Pro e Flash sulla mia pipeline IA per scrivere proposte, usando tre incarichi freelance reali.