 Cloud
Codex · Luna Max
6:04
Benchmark dei runtime per agenti di codice
Quattro stack di esecuzione. Un repository.
4 modifiche · tutti i test mirati superati · 6:04–13:57
Cloud6:04
 Locale
8:04
 Cloud
12:54
Locale13:57
Rilevato: 2026-08-21T12:39:07+02:00
Sistema operativo
Windows 11 Pro
CPU
AMD Ryzen 9 7950X
Core
16C/32T
RAM
128 GB
GPU / VRAM
NVIDIA GeForce RTX 4090 / 24 GB
Driver GPU
610.88
| Esecuzione | Runtime | Modello | Formato / quantizzazione | Contesto / KV cache | Backend |
|---|---|---|---|---|---|
| Codex · Luna Max (Cloud) | Codex CLI 0.148.0-alpha.21 | gpt-5.6-luna (GPT-5.6 Luna Max) | non dichiarato dal fornitore | 258400 tokens / non dichiarato dal fornitore | non dichiarato dal fornitore |
| DSH · Qwen 3.8 27B (Locale) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-Q4-100K-Q8 (Qwen 3.8 27B Q4 (100K Q8 KV)) | GGUF / Q4 | 100K (102400 tokens) / Q8 | llama.cpp |
| OpenCode · Luna Max (Cloud) | OpenCode 1.18.19 | GPT-5.6 Luna | non dichiarato dal fornitore | non dichiarato dal fornitore / non dichiarato dal fornitore | non dichiarato dal fornitore |
| OpenCode · Qwen 100K (Locale) | OpenCode 1.18.19 | Qwen3.8-27B Q4 (100K Q8 KV) | GGUF / Q4 | 100K / Q8 | llama.cpp |
L’hardware è stato riverificato sulla stessa macchina al termine delle sessioni. I valori per esecuzione provengono dagli export di sessione conservati; ciò che non è stato registrato è segnalato come tale invece di essere stimato.
La quantizzazione dei pesi (Q4) e quella della KV cache (Q8) sono volutamente riportate come dati separati per le esecuzioni Qwen.
Quattro modifiche diverse · tutti i test mirati superati
Il benchmark misura l’intero stack di esecuzione
Il modello è solo uno degli input del tempo totale e del volume di token.
Prompt di sistema, skill, memoria e regole di pianificazione
Input nuovo, letture cache, compattazione e continuazione
Lettura del repository, modifiche, comandi e test
Risposte utente, reviewer e regole di verifica
Ambito della modifica, test mirati e consegna finale
Secondi · meno è meglio
Milioni di token · non è un punteggio diretto di velocità
Harness diretto = 1,00 · meno è meglio
Codex omesso perché mancavano contatori esportati comparabili
Percentuale · input nuovo rispetto alle letture cache
Secondi · revisione rispetto al resto del tempo misurato
Migliaia di token · output più reasoning dichiarato separatamente
| Runtime | Modifica selezionata | File | Test | Risultato |
|---|---|---|---|---|
| Codex · Luna Max | Compatibilità ValueError e protezione per flashcard non-oggetto | 2 | 11 | 11/11 |
| DSH · Qwen 27B | Salvataggio atomico di RunKeyStore con file temporaneo e os.replace | 2 | 14 | 14/14 |
| OpenCode · Luna Max | FlashcardValidationError eredita da ValueError | 3 | 11 | 11/11 |
| OpenCode · Qwen 100K | Correzione degli spazi OCR nel calcolo del garbage ratio | 2 | 17 | 17/17 |
Quattro sessioni di agenti di codice hanno ricevuto lo stesso repository e lo stesso incarico generale. Ogni sessione ha prodotto una modifica e superato i test mirati. La durata end-to-end variava comunque da 6:04 a 13:57.
Codex con Luna Max è stata l’esecuzione osservata più breve. DSH con Qwen 3.8 27B è stata la più breve tra quelle locali. Entrambe le configurazioni OpenCode hanno richiesto più tempo, anche se OpenCode Qwen dichiarava il volume totale di token più basso.
La conclusione principale non è quindi una classifica universale dei modelli. Un agente di codice comprende anche istruzioni di sistema, skill, memoria, gestione del contesto, cache, strumenti, gate utente, politica di revisione e verifica finale.
Le quattro sessioni partivano dallo stesso repository e dallo stesso incarico astratto, ma non erano obbligate a scegliere lo stesso difetto. Le esecuzioni Luna sono arrivate nella stessa area delle flashcard con ambiti diversi. Le due esecuzioni Qwen hanno selezionato altri difetti.
Il test confronta quindi profili runtime completi, non quattro modelli in una condizione controllata con lo stesso patch. Una sessione può durare di più per la generazione, per un maggior numero di azioni degli strumenti, per una revisione indipendente o per compattazione e continuazione del contesto.
OpenCode Luna ha richiesto 2,13 volte il tempo di Codex Luna. OpenCode Qwen ha richiesto 1,73 volte il tempo di DSH Qwen. Allo stesso tempo, OpenCode Qwen è stata la sessione più lunga pur dichiarando meno token. Un volume inferiore non è quindi automaticamente un punteggio di velocità o qualità.
Anche gli schemi dei token differiscono. Codex include il reasoning nell’output. OpenCode lo espone separatamente e combina input nuovo e letture cache nel totale del prompt. DSH fornisce totali di prompt e output. I valori normalizzati descrivono un carico di lavoro, non direttamente fattura, energia o limite di abbonamento.
In entrambe le sessioni OpenCode, oltre il 91 per cento del volume lato prompt proveniva dalle letture cache. OpenCode Luna dichiarava 220.630 token di input nuovo e 2.451.456 token di cache; OpenCode Qwen rispettivamente 145.146 e 1.514.973.
DSH Qwen ha usato 36 turni assistente e 57 chiamate agli strumenti. OpenCode Luna ha usato 32 turni e 67 chiamate; OpenCode Qwen 31 turni e 39 chiamate. L’export Codex non esponeva contatori direttamente comparabili, quindi è omesso da questa vista invece di ricevere uno zero fuorviante.
OpenCode Luna ha attivato brainstorming, scrittura del piano, sviluppo guidato dai test, code review e verifica prima del completamento. Il reviewer ha rappresentato circa 299 secondi, cioè il 38,6 per cento della sessione. Questo processo può essere utile per una modifica grande o rischiosa. Per un piccolo fix, il suo costo fisso è diventato una parte sostanziale del tempo totale.
Codex Luna usava le linee guida di Karpathy e una memoria di lavoro precedente. Questi input possono aver favorito una modifica più piccola, ipotesi esplicite e verifica diretta, ma una singola esecuzione non consente di misurarne l’effetto indipendente. Serve un braccio sperimentale skill attive contro skill disattivate.
Ogni condizione è stata eseguita una sola volta. Gli agenti non hanno implementato lo stesso patch, gli export dei token usano semantiche diverse e Qwen funzionava localmente mentre Luna usava il cloud. Il numero di test non è una classifica di qualità perché gli ambiti erano differenti.
Un test successivo più solido dovrebbe imporre un solo difetto, un unico test di accettazione, gli stessi strumenti, le stesse istruzioni di sistema e limiti uguali di contesto e timeout. Ogni condizione dovrebbe essere ripetuta almeno tre volte. Per Qwen vanno registrati hardware, quantizzazione, limite di contesto, formato della KV cache e throughput di generazione. Timestamp per ogni fase separerebbero finalmente latenza del modello, strumenti e revisione.
Le misure sono state ricostruite da quattro export conservati: `lunamax-session.jsonl`, `session.jsonl`, `session-ses_fdda.md` e `session-ses_fdd8.md`.
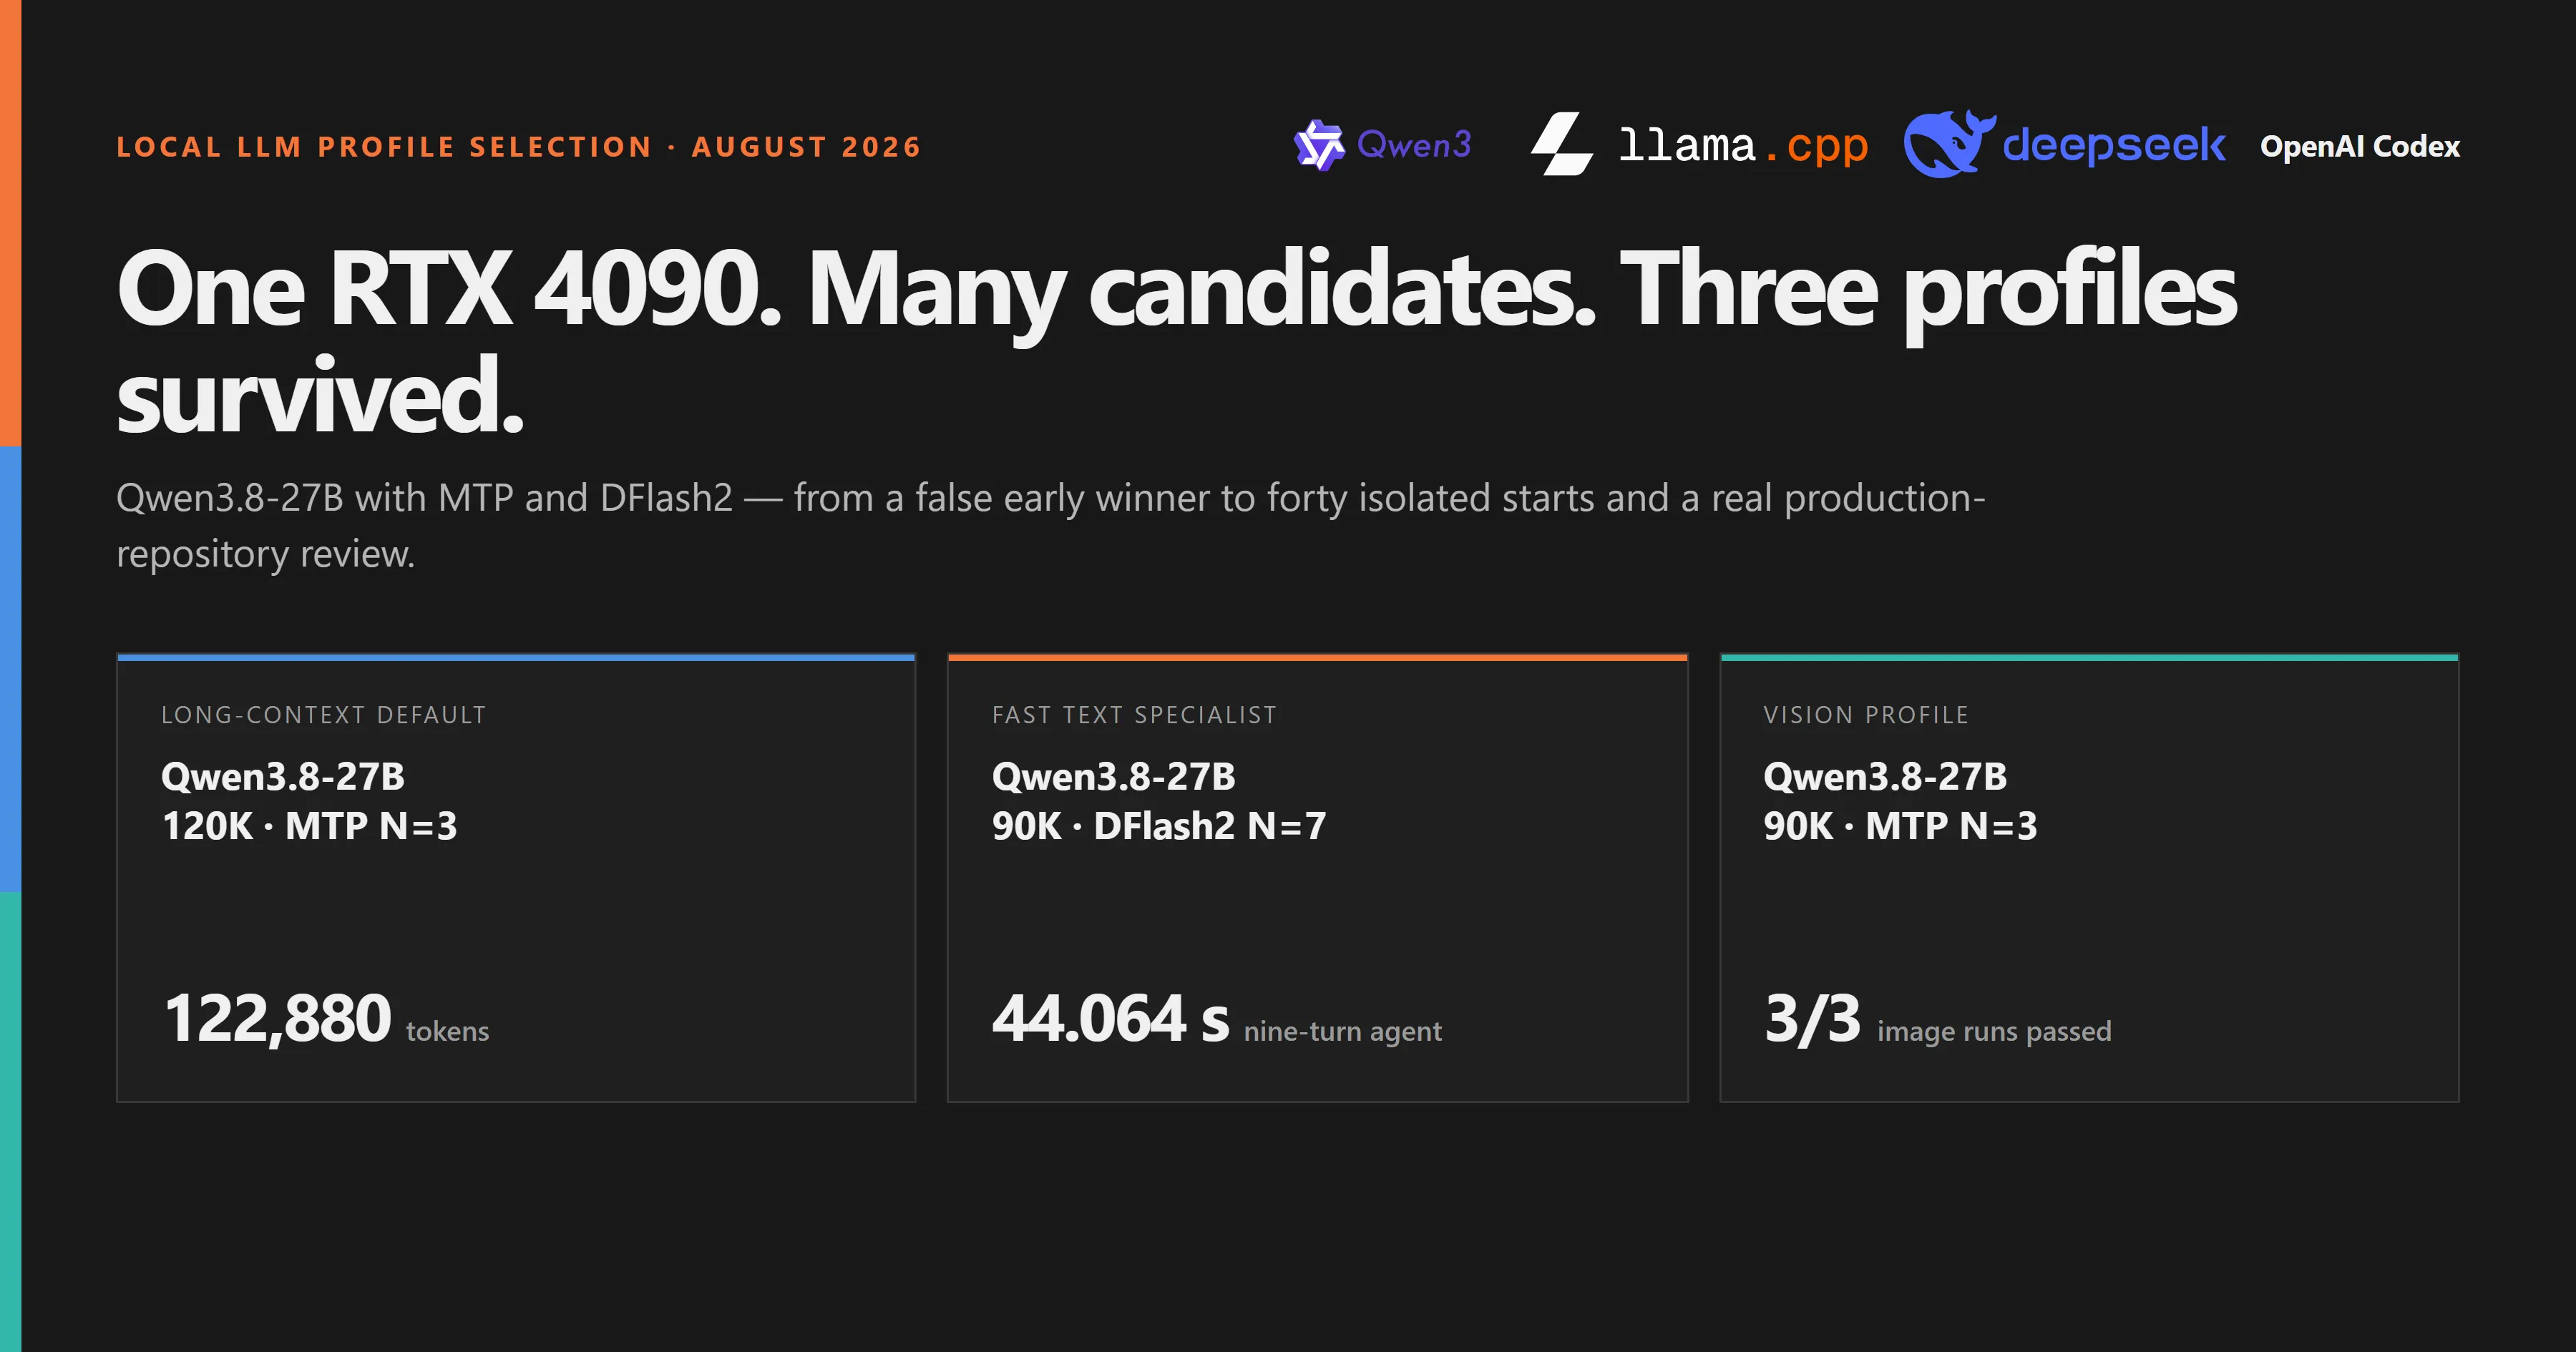
Da molti candidati a tre profili: Qwen3.8-27B con MTP e DFlash2
Su una RTX 4090, i profili MTP e DFlash2 sono stati eliminati fase dopo fase. Il risultato non è un vincitore universale, ma un profilo MTP 120K predefinito, uno specialista testo DFlash2 90K e un profilo vision MTP 90K verificato.
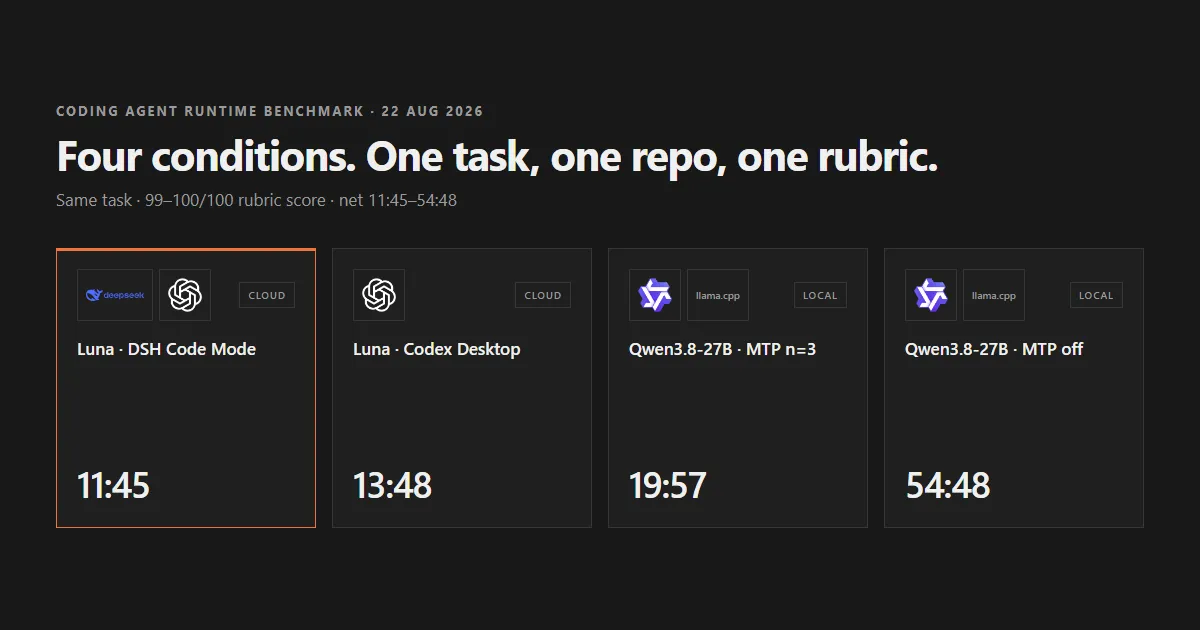
Quattro condizioni, un compito: quanto costano davvero la decodifica speculativa e la scelta dello strumento agente
Quattro condizioni hanno risolto lo stesso compito nello stesso repository e ognuna ha ottenuto 99 o 100 punti su 100. La durata netta del compito — tempo di attesa per l'approvazione e di compattazione automatica del contesto esclusi da ogni misurazione — andava da 11:45 per l'esecuzione cloud tramite modalità standard di DSH a 54:48 per il modello locale senza decodifica speculativa.
Quattro agenti IA a confronto: token, tempo e qualità
Lo stesso modello IA, quattro interfacce agentiche e cinque attività reali su repository: le differenze misurate in qualità, token, tempo e metodo di lavoro.