 Cloud
Luna · DSH Standard Mode
11:45
Coding-Agent-Laufzeitbenchmark
Vier Bedingungen. Eine Aufgabe, ein Repository, eine Rubrik.
Gleiche Aufgabe · 99–100/100 Punkte · netto 11:45–54:48
Cloud11:45
Cloud13:48
 llama.cppLokal
19:57
llama.cppLokal54:48
Erfasst: 2026-08-22T09:15:00+02:00
Betriebssystem
Windows 11 Pro
CPU
AMD Ryzen 9 7950X
Kerne
16C/32T
RAM
128 GB
GPU / VRAM
NVIDIA GeForce RTX 4090 / 24 GB
GPU-Treiber
610.88
| Lauf | Runtime | Modell | Format / Quantisierung | Kontext / KV-Cache | Backend |
|---|---|---|---|---|---|
| Qwen3.8-27B · MTP off (Lokal) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-UD-Q4_K_XL.gguf (spec. decoding: none) | GGUF / UD-Q4_K_XL | 131072 tokens (128K) / Q8 (q8_0 K, q8_0 V) | llama.cpp llama-server 0.1.0-rc.8 |
| Qwen3.8-27B · MTP n=3 (Lokal) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-UD-Q4_K_XL.gguf (spec. decoding: draft-mtp, n=3) | GGUF / UD-Q4_K_XL | 131072 tokens (128K) / Q8 (q8_0 K, q8_0 V) | llama.cpp llama-server 0.1.0-rc.8 |
| Luna · DSH Standard Mode (Cloud) | DeepSeek Harness (dsh), openai-codex provider, 0.1.0-rc.8 | gpt-5.6-luna (reasoning effort: max) | vom Anbieter nicht offengelegt | 272000 tokens / vom Anbieter nicht offengelegt | vom Anbieter nicht offengelegt |
| Luna · Codex Desktop (Cloud) | Codex Desktop 0.149.0-alpha.4.1 | gpt-5.6-luna (reasoning effort: max) | vom Anbieter nicht offengelegt | 258400 tokens / vom Anbieter nicht offengelegt | vom Anbieter nicht offengelegt |
Die Werte pro Lauf stammen aus dem jeweiligen Sitzungsexport (DSH-Sitzungskopfzeilen bzw. Codex Desktops eigenem Token-Nutzungs-/Rollout-Export); die Hardware wurde am 22.08.2026 auf derselben Maschine erneut überprüft.
Die beiden Cloud-Läufe melden in ihren eigenen Sitzungskopfzeilen unterschiedliche Kontextfenster (272’000 gegenüber 258’400 Tokens) für dasselbe Modell, am wahrscheinlichsten durch unterschiedliche Provider-/Routing-Pfade bedingt und nicht durch einen echten Modellunterschied.
Vier Bedingungen · 99–100/100 Punkte
Was die rohe Sitzungsdauer tatsächlich enthält
Zwei der drei folgenden Bestandteile haben nichts mit der eigentlichen Modellarbeit zu tun.
Modell, Werkzeuge und Orchestrierung, die tatsächlich arbeiten
Menschliche Reaktionszeit auf eine Sandbox-Eskalationsanfrage
Der automatische Zusammenfassungsaufruf des Tools, sobald der Kontext voll ist, unaufgefordert ausgelöst
Weniger ist besser · Minuten, bereinigt um Freigabe-Wartezeit und Kompaktierung
Zusammensetzung der rohen Sitzungsdauer; die Netto-Aufgabenzeit bleibt übrig
Höher ist besser · Output-Tokens pro Sekunde, netto nach Bereinigung
Eigene Zählweise jedes Systems; keine gemeinsame Einheit zwischen lokal und Cloud (siehe Grenzen)
Anzahl einzelner Tool-Aufrufe; keine Richtung ist per se besser
Höher ist besser · von 100 Punkten, bewertet von einem Reviewer, der den Diff gelesen und selbst verifiziert hat
| Bedingung | Korrektheit /45 | Tests /20 | Robustheit /15 | Wartbarkeit /10 | Scope /10 | Gesamt |
|---|---|---|---|---|---|---|
| Luna · DSH Standard Mode | 45 | 20 | 15 | 10 | 10 | 100 |
| Luna · Codex Desktop | 44 | 20 | 15 | 10 | 10 | 99 |
| Qwen3.8-27B · MTP n=3 | 45 | 20 | 15 | 9 | 10 | 99 |
| Qwen3.8-27B · MTP off | 45 | 20 | 15 | 10 | 10 | 100 |
Vier unabhängige, isolierte Kopien desselben Cloudflare-Worker-Repositorys erhielten dieselbe Aufgabe auf demselben Commit: ein dauerhaftes D1-Ledger, damit ein Telegram-Webhook-Update niemals doppelt verarbeitet wird — auch nicht bei gleichzeitigen Duplikaten oder einem mehrdeutigen, vorübergehenden Datenbankfehler — plus ein 14-Tage-Aufräumjob, der nur abgeschlossene Zeilen löscht. Vier Bedingungen bearbeiteten sie: ein lokales Qwen3.8-27B mit ausgeschalteter spekulativer Dekodierung, dasselbe Modell mit eingeschalteter spekulativer Dekodierung (draft-mtp, n=3), sowie ein gehostetes GPT-5.6 „Luna" mit Reasoning-Stufe „max" über zwei verschiedene Agenten-Tools: DSH-Standardmodus und OpenAIs eigenes Codex Desktop. Ein unabhängiger Reviewer bewertete anschliessend jede Einreichung anhand derselben 100-Punkte-Rubrik, indem er den Diff las, `type-check` und die Testsuite selbst ausführte und alle 11 geforderten Testszenarien einzeln prüfte.
Alle vier landeten bei 99 oder 100 von 100 Punkten. Die Codequalität war also nicht das, was die vier Bedingungen bei dieser Aufgabe unterschied — die Netto-Aufgabendauer war es. Für jede Bedingung wurden Freigabe-Wartezeit und automatische Kontext-Kompaktierung aus der gemessenen Zeit herausgerechnet, denn beides ist Overhead, keine Modellarbeit; alle Zeiten unten sind bereits Netto-Werte.
DSH-Standardmodus stellt für sandboxüberschreitende Befehle eine Freigabeanfrage (etwa damit Vitests Config-Loader einen Kindprozess starten darf) und wartet, bis ein Mensch auf „Erlauben" klickt; die Zeit zwischen Anfrage und Klick ist reine Reaktionszeit, keine Agentenarbeit, und wurde deshalb aus der Messung entfernt. Zusätzlich löst DSH, sobald das Kontextfenster voll ist, von sich aus einen automatischen Zusammenfassungsaufruf aus — ohne menschliches Zutun, aber mit echtem Zeitverbrauch; auch diese Zeit zählt nicht zur Netto-Aufgabendauer.
Ein einziger Freigabe-Klick allein machte 11:53 Minuten aus, die aus der DSH+Luna-Sitzung herausgerechnet wurden. Die Netto-Aufgabenzeit von DSH-Standardmodus + Luna liegt bei 11:45 — vor Codex Desktops 13:48, wo keine vergleichbare Freigabeanfrage anfiel. Dieselbe Rechnung gilt für die beiden lokalen Qwen-Läufe: Bei MTP aus wurden 5:54 Minuten aus zwei automatischen Kompaktierungen herausgerechnet, bei MTP n=3 nur 1:42 aus einer.
Die Netto-Aufgabenzeit desselben lokalen Modells fiel von 54:48 mit ausgeschalteter spekulativer Dekodierung auf 19:57 mit eingeschalteter — 2,7-mal schneller, bei einem Anstieg des Output-Durchsatzes von 33,8 auf 55,5 Tokens pro Sekunde. Die Anzahl der Tool-Aufrufe bewegte sich in die Gegenrichtung: MTP aus benötigte 93 Aufrufe für dasselbe Ergebnis, MTP n=3 nur 61. Keine dieser Zahlen ist geschätzt; beide stammen direkt aus den Tool-Aufruf-Ereignissen der DSH-Sitzung.
Nein. Jede Einreichung bestand `type-check` und ihre vollständige Testsuite, deckte alle 11 geforderten Testszenarien mit verhaltensbasierten Assertions statt reinem SQL-String-Abgleich ab und implementierte den schwierigsten Teil der Spezifikation korrekt: eine atomare SQL-Claim (`INSERT ... ON CONFLICT`) mit demselben, über Wiederholungsversuche hinweg wiederverwendeten Claim-Token, sodass ein verlorenes Antwort-dann-Retry-Auslesen als der eigene erfolgreiche Claim des Aufrufers erkannt wird statt als Duplikat. Niemand rührte eine verbotene Datei an, fügte eine Abhängigkeit hinzu oder zeigte irgendein Anzeichen von Delegation. Die beiden Ein-Punkt-Abzüge waren beide reine Platzierungs-Kritikpunkte — die Aufräumroutine wurde bei jedem angenommenen Webhook statt über den vorhandenen Cron-Trigger ausgelöst, und eine Abschlussfunktion wuchs etwas über die Vorgabe „Route klein halten" hinaus — keine Verhaltensfehler.
Ein Reviewer, der die Luna/Codex-Desktop-Einreichung bearbeitete, entdeckte etwas, das die Rubrik nicht bewertet. Diese Einreichung erzeugt den Claim-Token bei jedem Worker-Aufruf neu, statt ihn deterministisch aus der Update-ID abzuleiten. Meldet jeder Versuch innerhalb einer einzigen Zustellungs-Retry-Schleife dem Aufrufer einen vorübergehenden Fehler, während einer dieser Versuche tatsächlich still committet hat, bleibt die Zeile im Zustand „processing" mit einem Token, das kein zukünftiger Request kennt. Eine erneute Telegram-Zustellung ist ein neuer HTTP-Request mit einem neu erzeugten Token; er liest das nun abweichende Token der bestehenden Zeile aus, behandelt es als fremden Claim, und das Update kann dauerhaft hängen bleiben. Da die Aufräumroutine nur abgeschlossene Zeilen löscht, wird sie auch nie bereinigt. Dies wurde nicht unabhängig gegen den genauen Token-Erzeugungscode der anderen drei Implementierungen geprüft — behandeln Sie es also als eine bei allen vieren prüfenswerte Frage, nicht als bestätigten Fehler in einer einzelnen.
Dies ist eine einzelne Wiederholung pro Bedingung, ein Pilotversuch. Das Manifest des Benchmarks selbst empfiehlt mindestens drei Wiederholungen pro Bedingung mit neu randomisierter Reihenfolge, bevor eine Rangfolge als endgültig gilt. Lokale und Cloud-Token-Zählung sind keine gemeinsame Einheit — DSH summiert frische Eingabe, Output und Cache-Lesevorgänge als drei getrennte additive Zähler, während Codex Desktop einen kumulativen Eingabezähler meldet, in dem gecachte Eingabe bereits eine Teilmenge ist — bilden Sie also über diese Grenze hinweg kein Verhältnis. Output-Tokens pro Sekunde ist ein Mass für „Zeit bis zum nutzbaren Ergebnis", kein isolierter Dekodier-Geschwindigkeitswert: Es enthält Tool-Ausführungszeit bei jedem Lauf sowie Netzwerk- und API-Wartezeit bei den beiden Cloud-Läufen. Die beiden Cloud-Läufe melden in ihren eigenen Sitzungskopfzeilen unterschiedliche Kontextfenster für dasselbe Modell — nicht unabhängig aufgeklärt, möglicherweise durch unterschiedliche Provider-Routing-Pfade statt eines echten Modellunterschieds bedingt. Das oben beschriebene Risiko der hängenbleibenden Zeile wurde in einer Einreichung identifiziert und nicht unabhängig gegen den genauen Token-Erzeugungscode der anderen drei geprüft.
Das saubere Ergebnis dieses Tests ist der Vergleich der spekulativen Dekodierung: dasselbe Modell, dieselbe Hardware, ein geänderter Schalter, ein 2,7-facher Unterschied ohne Qualitätseinbusse in diesem Lauf. Das unordentlichere Ergebnis ist der Vergleich der Agenten-Tools: DSH-Standardmodus und Codex Desktop erzeugten beim selben Modell und derselben Aufgabe eine deutlich unterschiedliche Menge an aufgabenfremdem Mehraufwand, und dieser Mehraufwand war unsichtbar, bis die Sitzungsprotokolle Ereignis für Ereignis gelesen wurden. Bevor eine der beiden Zahlen als Eigenschaft des Tools statt dieses einen Laufs gelten kann, braucht es drei Wiederholungen pro Bedingung mit randomisierter Reihenfolge — und idealerweise eine Freigabe-Logik, die die Reaktionszeit eines Menschen nicht mitten in eine routinemässige Sandbox-Eskalation stellt.
Die Messwerte wurden aus vier aufbewahrten Sitzungsexporten rekonstruiert: drei DSH-`session.jsonl`-Dateien sowie dem Token-Nutzungs- und Rollout-Export der Codex-Desktop-CLI.
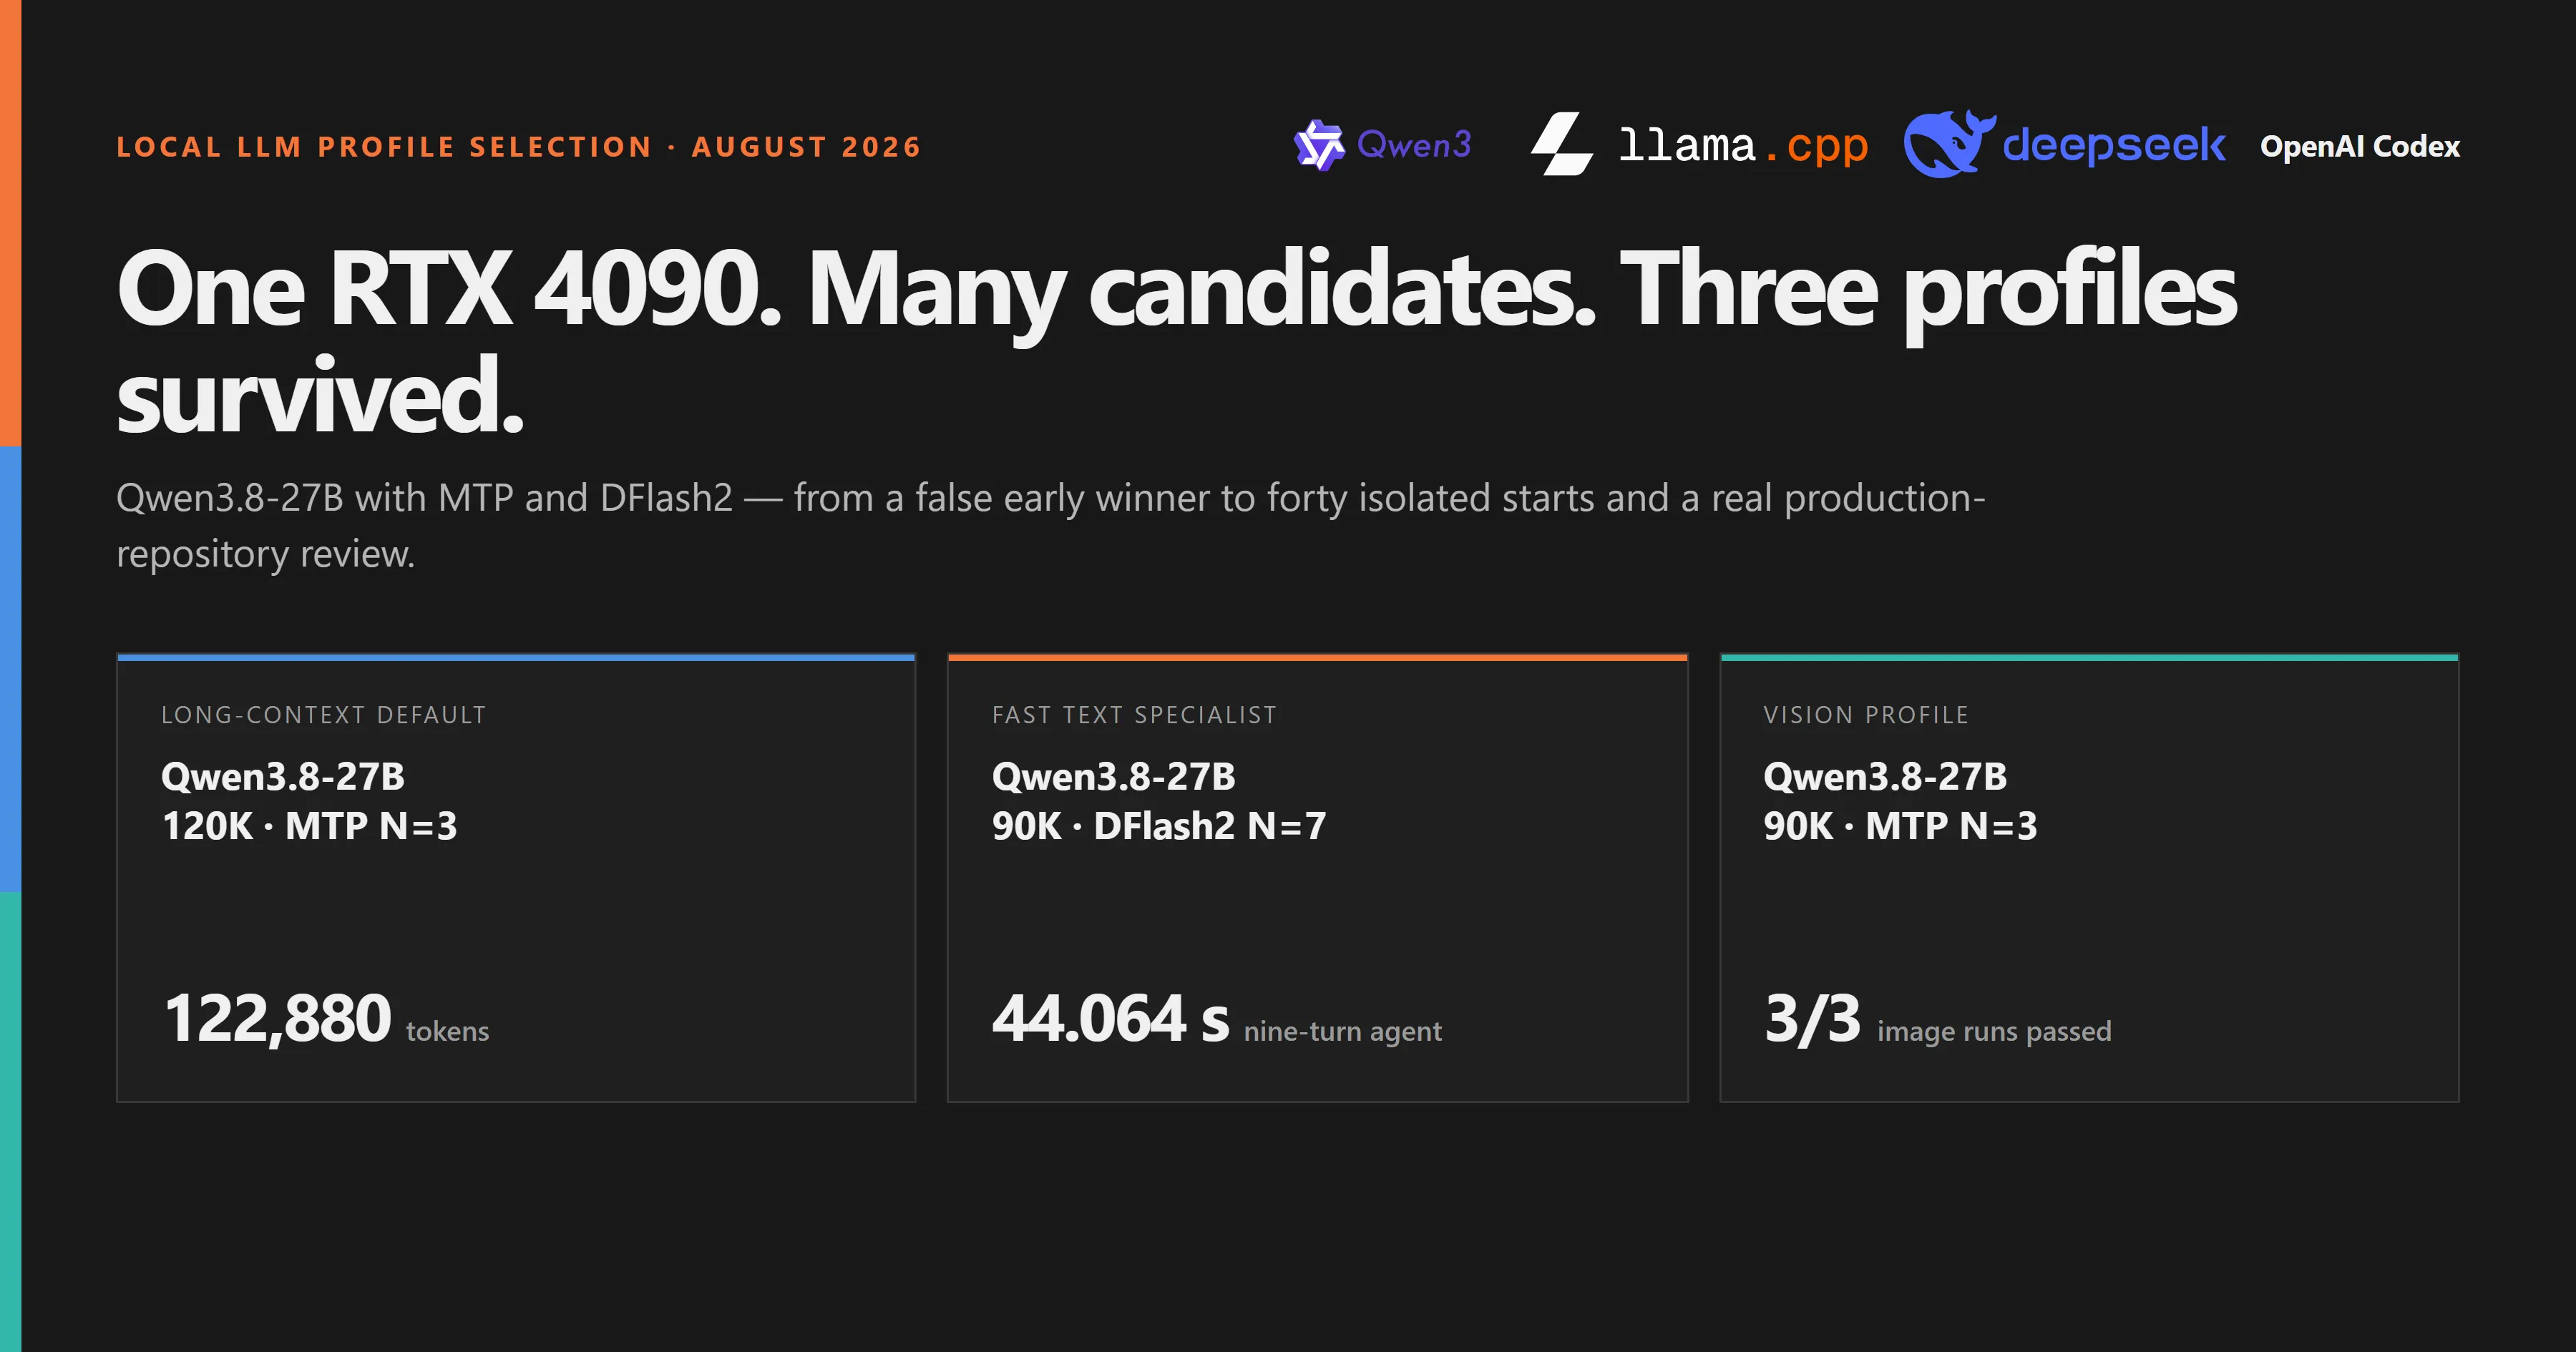
Von vielen Kandidaten zu drei Profilen: Qwen3.8-27B mit MTP und DFlash2
Auf einer RTX 4090 wurden MTP- und DFlash2-Profile schrittweise ausgesiebt. Das Ergebnis ist kein einzelner Sieger, sondern ein 120K-MTP-Standardprofil, ein schnelles 90K-DFlash2-Textprofil und ein verifiziertes 90K-MTP-Visionprofil.
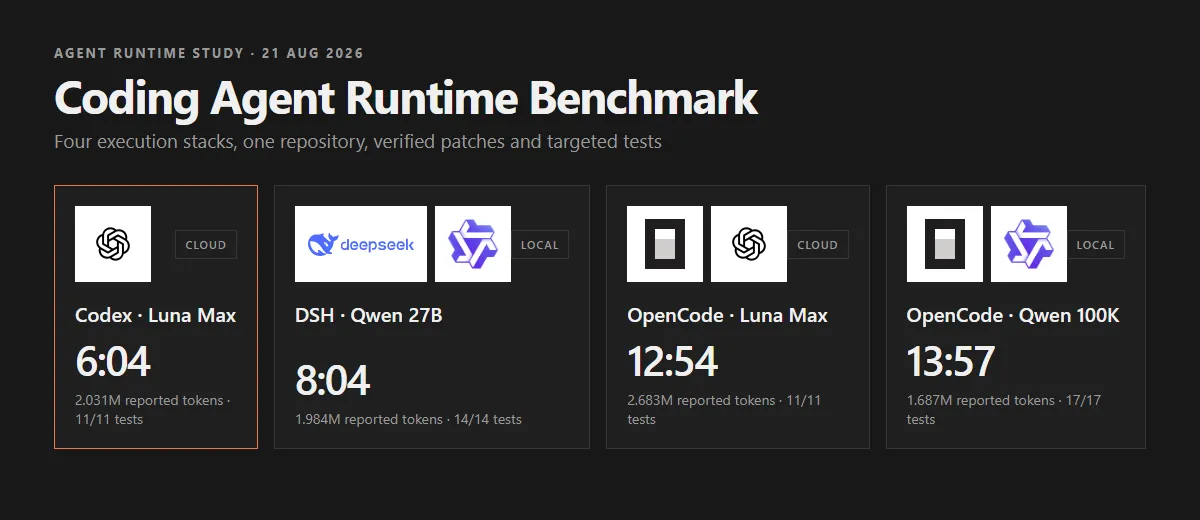
Coding-Agent-Benchmark: Wie stark das Runtime-System die Laufzeit verändert
Vier Coding-Agent-Läufe änderten dasselbe Repository und bestanden ihre Zieltests. Trotzdem reichte die Laufzeit von 6:04 bis 13:57 Minuten — Modell, Harness, Cache und Review wirkten gemeinsam.
Vier KI-Agenten im Praxistest: Token, Zeit und Qualität
Dasselbe KI-Modell, vier Agenten-Oberflächen, fünf reale Repository-Aufgaben: Was sich bei Qualität, Tokenvolumen, Laufzeit und Arbeitsweise tatsächlich unterschied.