 Cloud
Luna · DSH Standard Mode
11:45
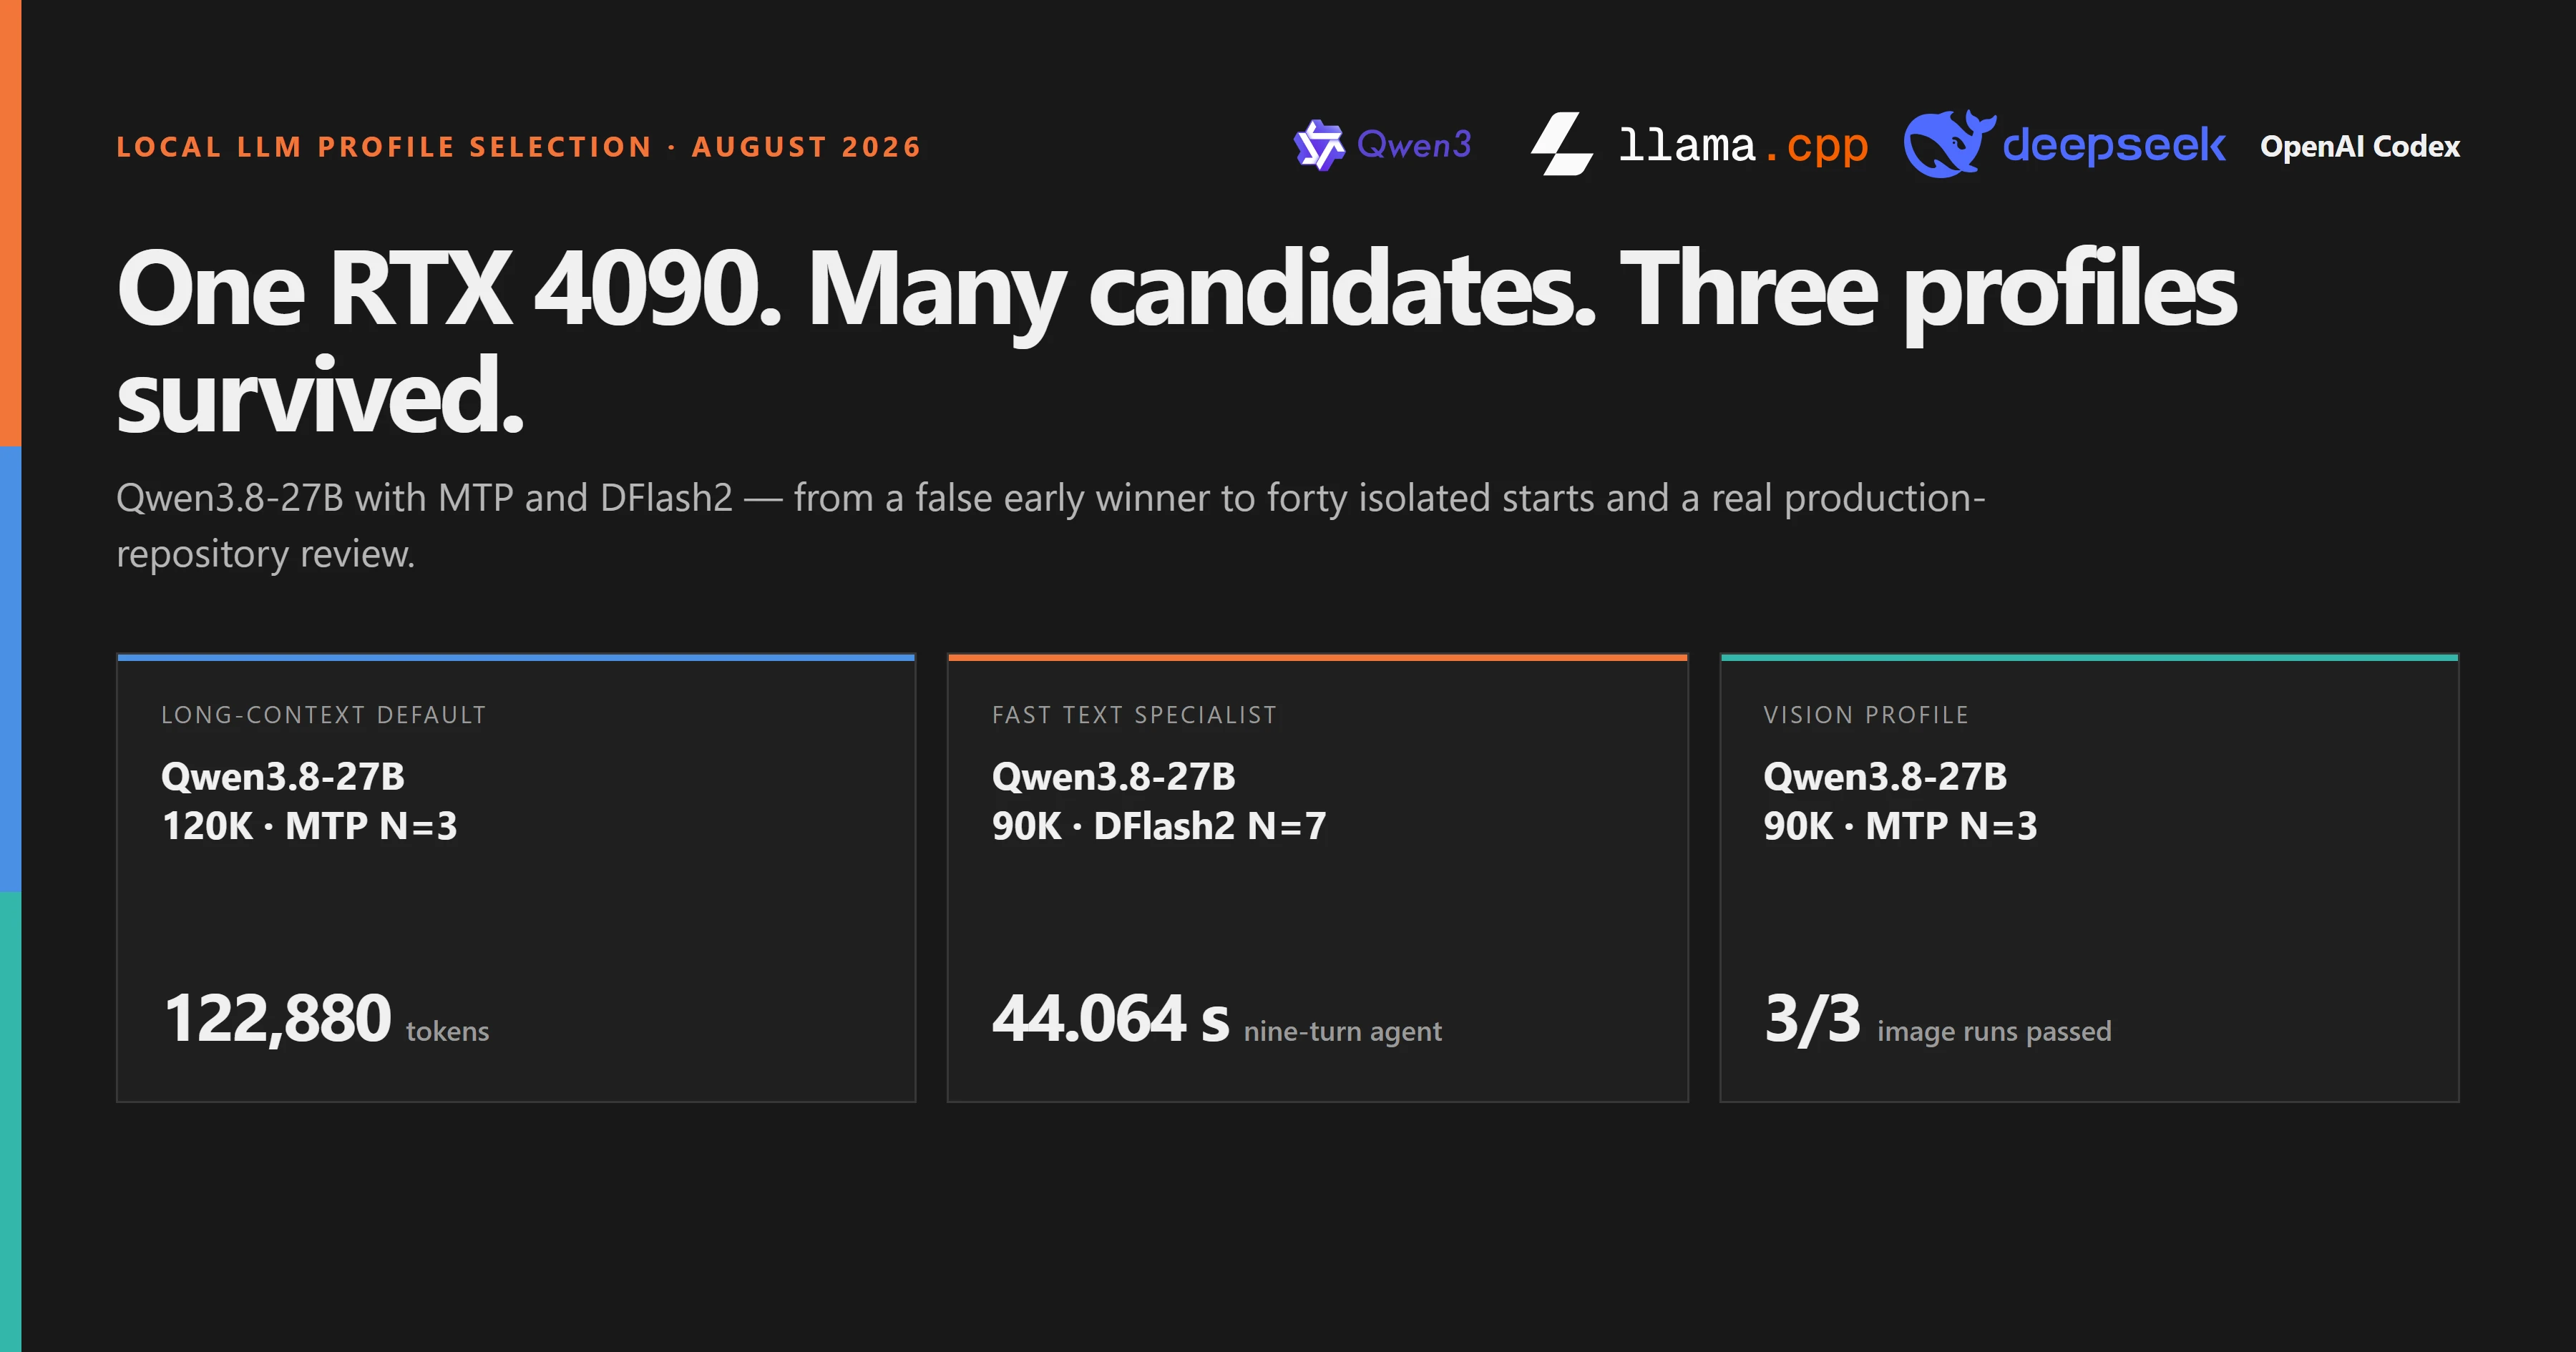
Auf einer RTX 4090 wurden MTP- und DFlash2-Profile schrittweise ausgesiebt. Das Ergebnis ist kein einzelner Sieger, sondern ein 120K-MTP-Standardprofil, ein schnelles 90K-DFlash2-Textprofil und ein verifiziertes 90K-MTP-Visionprofil.
Coding-Agent-Laufzeitbenchmark
Vier Bedingungen. Eine Aufgabe, ein Repository, eine Rubrik.
Gleiche Aufgabe · 99–100/100 Punkte · netto 11:45–54:48
Cloud11:45
Cloud13:48
 llama.cppLokal
19:57
llama.cppLokal54:48
Vier Bedingungen lösten dieselbe Aufgabe im selben Repository und erreichten alle 99 oder 100 von 100 Punkten. Die Netto-Aufgabendauer — Freigabe-Wartezeit und automatische Kontext-Kompaktierung sind aus jeder Messung herausgerechnet — reichte von 11:45 für den Cloud-Lauf über DSH-Standardmodus bis 54:48 für das lokale Modell ohne spekulative Dekodierung.
Coding-Agent-Laufzeitbenchmark
Vier Ausführungsstacks. Ein Repository.
4 Änderungen · alle Zieltests bestanden · 6:04–13:57
Cloud6:04
Lokal8:04
 Cloud
12:54
Lokal13:57
Vier Coding-Agent-Läufe änderten dasselbe Repository und bestanden ihre Zieltests. Trotzdem reichte die Laufzeit von 6:04 bis 13:57 Minuten — Modell, Harness, Cache und Review wirkten gemeinsam.
AI-Agent-Interface-Benchmark
Ein Modell. Vier Interfaces.
5 Aufgaben · 20 frische Läufe · 12/12 Qualitätsprüfungen
Dasselbe KI-Modell, vier Agenten-Oberflächen, fünf reale Repository-Aufgaben: Was sich bei Qualität, Tokenvolumen, Laufzeit und Arbeitsweise tatsächlich unterschied.
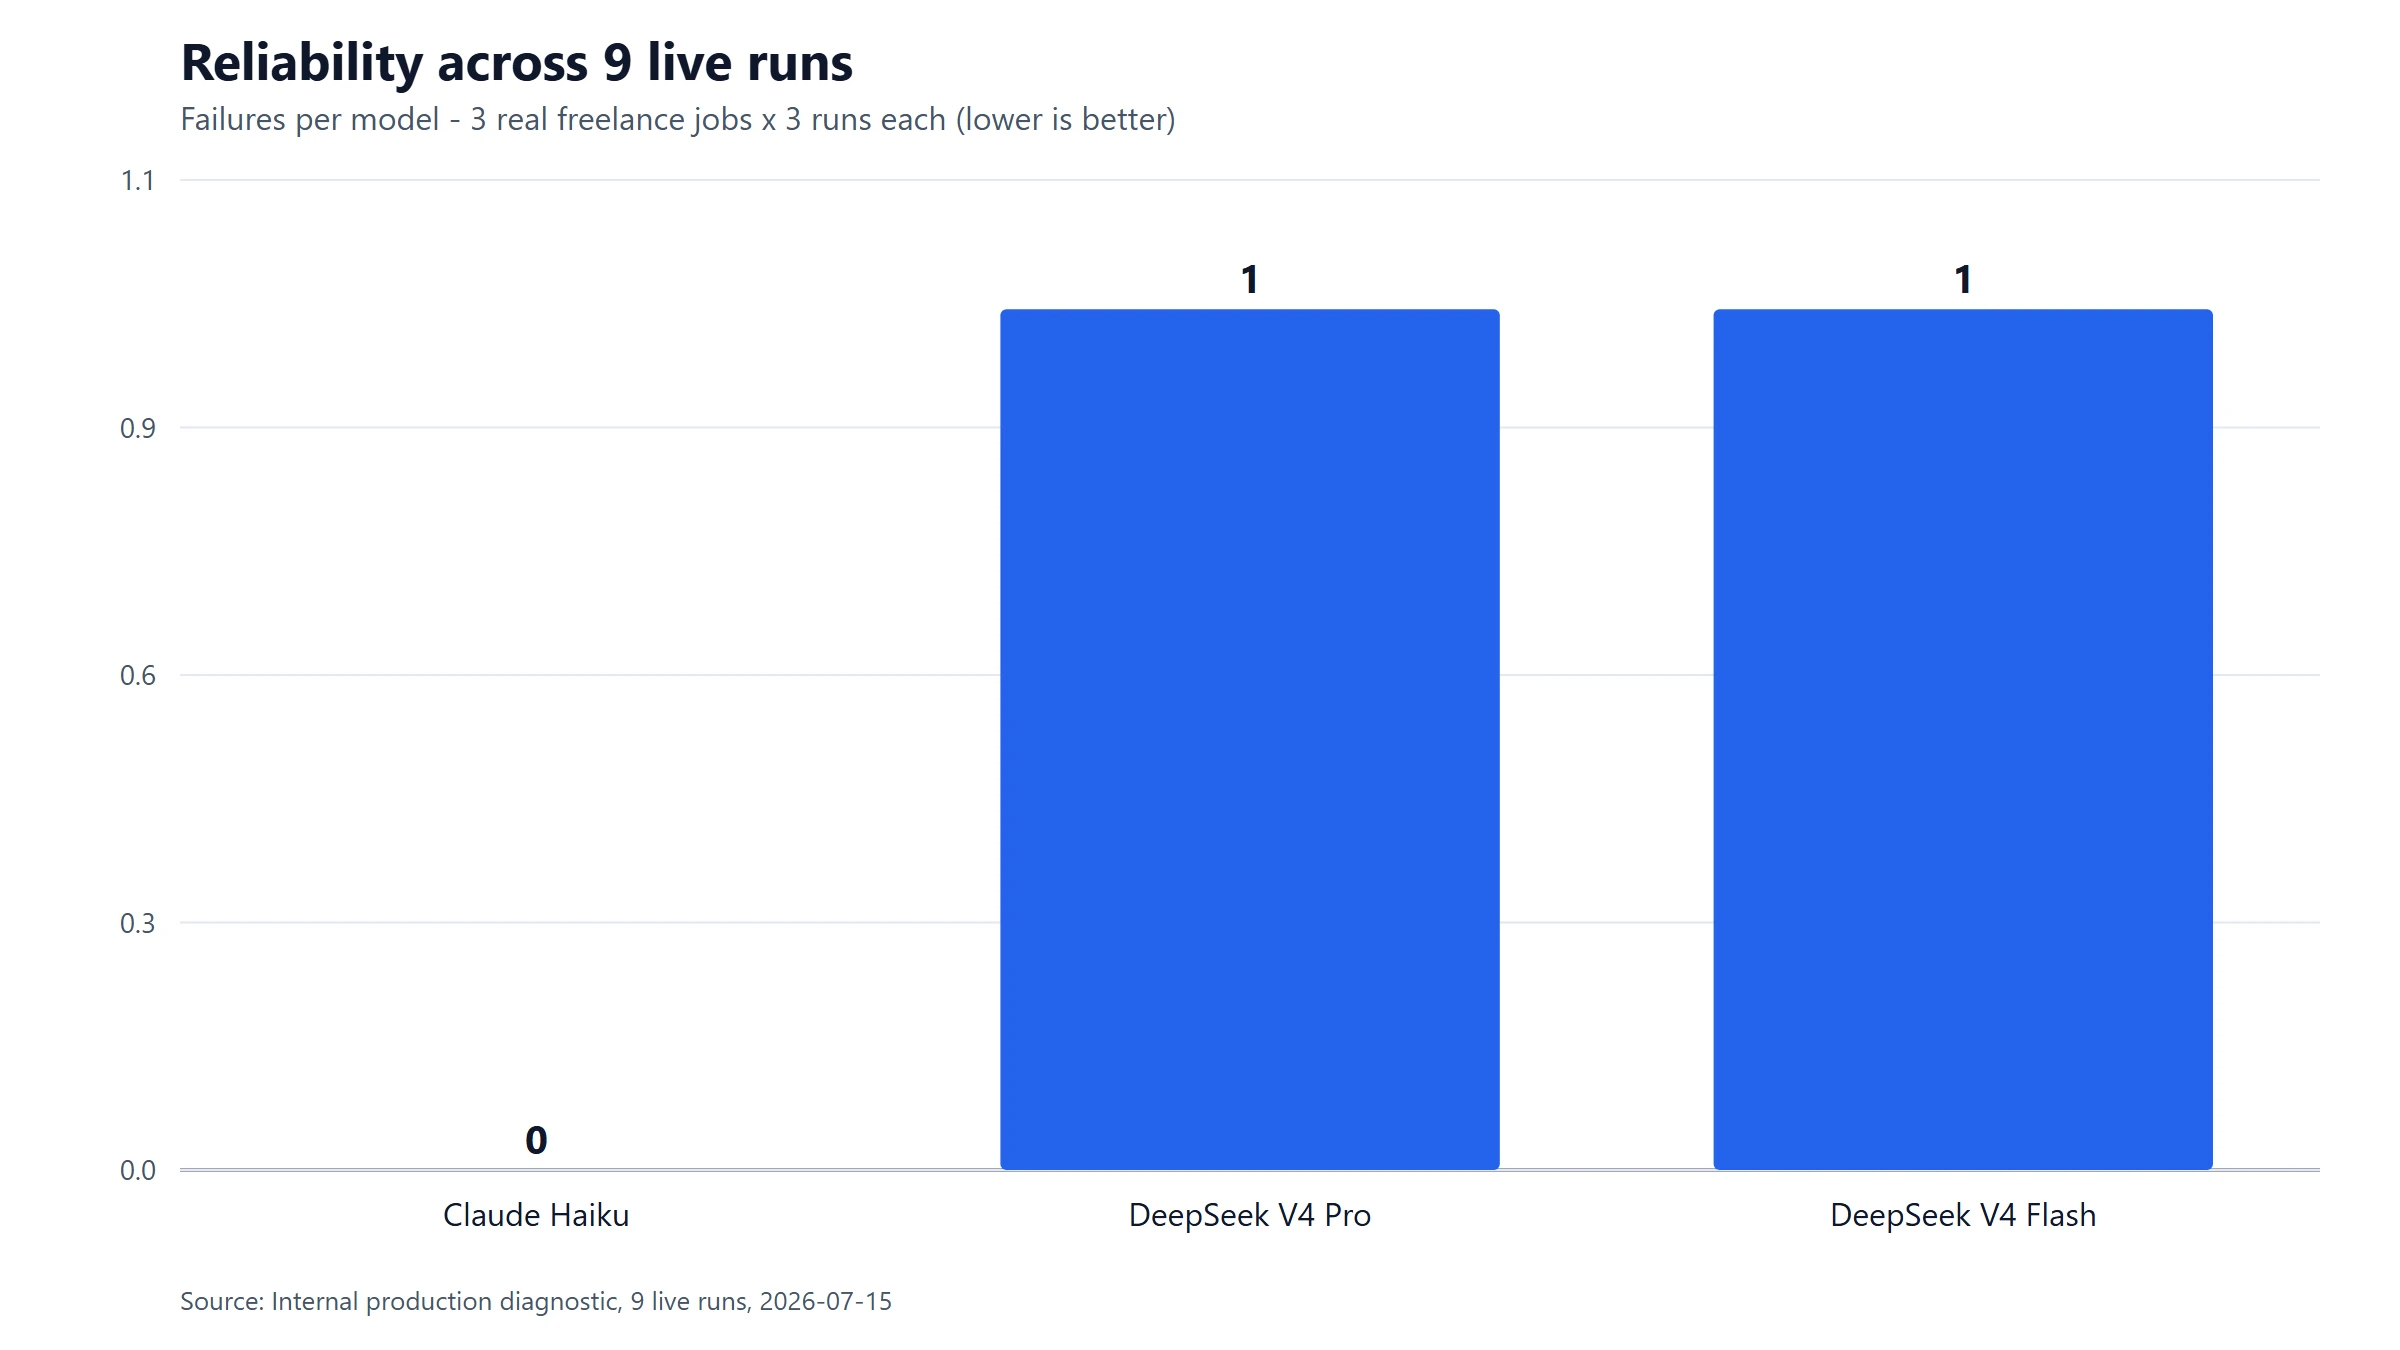
Ich habe Claude Haiku gegen DeepSeek V4 Pro und Flash in meiner eigenen KI-Pipeline für Projektangebote getestet – anhand drei echter Freelance-Aufträge.