 Cloud
Codex · Luna Max
6:04
Coding-Agent-Laufzeitbenchmark
Vier Ausführungsstacks. Ein Repository.
4 Änderungen · alle Zieltests bestanden · 6:04–13:57
Cloud6:04
 Lokal
8:04
 Cloud
12:54
Lokal13:57
Erfasst: 2026-08-21T12:39:07+02:00
Betriebssystem
Windows 11 Pro
CPU
AMD Ryzen 9 7950X
Kerne
16C/32T
RAM
128 GB
GPU / VRAM
NVIDIA GeForce RTX 4090 / 24 GB
GPU-Treiber
610.88
| Lauf | Runtime | Modell | Format / Quantisierung | Kontext / KV-Cache | Backend |
|---|---|---|---|---|---|
| Codex · Luna Max (Cloud) | Codex CLI 0.148.0-alpha.21 | gpt-5.6-luna (GPT-5.6 Luna Max) | vom Anbieter nicht offengelegt | 258400 tokens / vom Anbieter nicht offengelegt | vom Anbieter nicht offengelegt |
| DSH · Qwen 3.8 27B (Lokal) | DeepSeek Harness (dsh) 0.1.0-rc.8 | Qwen3.8-27B-Q4-100K-Q8 (Qwen 3.8 27B Q4 (100K Q8 KV)) | GGUF / Q4 | 100K (102400 tokens) / Q8 | llama.cpp |
| OpenCode · Luna Max (Cloud) | OpenCode 1.18.19 | GPT-5.6 Luna | vom Anbieter nicht offengelegt | vom Anbieter nicht offengelegt / vom Anbieter nicht offengelegt | vom Anbieter nicht offengelegt |
| OpenCode · Qwen 100K (Lokal) | OpenCode 1.18.19 | Qwen3.8-27B Q4 (100K Q8 KV) | GGUF / Q4 | 100K / Q8 | llama.cpp |
Die Hardware wurde nach Abschluss der Läufe auf derselben Maschine erneut überprüft. Die Werte pro Lauf stammen aus den aufbewahrten Sitzungsexporten; nicht erfasste Werte wurden entsprechend markiert statt geschätzt.
Gewichts-Quantisierung (Q4) und KV-Cache-Quantisierung (Q8) sind bei den Qwen-Läufen bewusst getrennt ausgewiesen.
Vier unterschiedliche Änderungen · alle Zieltests bestanden
Gemessen wurde der gesamte Ausführungsstack
Das Modell ist nur ein Eingangswert für Laufzeit und Tokenvolumen.
Systemprompt, Skills, Memory und Planungsregeln
Frische Eingabe, Cache-Lesen, Kompaktierung und Fortsetzung
Repository-Lesen, Änderungen, Befehle und Tests
Nutzerantworten, Reviewer und Verifikationsregeln
Patch-Umfang, Zieltests und Abschlussbericht
Sekunden · weniger ist besser
Millionen Tokens · kein direkter Geschwindigkeitswert
Direktes Harness = 1,00 · weniger ist besser
Codex ohne vergleichbare Exportzähler ausgelassen
Prozent · frische Eingabe gegenüber Cache-Lesen
Sekunden · Review gegenüber übriger gemessener Zeit
Tausend Tokens · Output plus separat gemeldetes Reasoning
| Runtime | Ausgewählte Änderung | Dateien | Tests | Ergebnis |
|---|---|---|---|---|
| Codex · Luna Max | ValueError-Kompatibilität plus Schutz für Nicht-Objekt-Flashcards | 2 | 11 | 11/11 |
| DSH · Qwen 27B | Atomisches RunKeyStore-Speichern mit temporärer Datei und os.replace | 2 | 14 | 14/14 |
| OpenCode · Luna Max | FlashcardValidationError erbt von ValueError | 3 | 11 | 11/11 |
| OpenCode · Qwen 100K | OCR-Leerraumkorrektur für die Garbage-Ratio | 2 | 17 | 17/17 |
Vier Coding-Agent-Sitzungen erhielten dasselbe Repository und dieselbe übergeordnete Aufgabe. Jede Sitzung lieferte eine Änderung und bestand ihre gezielt ausgeführten Tests. Die beobachtete Gesamtdauer lag trotzdem zwischen 6:04 und 13:57 Minuten.
Codex mit Luna Max war der kürzeste beobachtete Lauf. DSH mit Qwen 3.8 27B war der kürzeste lokale Lauf. Beide OpenCode-Konfigurationen benötigten mehr Zeit, obwohl OpenCode Qwen das niedrigste gemeldete Gesamt-Tokenvolumen hatte.
Die zentrale Erkenntnis ist deshalb keine allgemeine Modellrangliste. Ein Coding-Agent besteht aus mehr als dem Modell: Systemanweisungen, Skills, Memory, Kontextverwaltung, Cache, Werkzeuge, Nutzereingriffe, Review-Regeln und Tests wirken gemeinsam auf das sichtbare Ergebnis.
Die vier Sitzungen starteten mit demselben Repository und derselben abstrakten Aufgabe, mussten aber nicht denselben konkreten Defekt auswählen. Die Luna-Läufe landeten im selben Flashcard-Bereich, wählten jedoch einen unterschiedlichen Patch-Umfang. Die beiden Qwen-Läufe bearbeiteten andere Fehlerbereiche.
Damit vergleicht der Test vollständige Runtime-Profile, nicht vier Modelle unter einer kontrollierten Same-Patch-Bedingung. Diese Unterscheidung ist wichtig: Eine Sitzung kann wegen langsamer Modellgenerierung, zusätzlicher Tool-Arbeit, Review, Kontextkompaktierung oder Wartezeiten länger dauern.
OpenCode Luna benötigte 2,13-mal so lange wie Codex Luna. OpenCode Qwen benötigte 1,73-mal so lange wie DSH Qwen. Gleichzeitig war OpenCode Qwen trotz des kleinsten Gesamt-Tokenvolumens der längste Lauf. Ein niedriger Tokenwert ist daher weder automatisch ein Geschwindigkeits- noch ein Qualitätswert.
Auch die Tokenfelder sind nicht identisch. Codex führt Reasoning als Teil des Outputs. OpenCode trennt Reasoning und kombiniert frische Eingabe mit Cache-Lesen im Promptvolumen. DSH liefert Prompt- und Output-Summen. Die normalisierten Werte beschreiben Arbeitsvolumen, nicht unmittelbar Rechnung, Energiebedarf oder Abonnementlimit.
In beiden OpenCode-Läufen stammten mehr als 91 Prozent des Promptvolumens aus Cache-Lesevorgängen. OpenCode Luna meldete 220.630 frische Input-Tokens und 2.451.456 Cache-Tokens; OpenCode Qwen 145.146 beziehungsweise 1.514.973.
DSH Qwen nutzte 36 Assistentenrunden und 57 Tool-Aufrufe. OpenCode Luna nutzte 32 Runden und 67 Aufrufe, OpenCode Qwen 31 Runden und 39 Aufrufe. Für Codex standen keine direkt vergleichbaren Exportzähler zur Verfügung; deshalb wird Codex in dieser Teilgrafik nicht fälschlich mit null dargestellt.
OpenCode Luna aktivierte Brainstorming, Planerstellung, testgetriebene Entwicklung, Code-Review und Abschlussverifikation. Allein der Reviewer beanspruchte ungefähr 299 Sekunden, also 38,6 Prozent der Gesamtdauer. Dieser Prozess kann bei großen oder riskanten Änderungen wertvoll sein. Bei einem kleinen Fix wurde sein fixer Aufwand jedoch zu einem bedeutenden Teil der Sitzung.
Codex Luna verwendete Karpathy-Guidelines und vorhandenes Working Memory. Diese Eingaben könnten einen kleinen Patch, explizite Annahmen und direkte Verifikation gefördert haben. Ein einzelner Lauf kann ihren isolierten Effekt jedoch nicht messen. Dafür wäre ein eigener Skills-an/Skills-aus-Versuchsarm erforderlich.
Jede Bedingung lief nur einmal; es gibt keine Varianz oder Konfidenzintervalle. Die Agenten implementierten nicht denselben Patch, die Tokenexporte verwenden unterschiedliche Semantik, und Qwen lief lokal, während Luna Cloud-Infrastruktur nutzte. Auch Testanzahlen sind wegen unterschiedlicher Patch-Umfänge kein Qualitätsranking.
Ein stärkerer Folgetest sollte einen einzigen Defekt, dieselben Akzeptanzkriterien, identische Tools, gleiche Systemanweisungen sowie gleiche Kontext- und Timeout-Grenzen verwenden. Jede Bedingung sollte mindestens dreimal laufen. Für Qwen müssen Hardware, Quantisierung, Kontextlimit, KV-Cache-Format und Generationsdurchsatz dokumentiert werden. Pro-Schritt-Zeitstempel würden Modelllatenz, Toolzeit und Review erstmals sauber trennen.
Die Messwerte wurden aus vier aufbewahrten Sitzungsexporten rekonstruiert: `lunamax-session.jsonl`, `session.jsonl`, `session-ses_fdda.md` und `session-ses_fdd8.md`.
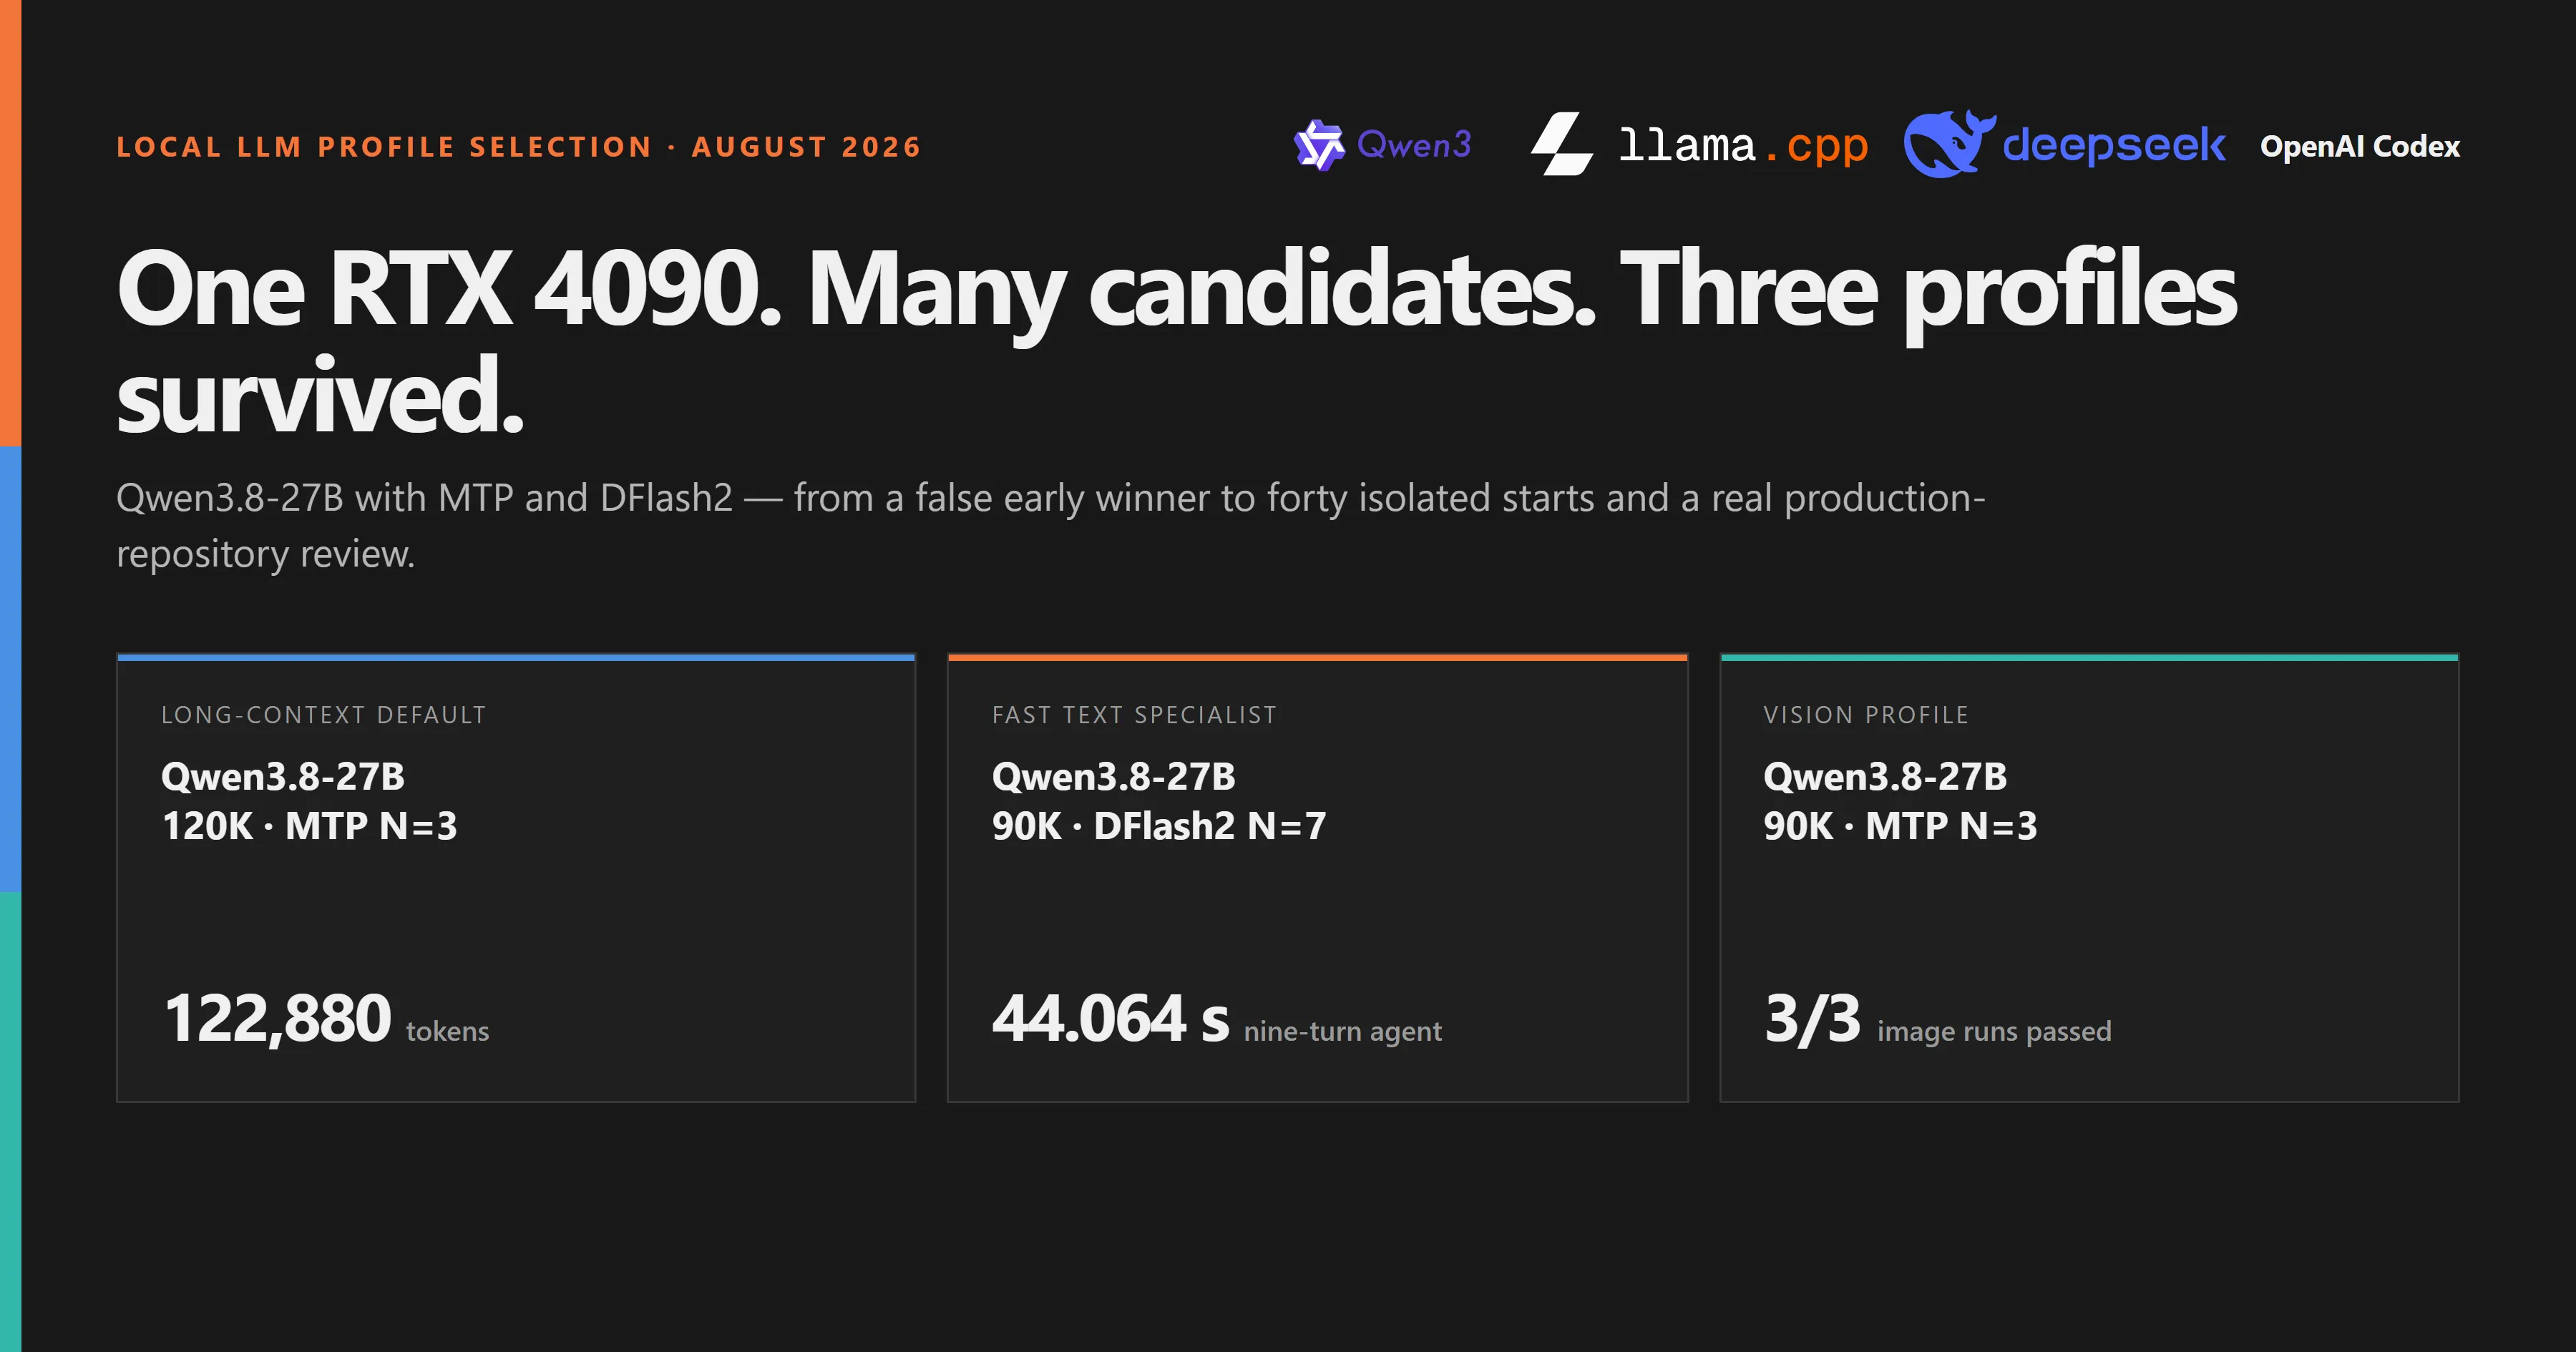
Von vielen Kandidaten zu drei Profilen: Qwen3.8-27B mit MTP und DFlash2
Auf einer RTX 4090 wurden MTP- und DFlash2-Profile schrittweise ausgesiebt. Das Ergebnis ist kein einzelner Sieger, sondern ein 120K-MTP-Standardprofil, ein schnelles 90K-DFlash2-Textprofil und ein verifiziertes 90K-MTP-Visionprofil.
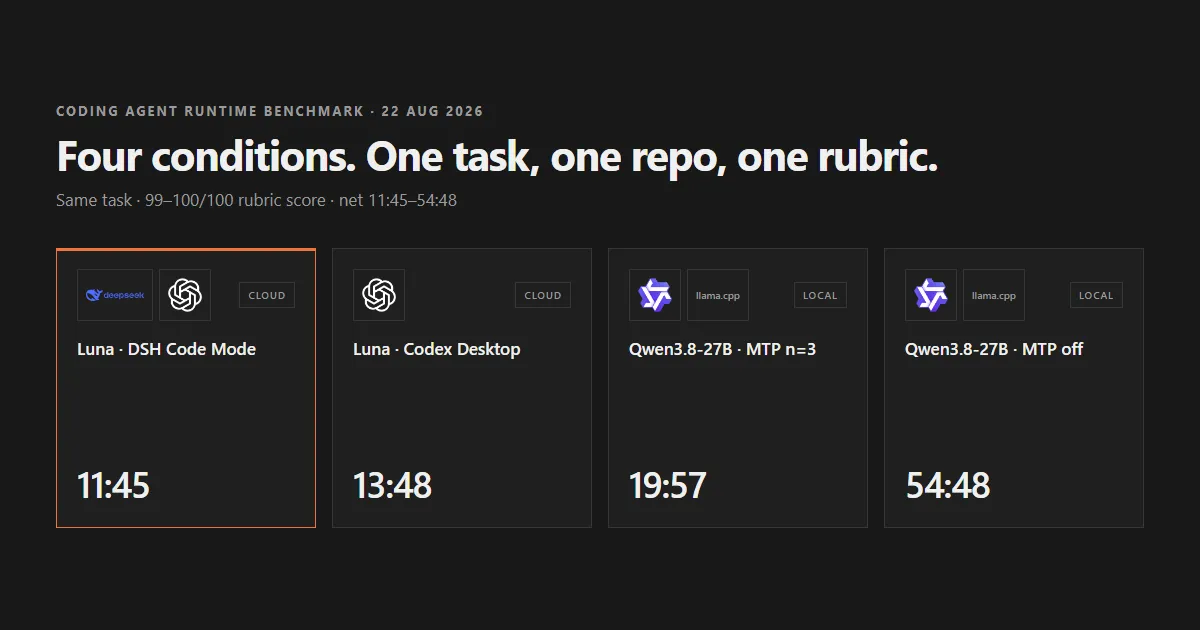
Vier Bedingungen, eine Aufgabe: Was spekulative Dekodierung und die Wahl des Agenten-Tools wirklich kosten
Vier Bedingungen lösten dieselbe Aufgabe im selben Repository und erreichten alle 99 oder 100 von 100 Punkten. Die Netto-Aufgabendauer — Freigabe-Wartezeit und automatische Kontext-Kompaktierung sind aus jeder Messung herausgerechnet — reichte von 11:45 für den Cloud-Lauf über DSH-Standardmodus bis 54:48 für das lokale Modell ohne spekulative Dekodierung.
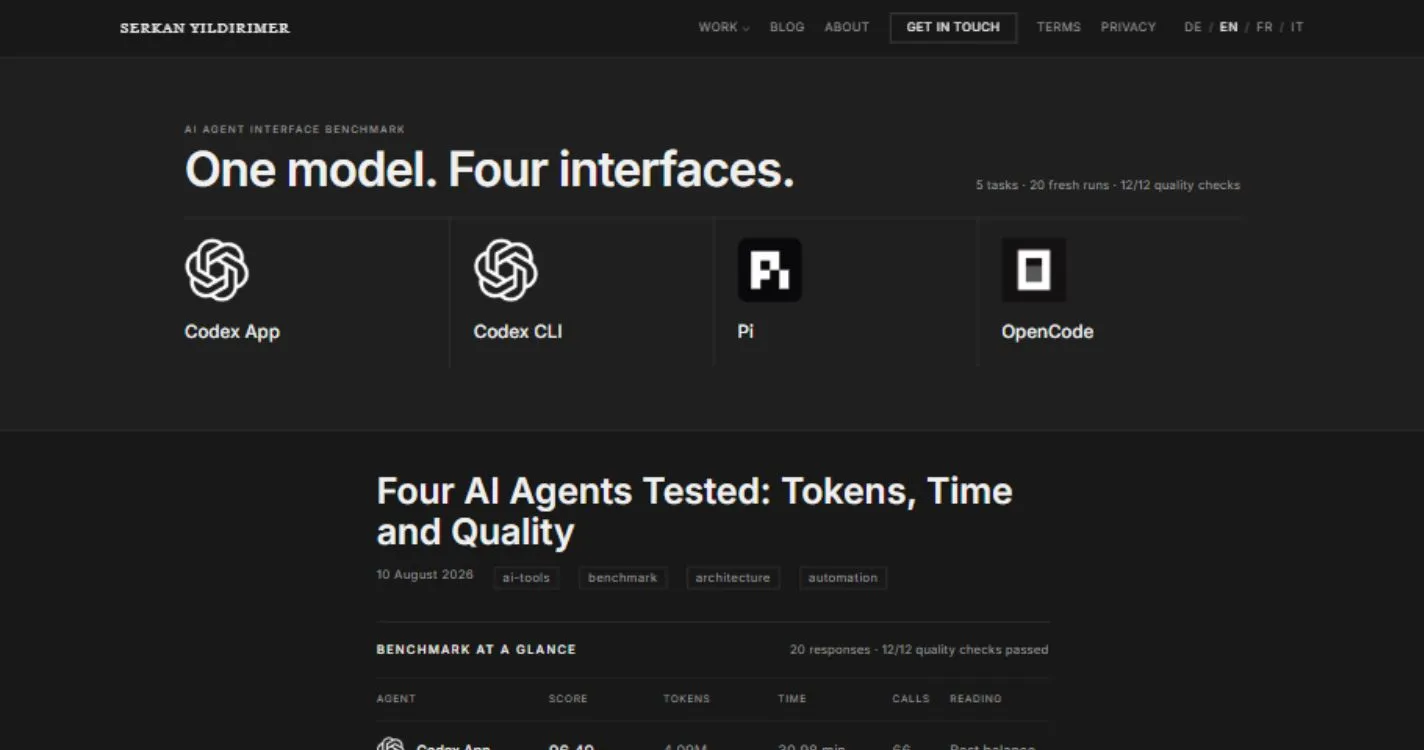
Vier KI-Agenten im Praxistest: Token, Zeit und Qualität
Dasselbe KI-Modell, vier Agenten-Oberflächen, fünf reale Repository-Aufgaben: Was sich bei Qualität, Tokenvolumen, Laufzeit und Arbeitsweise tatsächlich unterschied.